 hemisus

논문 정보
- 제목: AST: Audio Spectrogram Transformer
- arXiv: 2104.01778
Introduction
AST(Audio Spectrogram Transformer)는 기존의 CNN-attention과 같은 hybrid model과 달리 CNN으로의 의존성 없이 purely attention-based인 모델이다.
ViT(Vision Transformer)와 유사하게 Convolution layer없이 Spectrogram을 처리하며, 사전학습된 ViT를 AST로 transfer도 가능하다.
AST의 장점은 크게 3가지로 소개된다:
-
뛰어난 성능: AudioSet, ESC-50과 같은 데이터셋에서 기존 SOTA모델보다 뛰어난 성능을 보임.
-
AST는 가변적인 길이의 데이터를 입력받을 수 있으며, 구조의 변화 없이 다양한 task에 쉽게 적용 가능.
-
기존 SOTA CNN모델들과 비교했을때 더 단순한 아키텍처, 적은 파라미터 수를 가지며 학습 시 더 빠르게 수렴.
Model Architecture
AST는 이름처럼 waveform대신 spectrogram을 input으로 사용한다.
먼저 t초의 waveform에 25ms Hamming window를 10ms 간격(hop size)으로 적용하여 각 프레임으로 분할한다.
Hamming window란?
오디오를 프레임 단위로 잘라서 FFT를 하면, 각 프레임의 양 끝이 뚝 잘리면서 원래 신호에 없던 성분이 생긴다. 이를 방지하기 위해 프레임에 window function를 곱해주는데, Hamming window는 그중 하나이다.
프레임의 중간은 값이 1에 가깝고 양쪽 끝으로 갈수록 0에 가까워지는 종 모양 곡선이므로, 이걸 곱하면 프레임 경계가 자연스럽게 fade out되어 잘림으로 인한 노이즈가 줄어든다.
또한 이러한 25ms의 window가 10ms씩 이동하며 생기므로 이웃한 프레임끼리 15ms씩 겹치게 된다. 이를 통해 1초당 약 100개의 프레임이 생성된다.
생성된 각 프레임에 대해 FFT를 수행한 뒤 Mel scale로 배치된 128개의 필터를 적용하고 로그를 취하면, 프레임당 128차원의 log Mel filterbank 벡터가 만들어진다. Mel scale은 사람의 청각 특성을 반영하여 저주파 쪽은 촘촘하게, 고주파 쪽은 듬성듬성 배치하는 주파수 스케일이다.
결과적으로 주파수 축 128 × 시간 축 100t 크기의 2D 스펙트로그램이 만들어지고, 이를 이미지처럼 취급하여 AST의 입력으로 사용한다.
이후 해당 2D spectrogram을 $N$개의 $16 \times 16$ 크기의 패치로 나누는데, 시간 축과 주파수 축 모두 6만큼 겹치도록(overlap) 분할한다. 이때 $N = 12 \times \lceil (100t - 16) / 10 \rceil$ 이며, 이 $N$이 곧 Transformer에 입력되는 시퀀스의 길이가 된다.
각 $16 \times 16$ 패치를 flatten한 뒤 선형 변환을 통해 768차원의 1D 임베딩으로 변환한다. 이때 사용되는 선형 변환 레이어를 Patch Embedding Layer라고 부른다.
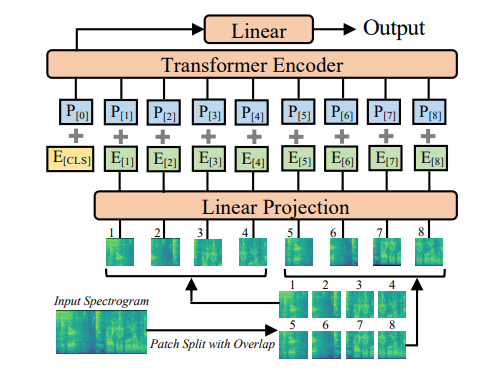
AST는 ViT와 아키텍처가 매우 유사하다. Patch Embedding에 학습 가능한(learnable) Positional Embedding(768차원)을 더하여 각 패치의 2D 공간 정보를 인코딩한다. Transformer 자체는 입력 순서 정보를 갖고 있지 않고, 패치 또한 시간 순서대로 나열되지 않기 때문에 이 Positional Embedding이 필수적이다.
또한 시퀀스의 맨 앞에 [CLS] 토큰을 추가하며, Transformer Encoder를 거친 뒤 [CLS] 토큰의 출력이 해당 스펙트로그램의 최종 representation이 된다. 이 representation을 sigmoid 활성화 함수가 있는 Linear Layer에 통과시켜 최종 분류를 수행한다.
AST는 분류 task를 위해 설계되었기 때문에 Transformer의 Encoder만 사용하며, 별도의 구조 수정 없이 표준 Transformer Encoder를 사용한다. 구체적으로 ViT-Base와 동일한 설정(임베딩 차원 768, 12 layers, 12 heads)을 사용하는데, 이는 ImageNet pretrained ViT의 가중치를 그대로 전이하기 위함이다.
ImageNet Pretraining
ViT 논문에서 언급되었듯이, Transformer 구조가 CNN-based 모델보다 좋은 성능을 보이려면 더 많은 데이터(약 14 million 이상)가 필요하다. 하지만 오디오 데이터셋은 이만한 규모를 확보하기 어렵기 때문에, 이미지와 스펙트로그램의 유사한 형식을 활용한 cross-modality 전이학습이 필요하게 된다. 실제로 CNN-based 모델에서도 ImageNet으로 학습된 CNN 가중치를 초기값으로 사용하고 오디오 데이터로 fine-tuning하는 방식이 이전부터 쓰여 왔다.
다만 ViT와 AST가 매우 유사한 구조를 가졌더라도 완전히 동일하지 않으므로 몇가지 처리가 필요하다.
1. ViT는 RGB 3채널 입력을 받지만, AST는 single-channel 스펙트로그램을 입력으로 받는다.
따라서 ViT의 Patch Embedding Layer의 3채널 가중치를 평균하여 AST의 single-channel Patch Embedding 가중치로 사용한다. 이는 스펙트로그램을 3채널로 복제하여 입력하는 것과 스케일링 상수를 제외하면 동일하며(Layer Normalization에 의해 흡수됨), 연산 효율이 더 높다.
또한 학습 전에 입력 스펙트로그램을 데이터셋 전체 기준으로 평균 0, 표준편차 0.5로 정규화하여, pretrained ViT 가중치가 기대하는 입력 분포와 유사하게 맞춰준다.
2. 가변적인 길이의 input 처리
Transformer 구조 자체는 시퀀스 길이에 제한이 없으나, ViT가 학습한 Positional Embedding은 고정된 개수(예: $24 \times 24 = 576$개)이므로 입력 크기가 달라지면 그대로 사용할 수 없다. AST는 이 문제를 cut & bilinear interpolation으로 해결한다.
예를 들어, $384 \times 384$ 이미지를 $16 \times 16$ 패치로 나눈 ViT의 Positional Embedding은 $24 \times 24$ 형태이다. 반면 10초 오디오의 AST 패치는 $12 \times 100$ 형태이므로, ViT의 $24 \times 24$ Positional Embedding에서 주파수 축(첫 번째 차원)은 24에서 12로 잘라내고(cut), 시간 축(두 번째 차원)은 24에서 100으로 보간(bilinear interpolation)하여 $12 \times 100$ 크기로 변환한다. [CLS] 토큰의 Positional Embedding은 그대로 재사용한다.
ViT의 Positional Embedding 텐서는 (24×24,768), 다시 말해 576개의 768차원 벡터이다. 이걸 2D로 reshape하면 (24,24,768).
이를 통해 입력 크기가 다르더라도 ViT가 ImageNet 학습 과정에서 획득한 2D 공간 정보를 AST에 전이할 수 있다.
3. Classification Layer
분류 task 자체는 ViT와 완전히 다르기 때문에, ViT의 마지막 classification layer는 버리고 새로 초기화하여 학습시킨다. 이러한 adaptation 덕분에 AST는 다양한 pretrained ViT 가중치를 초기값으로 활용하면서도 오디오 분류 task를 수행할 수 있다.
해당 논문에서는 DeiT(Data-efficient Image Transformer)의 사전학습 가중치를 사용하였다. DeiT는 CNN knowledge distillation으로 학습되었으며, $384 \times 384$ 이미지 기반, 87M 파라미터, ImageNet 2012에서 85.2% top-1 accuracy를 달성한 모델이다. DeiT는 학습 시 [CLS] 토큰을 두 개 사용하는데, AST에서는 이 둘의 평균을 하나의 [CLS] 토큰으로 사용한다.
Experiments 요약
AudioSet
- AST는 single model, ensemble 모두에서 기존 CNN-attention hybrid 모델(PSLA)을 능가했다.
- 동일한 training pipeline을 사용했으므로 성능 차이는 아키텍처의 차이에서 비롯된다.
- AST는 5 epoch만에 학습이 수렴하는 반면, CNN-attention hybrid 모델은 30 epoch이 필요했다.
Ablation Study
- ImageNet Pretraining: 없으면 성능이 크게 하락하며, 특히 데이터가 적을수록 pretraining의 효과가 더 크다.
- Positional Embedding 전이: 랜덤 초기화보다 cut & interpolation 방식이 확실히 우수하다. 이는 ViT의 2D 공간 정보 전이가 실제로 효과가 있음을 보여준다.
- Patch Overlap: overlap이 클수록 성능이 좋아지지만, 시퀀스 길이가 늘어나 연산량이 제곱으로 증가하는 trade-off가 있다. overlap 없이도 기존 SOTA를 능가한다.
- Patch 크기/모양: 32x32보다 16x16이 더 좋고, $128 \times 2$ 직사각형 패치가 $16 \times 16$ 정사각형보다 scratch 학습 시 성능이 좋지만, pretrained ViT가 $16 \times 16$ 기반이므로 전이학습을 고려하면 $16 \times 16$이 최적이다. (Section 3.1.3 Table 6)
ESC-50 & Speech Commands
- 입력 길이가 1초(Speech Commands), 5초(ESC-50), 10초(AudioSet)로 모두 다르고 내용도 speech/non-speech로 다르지만, 동일한 AST 아키텍처로 모든 벤치마크에서 SOTA를 달성했다.
- AST의 범용 오디오 분류기(generic audio classifier)로서의 가능성을 보여준다.
Conclusion
AST는 오디오 분류에서 CNN이 필수적이지 않음을 보여주었으며, 순수 attention 기반 모델만으로도 더 단순한 구조, 빠른 수렴, 그리고 SOTA 성능을 동시에 달성할 수 있음을 입증했다.