 hemisus

논문 정보
- 제목: BEATs: Audio Pre-Training with Acoustic Tokenizers
- arXiv: 2212.09058
Abstract
기존의 SOTA Audio SSL 모델들은 원본 스펙트로그램을 복원하는 Reconstruction Loss를 사용해 pre-training을 해왔다. Reconstruction Loss와 비교했을 때, Discrete Label Prediction(이산 레이블 예측) 방식은 SSL 모델이 고수준의 오디오 의미를 추상화하고, 인간의 인지 방식처럼 불필요한 저수준 디테일을 무시할 수 있도록 유도한다. 하지만 오디오 데이터는 연속적이고, speech와 달리 음소 단위 같은 자연스러운 이산 구분이 존재하지 않아, 범용 오디오를 잘 표현하는 label을 생성할 acoustic tokenizer를 만드는 것이 쉽지 않다.
이를 해결하기 위해 본 논문에서는 acoustic tokenizer와 audio SSL 모델을 반복적으로 상호 최적화하는 프레임워크인 BEATs(Bidirectional Encoder representation from Audio Transformers)를 제안한다. 처음에는 random projection을 tokenizer로 사용하여 SSL 모델을 mask-and-label-prediction 방식으로 학습시키고, 이후 반복에서는 이전에 학습된(또는 fine-tuned) SSL 모델을 teacher로 삼아 knowledge distillation을 통해 tokenizer를 개선한다. 이 과정을 반복함으로써 tokenizer와 SSL 모델이 서로의 품질을 끌어올리는 구조이다.
Introduction
Speech 데이터와 달리, 일반적인 Audio에는 목소리, 환경음, 음악 등 다양한 출처의 소리가 포함되어 범용적인 오디오 모델링이 어렵다. 이를 위해 SS-AST, Audio-MAE 같은 모델들이 일반 오디오 분류를 목표로 설계되었으며, SSL이 speech뿐 아니라 비음성 신호에서도 유용한 표현을 학습할 수 있음을 보여주었다.
하지만 이산 레이블 예측 방식을 사용하는 speech, vision, language 분야의 SSL모델과 달리, 범용 오디오 SSL 모델들은 여전히 Reconstruction Loss를 사용해 학습되어 왔다. 논문의 저자는 크게 세 가지 이유로 Discrete Label Prediction 방식이 더 적합하다고 주장한다.
1. 인간은 고수준의 의미(semantics)를 통해 소리를 이해한다.
사람은 개가 짖는 소리를 들을 때, 조용한 환경이든 비가 오는 환경이든 상관없이 “개가 짖는다”라는 패턴을 일관되게 인식한다. 배경 잡음이나 미세한 스펙트럼 차이 같은 저수준 디테일에 좌우되지 않고, 고수준의 의미적 특징을 추출, 분류하여 판단을 내리는 것이다. 이산 레이블 예측 방식은 이러한 semantic extracting & clustering 과정을 모사할 수 있으며, 이를 통해 Audio SSL 모델이 인간과 유사한 이해력과 일반화 능력(generalization)을 갖출 수 있을 것으로 기대한다. 반면 Reconstruction Loss는 마스킹된 원본 스펙트로그램을 복원하는 데 집중하므로 저수준 time-frequency 디테일에 민감해지게 된다.
2. 재구성 방식은 불필요한 정보를 예측하는 데 모델 용량이 낭비된다.
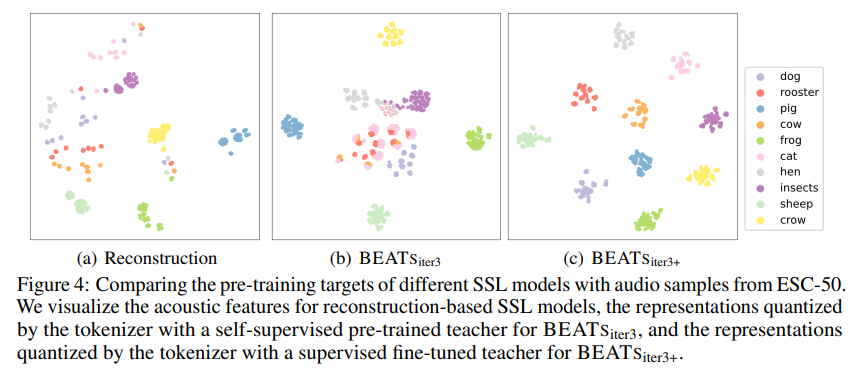
아래 그림은 논문 Section 4의 Figure 4로, 각 SSL 모델의 pre-training target을 ESC-50 오디오 샘플에 대해 T-SNE로 2차원 시각화한 것이다. Reconstruction 방식의 타겟은 동일한 오디오라도 잡음 조건이 달라지면 표현이 크게 흩어지며, 클래스별 의미 불변성(semantic invariance)이 약한 것을 볼 수 있다. 이처럼 Reconstruction Loss는 의미적으로 불필요한 정보까지 복원하는 데 모델 용량과 학습 자원이 소모된다. 반면 이산 레이블 예측 방식은 이러한 불필요한 디테일을 버리고, semantic-rich token을 예측 타겟으로 삼아 더 적은 비용으로도 고수준의 오디오 이해 능력을 학습할 수 있다.
3. Modality 간 사전학습 방식의 통합이 쉬워진다.
Language, vision, speech 분야에서는 이미 discrete label prediction이 주류이기 때문에, 오디오 또한 이 방식을 채택하면 모달리티별로 사전학습 방식을 따로 설계할 필요 없이, 하나의 패러다임으로 학습·전이·적용이 가능해진다.
이러한 장점에도 불구하고, 연속적이고 매우 다양한 형태의 소리를 포함하는 오디오를 NLP처럼 의미가 집약된 discrete token으로 표현하는 것은 여전히 어려운 과제였다. BEATs는 이 문제를 acoustic tokenizer와 SSL 모델의 반복적 상호 최적화를 통해 해결하며, 이에 대한 구체적인 방법은 다음 절에서 다룬다.
BEATs
Iterative Audio Pre-Training
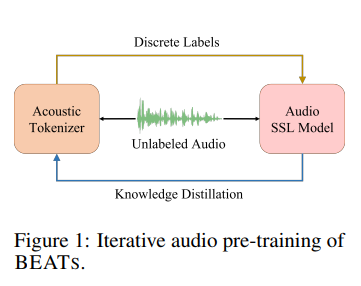
위의 사진이 BEATs의 전체적인 파이프라인을 보여준다. Unlabeled Audio가 주어졌을 때, acoustic tokenizer가 먼저 이산 레이블을 생성하고, 이를 마스킹과 이산 레이블 예측을 통해 SSL 모델을 학습시킨다. 이후 학습된 SSL 모델을 다시 teacher로써 acoustic tokenizer를 지식 증류 방식으로 학습시키고, 이 과정을 반복하여 두 모델을 학습시킨다.
구체적으로, 오디오 클립이 주어지면 먼저 raw waveform으로부터 acoustic feature(=128차원 Mel-filterbank feature, 즉 mel-spectrogram)를 추출하고, 이를 16×16 크기의 patch들로 나눈 뒤 flatten하여 patch sequence X = {x_t}를 만든다.
- SSL 모델 학습 시: acoustic tokenizer가 이 patch sequence $X$를 quantize하여 patch-level discrete label \(\hat{Z} = \{\hat{z}_t\}_{t=1}^{T}\)를 생성하고, 이를 masked prediction의 target으로 사용한다. (이후 내용에서 자세히 설명)
- acoustic tokenizer 학습 시: 반대로 (이전 iteration에서 학습된) SSL 모델이 동일한 patch sequence $X$를 인코딩하여 얻은 출력 시퀀스 \(\hat{O} = \{\hat{o}_t\}_{t=1}^{T}\)를 knowledge distillation target으로 사용한다. 즉 SSL 모델이 tokenizer의 teacher 역할을 하는 것이다. (이후 내용에서 자세히 설명)
이렇게 두 모델이 서로 번갈아 가며 상대방의 학습 target을 제공하는 구조를 갖는다. 참고로 첫 번째 iteration에서는 아직 학습된 SSL 모델이 없기 때문에, random-projection tokenizer를 사용해 discrete label을 생성한다.
Acoustic Tokenizers
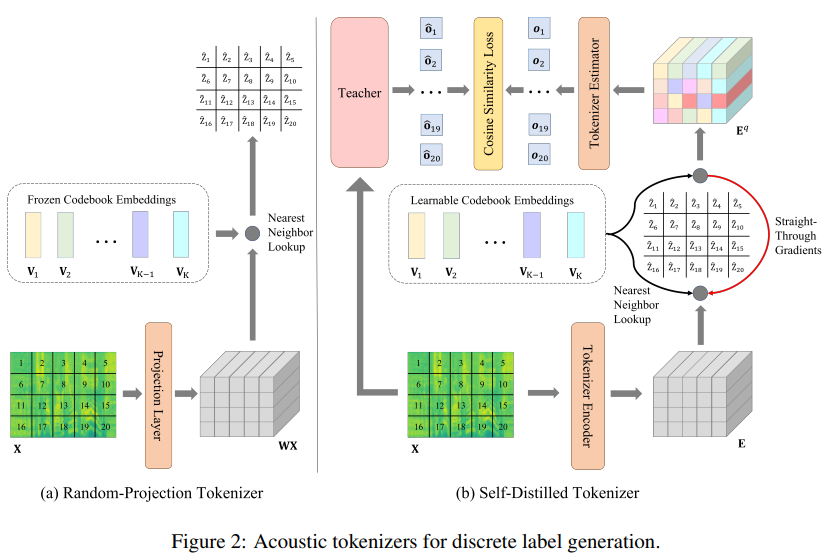
BEATs의 tokenizer는 첫 iteration에 쓰이는 Random-project Tokenizer와 이후 학습한 Self-Distilled Tokenizer가 있다.
1) Random-Projection Tokenizer
단순히 랜덤하게 patch embedding을 선형변환 하는 것이 아닌, Codebook을 이용한 양자화(Quantize)과정이 함께 일어난다.
Quantization은 연속적인(continuous) 벡터를 codebook 내가장 가까운 벡터로 매핑하고, 그 벡터의 인덱스를 이산 레이블로 사용하는 과정이다. Codebook $V = {v_1, v_2, \dots, v_K}$ 는 $K$개의 대표 벡터로 이루어진 집합이며, quantize는 입력 벡터가 이 $K$개 벡터 중 어디에 가장 가까운지를 찾는 nearest-neighbor 탐색이다.
Random-projection tokenizer의 codebook은 랜덤 초기화 이후 고정(frozen)되어 전혀 학습되지 않는다. 반면 self-distilled tokenizer의 codebook은 학습 가능(learnable)하며, quantization의 argmin 연산이 미분 불가능하다는 문제를 해결하기 위해 일반적인 backpropagation 대신 Exponential moving average(EMA) 방식으로 업데이트된다.
패치 시퀀스 \(X = \{x_t\}_{t=1}^{T}\)의 각 $x_t$를 랜덤 초기화된 linear projection $W$로 변환한 뒤, 고정된(frozen) codebook $V = {v_i}_{i=1}^{K}$에서 가장 가까운 벡터를 찾는다.
\[\hat{z}_t = \arg\min_{i} \, \lVert v_i - W x_t \rVert_2^2 \tag{1}\]- $W x_t$ : 선형변환된 입력 벡터
- $v_i$ : codebook의 $i$번째 벡터 (랜덤 초기화 후 학습되지 않음)
- $\hat{z}_t$ : 가장 가까운 codebook 벡터의 인덱스 –> 이것이 discrete label
2) Iteration: Self-Distilled Tokenizer
학습의 두 번째 iteration부터는 이전 iteration에서 학습된 audio SSL 모델(pre-trained 혹은 fine-tuned)을 teacher로 삼아 tokenizer를 학습시킨다. 이를 self-distilled tokenizer라고 부른다.
1. Tokenizer Encoder: X → E
입력 patch sequence \(X = \{x_t\}_{t=1}^{T}\)를 12-layer Transformer encoder에 통과시켜 인코딩된 벡터 시퀀스 \(E = \{e_t\}_{t=1}^{T}\)를 얻는다.
2. Quantization: E → $\hat{Z}$
각 인코딩 벡터 $e_t$에 대해, 학습 가능한(learnable) codebook $V = {v_i}_{i=1}^{K}$에서 nearest neighbor를 찾아 quantize한다. 이때 codebook 활용도(utilization)를 높이기 위해 $\ell_2$ 정규화를 적용한다.
\[\hat{z}_t = \arg\min_{i} \, \lVert \ell_2(v_i) - \ell_2(e_t) \rVert_2^2 \tag{2}\]Quantize된 벡터 시퀀스는 다음과 같이 정의된다.
\[E^{q} = \{ v_{\hat{z}_t} \}_{t=1}^{T}\]3. Tokenizer Estimator: E^q → teacher 출력 예측
$E^q$를 입력으로 하는 3-layer Transformer estimator를 학습시켜, teacher(SSL 모델)의 마지막 레이어 출력 \(\{\hat{o}_t\}_{t=1}^{T}\)을 맞히도록 한다.
+) Straight-Through Gradient
vector quantization은 $\arg\min$ 연산을 포함하므로 미분이 불가능하다. Random-Projection Tokenizer의 경우에는 학습되는 파라미터가 없어서 gradient를 계산할 필요가 없었으나, Self-Distilled Tokenizer는 Encoder와 Codebook이 learnable parameter이므로 gradient가 필요하다.
이를 위해 Van Den Oord et al. (2017)의 straight-through gradient 방식을 적용하여, backward 과정에서 quantized vector sequence $E^q$의 gradient를 encoder 출력 $E$로 그대로 복사한다.
참고: 공식 GitHub 코드(quantizer.py)에서 straight-through gradient는 다음과 같이 구현되어 있다.
z_q = z + (z_q - z).detach()
(z_q - z)에.detach()를 적용해 이 차이값에 대한 gradient를 끊음으로써, backward 시 $z_q$로 흘러온 gradient가 그대로 encoder 출력 $z$로 전달되도록 만든다.
4. 전체적인 학습 목표
Self-distilled tokenizer의 전체 학습 목표는 tokenizer estimator의 출력 \(\{o_t\}_{t=1}^{T}\)과 teacher 모델 출력 \(\{\hat{o}_t\}_{t=1}^{T}\) 사이의 cosine similarity, 그리고 encoder 출력 $E$와 quantized vector sequence $E^q$ 사이의 MSE로 구성된다.
\[\max \sum_{X \in D} \sum_{t=1}^{T} \cos(o_t, \hat{o}_t) \;-\; \lVert \text{sg}[\ell_2(e_t)] - \ell_2(v_{\hat{z}_t}) \rVert_2^2 \;-\; \lVert \ell_2(e_t) - \text{sg}[\ell_2(v_{\hat{z}_t})] \rVert_2^2 \tag{3}\]- 첫 번째 항: knowledge distillation (tokenizer estimator 출력과 teacher 출력 간 cosine similarity)
- 두 번째, 세 번째 항: encoder 출력과 quantized vector 간 MSE (codebook 학습 안정화를 위한 항)
- $D$ : pre-training dataset, $\text{sg}[\cdot]$ : stop-gradient operator
Codebook 벡터 $v_i$ 자체의 업데이트는 보다 안정적인 학습을 위해 exponential moving average (EMA) 방식으로 이루어진다 (Van Den Oord et al., 2017).
| 구성 요소 | 학습 여부 | 학습 방식 |
|---|---|---|
| Tokenizer Encoder (12-layer Transformer) | ✅ 학습됨 | 일반 backpropagation. 단, $E^q \rightarrow E$ 구간은 straight-through gradient로 우회 |
| Codebook $V = {v_i}$ | ✅ 학습됨 | EMA(exponential moving average)로 업데이트 - 일반 backprop이 아님 |
| Tokenizer Estimator (3-layer Transformer) | ✅ 학습됨 | 일반 backpropagation (loss에서 바로 연결되어 있어 gradient 문제 없음) |
5. Inference(=pre-training 파이프라인 내부)
tokenizer를 다 학습시킨 뒤, 이 tokenizer를 실제로 SSL 모델의 pre-training에 쓸 때는 estimator를 떼고 encoder+codebook만 쓴다. 입력 \(X = \{x_t\}_{t=1}^{T}\)를 위에서와 같은 방식(2)으로 patch-level discrete label \(\hat{Z} = \{\hat{z}_t\}_{t=1}^{T}\)로 변환한다.
discrete label z_t는 codebook 인덱스, 정수값이며, SSL모델 학습 시 정답값으로 사용된다.
Audio SSL Model
Backbone
이전 연구들과 마찬가지로, backbone network로 ViT(Vision Transformer) 구조를 사용한다. ViT는 linear projection layer와 여러 층의 Transformer encoder layer로 구성된다.
입력 오디오로부터 얻은 patch sequence \(X = \{x_t\}_{t=1}^{T}\)를 linear projection network에 통과시켜 patch embedding \(E = \{e_t\}_{t=1}^{T}\)를 얻는다. 이후 $E$를 Transformer encoder layer에 통과시켜 인코딩된 patch representation \(R = \{r_t\}_{t=1}^{T}\)를 얻는다.
일반 ViT와 다른 점 (구조적 개선):
- Convolution 기반 relative position embedding: Transformer 하단에 위치하며, patch 간 상대적 위치 정보를 더 잘 인코딩하기 위해 사용
- Gated relative position bias (Chi et al., 2022): 위치 정보 인코딩을 개선하기 위해 추가
- DeepNorm (Wang et al., 2022a): 보다 안정적인 pre-training을 위해 적용
Pre-Training
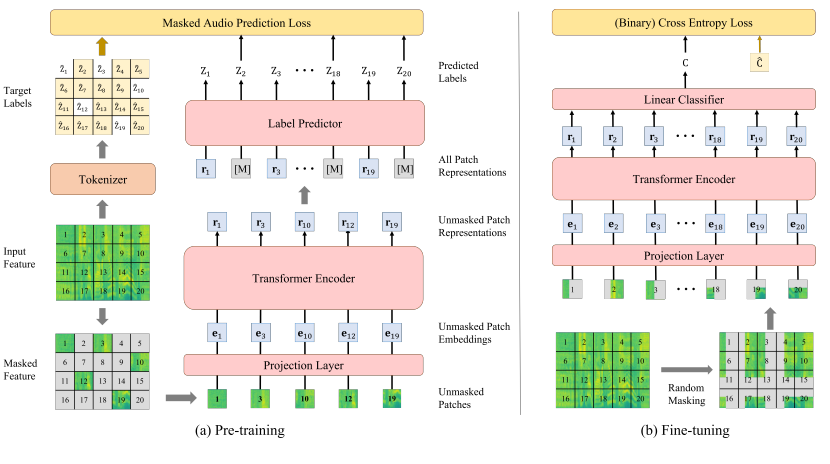
왼쪽의 (a) Pre-training 그림처럼 Masked Audio Modeling (MAM) task를 사용한다. 기존의 음향적 특징을 직접 reconstruct하며 사전학습하는 방식과 달리, BEATs는 acoustic tokenizer가 생성한 patch-level discrete label을 예측하도록 학습된다.
1. Masking
입력 patch sequence \(X = \{x_t\}_{t=1}^{T}\)와 이에 대응되는 discrete label \(\hat{Z} = \{\hat{z}_t\}_{t=1}^{T}\)가 주어지면, 이 중 75% 의 patch를 랜덤하게 마스킹한다. 마스킹된 위치의 집합을 \(\mathcal{M} = \{1, \dots, T\}^{0.75T}\)로 표기한다.
2. Encoder: 마스킹되지 않은 patch만 입력
마스킹되지 않은 patch sequence \(X^U = \{x_t : t \notin \mathcal{M}\}_{t=1}^{T}\)만을 ViT encoder에 통과시켜, 인코딩된 representation \(R^U = \{r_t : t \notin \mathcal{M}\}_{t=1}^{T}\)를 얻는다.
전체 patch가 아니라 마스킹되지 않은 patch만 encoder에 넣는 이유는 학습 속도를 크게 높이기 위함이며, downstream task 성능에도 오히려 약간의 향상을 준다고 언급한다(Xu et al., 2022).
Note: 논문에서는 $\mathcal{M}$을 “masking된 위치의 집합(75%)”으로 정의했음에도, 이후 $X^U$, $R^U$, label predictor 입력 수식에서는 $t \in \mathcal{M}$을 “masking되지 않은(unmasked)” 위치를 가리키는 데 사용하고 있어 표기상 일관성이 어긋난다. 이 글에서는 의미에 맞게 $t \notin \mathcal{M}$ (unmasked) / $t \in \mathcal{M}$ (masked, mask token 대입)로 표기한다.
3. Label Predictor: 전체 위치에 대해 discrete label 예측
Encoder를 거친 non-masked patch representation과, masked position에는 학습 가능한 mask token(0으로 표기)을 채워 넣은 조합
\[\{r_t : t \notin \mathcal{M}\}_{t=1}^{T} \cup \{\mathbf{0} : t \in \mathcal{M}\}_{t=1}^{T}\]을 label predictor(Transformer 기반)에 입력하여, 전체 위치에 대한 discrete label $Z = {z_t}_{t=1}^{T}$을 예측한다.
Mask token $\mathbf{0}$은 masking된 모든 위치에서 동일한 값을 갖는 placeholder로, 실제로 “그 위치에 무엇이 있었는지”에 대한 정보를 담고 있지 않다. 그럼에도 각 masked 위치마다 서로 다른 discrete label $\hat{z}_t$를 예측할 수 있는 이유는, Transformer의 position embedding과 self-attention을 통해 주변 unmasked patch들의 정보를 활용하기 때문이다. 이는 BERT의 [MASK] 토큰과 동일한 원리이다.
Note: BEATs 논문에는 mask token이 learnable 벡터인지, 단순한 고정 zero vector인지 명시되어 있지는 않다.
4. 학습 목표
MAM의 pre-training objective는 cross entropy loss이며, 마스킹된 위치에서 정답 discrete label $\hat{z}_t$의 log-likelihood를 최대화하는 방향으로 학습한다.
\[\mathcal{L}_{MAM} = -\sum_{t \in \mathcal{M}} \log p(\hat{z}_t \mid X^U) \tag{4}\]즉, encoder는 마스킹되지 않은 정보만으로 문맥을 파악하고, label predictor는 그 문맥을 바탕으로 마스킹된 위치의 “정답 label”(tokenizer가 만들어 둔 $\hat{z}_t$)을 맞히도록 학습된다. BERT의 masked language modeling과 동일한 구조를, “단어” 대신 “discrete acoustic label”에 적용한 것이라 볼 수 있다.
Fine-Tuning
파인튜닝 단계에서는 pre-training 때 사용했던 label predictor를 버리고, ViT encoder 위에 task-specific한 linear classifier를 연결하여 downstream classification task를 수행한다.
1. 입력 처리
먼저 입력 acoustic feature에 시간과 주파수 축으로 랜덤 마스킹을 적용하는 spec-augmentation(Park et al., 2019)을 수행한 뒤, 이를 patch로 나누고 flatten하여 patch sequence $X = {x_t}_{t=1}^{T}$를 만든다.
2. Encoder: pre-training과의 차이
Pre-training에서는 75%를 마스킹하고 unmasked patch만 encoder에 입력했지만, fine-tuning에서는 전체 patch sequence $X$를 그대로 ViT encoder에 입력하여 encoded representation $R = {r_t}_{t=1}^{T}$를 얻는다.
3. Classifier
Encoder의 출력 $R$에 linear projection $W_c$를 먼저 적용한 뒤, 이를 mean-pooling하고 softmax를 거쳐 category 확률을 계산한다.
\[p(C) = \text{Softmax}(\text{MeanPool}(W_c R))\]- $W_c$: linear classifier의 projection weight
- MeanPool: $W_c R$의 결과(patch sequence 전체, $T$개)에 대한 평균 풀링
- Softmax: 최종 class 확률로 변환
4. Loss Function
- 단일 레이블 분류 task: cross entropy loss
- 다중 레이블 분류 task (AudioSet처럼 하나의 clip에 여러 class가 붙는 경우) 또는 mixup augmentation(Zhang et al., 2017)을 적용하는 경우: binary cross entropy loss
Implementation Details
Backbone
- Transformer encoder layer 12개, hidden dimension 768, attention head 8개
- 총 파라미터 수: 90M
- 기존 SOTA 모델(Audio-MAE, MaskSpec 등)과 모델 크기를 비슷하게 맞춰 pre-training 방법 자체의 효과를 공정하게 비교
Acoustic Feature 추출
- Raw waveform → sample rate 16,000Hz로 변환
- 128차원 Mel-filter bank feature 추출 (25ms Povey window, 10ms shift)
- Feature를 평균 0, 표준편차 0.5로 정규화
- 16×16 크기의 patch로 분할 후 flatten하여 patch sequence 생성
Codebook
- Codebook: $K = 1024$개의 embedding vector로 구성, 각 벡터의 차원은 256 ($V \in \mathbb{R}^{1024 \times 256}$)