hemisus

1. Image Classification: A Core Task in Computer Vision
인간의 시각적 인지 능력은 짧은 순간에도 사진 속 객체가 무엇인지 판단할 수 있다. 고양이와 개를 구분하는 일은 우리에게 무의식적으로도 가능한 쉬운 문제지만, 컴퓨터에게 이는 어려운 도전 과제이다.
먼저 컴퓨터가 이미지를 보는 방식을 알아야 한다.
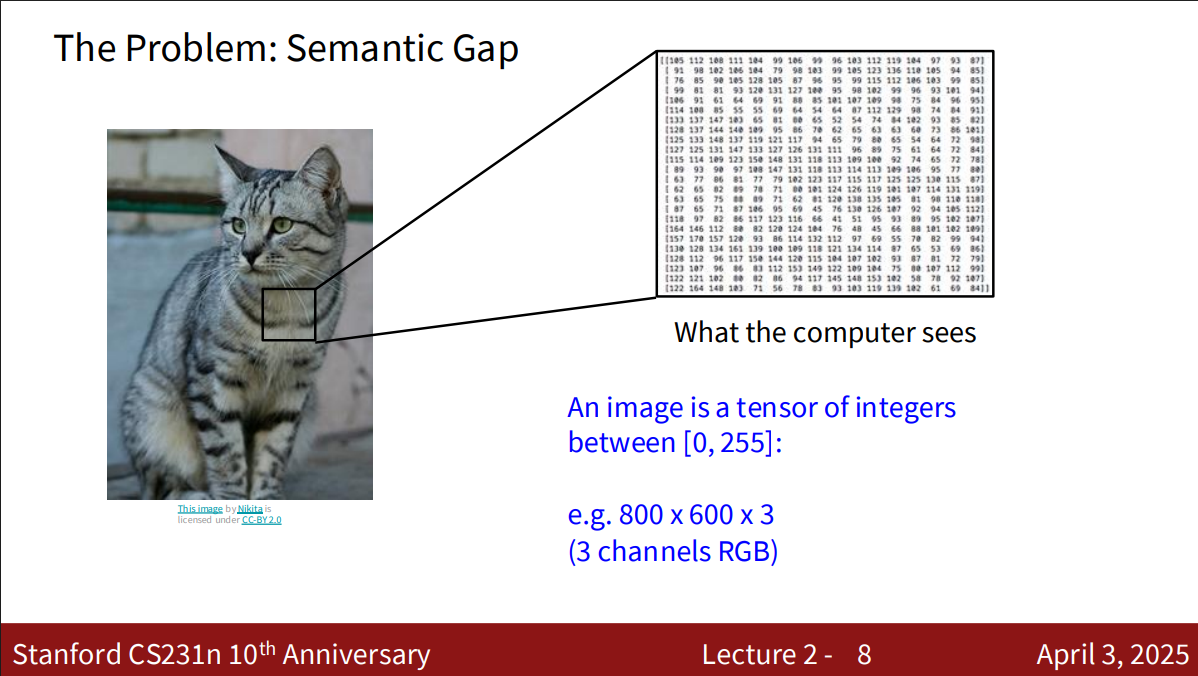
컴퓨터에서 이미지는 각 픽셀 값의 행렬 또는 텐서로 인식되며, 각 픽셀이 0~255값을 가지는 총 3개의 채널 (R/G/B)로 구성된다. 이처럼 이미 인간의 이미지 인식 방식과 매우 다르기 때문에, 컴퓨터의 이미지 분류에는 다양한 난관이 존재한다.
컴퓨터의 이미지 이해의 난관들
| 문제 | 설명 |
|---|---|
| Viewpoint Variation | 같은 물체도 촬영 각도에 따라 픽셀 값이 완전히 달라짐 |
| Illumination | 조명의 강도나 방향에 따라 동일 객체가 다르게 표현됨 |
| Background Clutter | 객체와 배경의 픽셀 값이 유사하면 구분이 어려움 |
| Occlusion | 객체 일부가 가려져 있어도 전체를 추론할 수 있어야 함 |
| Deformation | 같은 클래스의 객체라도 다양한 형태로 존재함 |
| Intraclass Variation | 같은 클래스 내에서도 크기, 색상, 패턴이 다양함 |
| Context | 주변 환경, 맥락을 이해해야 올바르게 분류 가능 |
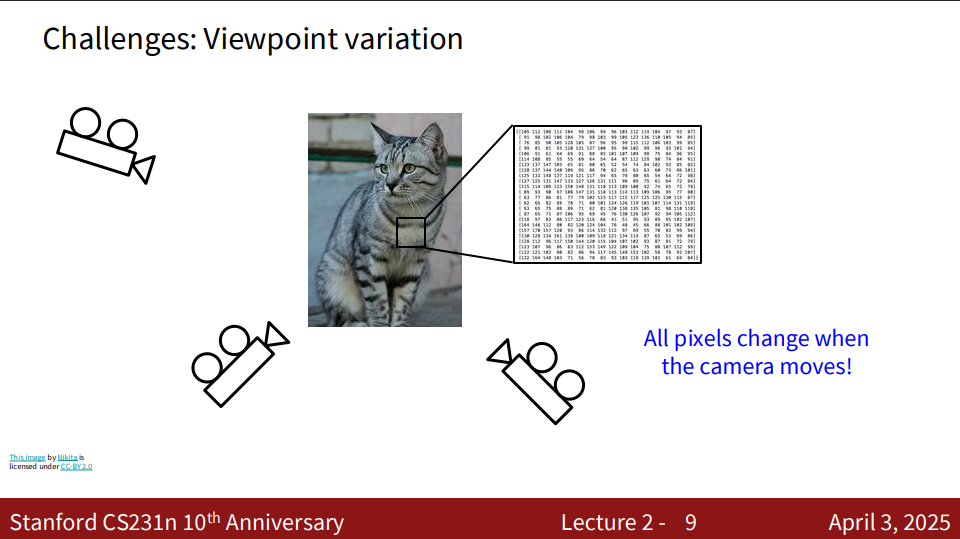
1. Viewpoint Variation
같은 물체를 찍었더라도 찍은 위치에 따라 그 이미지 픽셀은 완전히 변화된 값을 가지게 된다.
2. Illumination
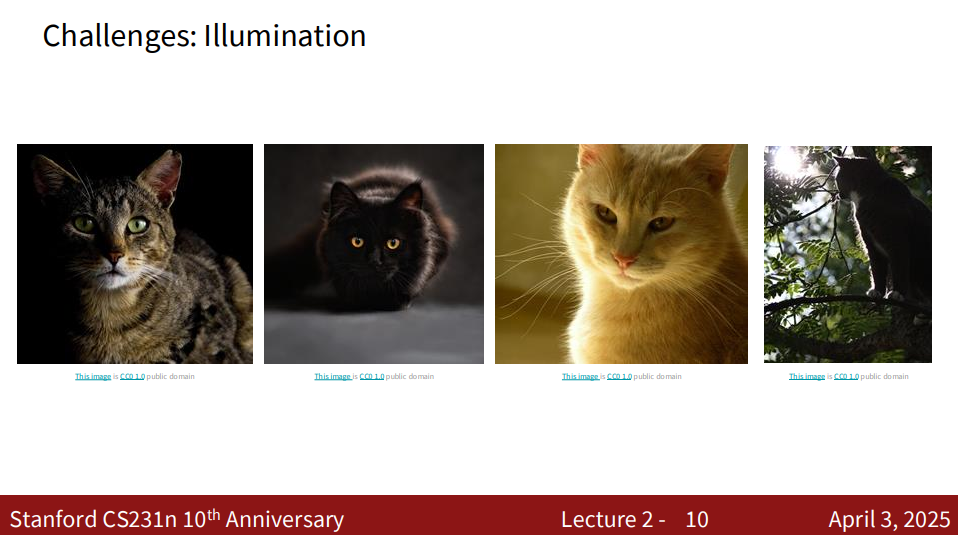
같은 객체여도 빛의 강도에 따라 이미지에는 다르게 표현된다. 우리는 조명의 차이를 바로 인지할 수 있으나 컴퓨터에겐 이것 또한 어려운 과제이다.
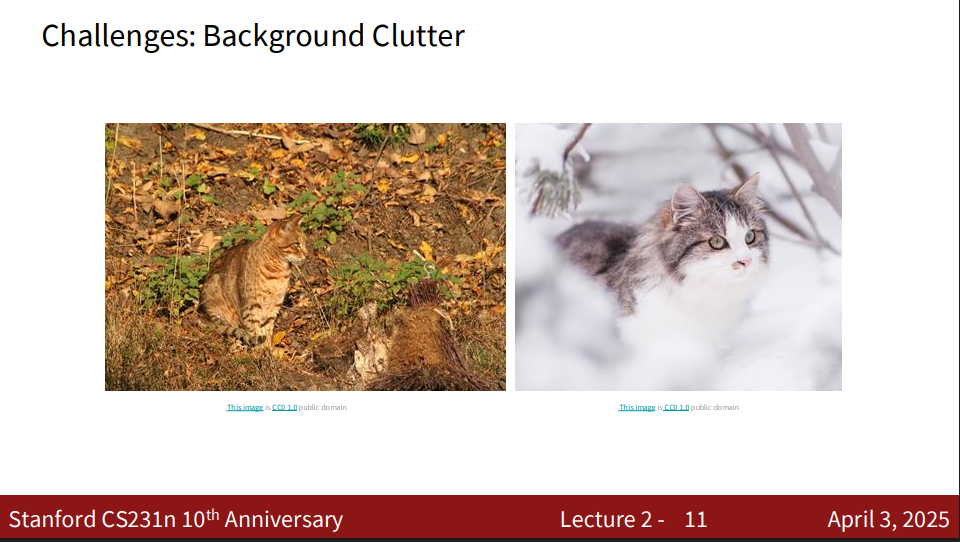
3. Background Clutter
인식하고자 하는 객체가 이미지의 배경과 비슷한 픽셀 값을 가지면 컴퓨터는 구분하기가 힘들어진다.
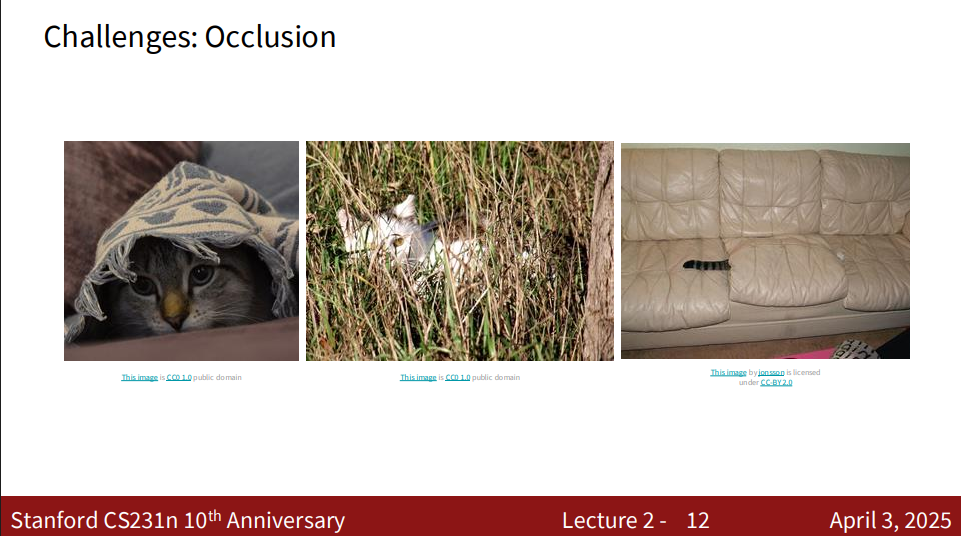
4. Occlusion
사진과 같이 동물의 일부가 다른 것에 가려져 있을 경우, 일부를 보고 물체를 추론할 수 있어야 한다.
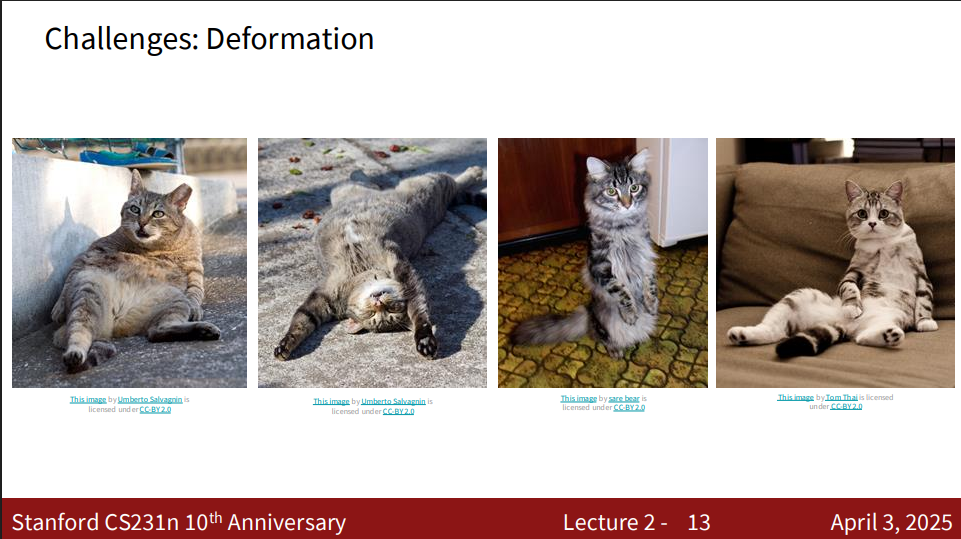
5. Deformation
같은 클래스의 객체여도 다양한 형태로 존재 가능하다.
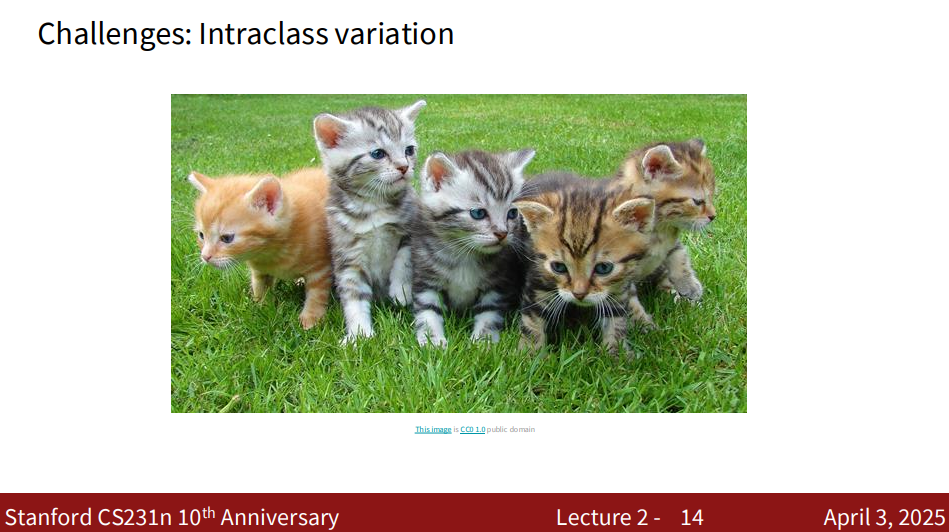
6. Intraclass variation
같은 클래스의 객체여도 다양한 종류가 있다는 것을 인지해야 한다. (size, color, pattern 이 전부 달라도 모두 cat이다)
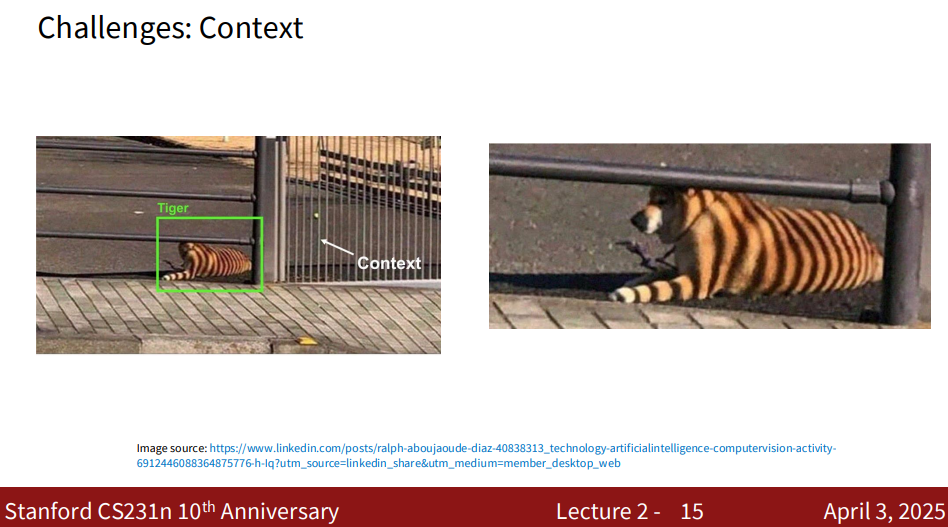
7. Context
그림과 같이 우리는 그림자로 인해 개에게 줄무늬 그림자가 생긴 것을 이해할 수 있으나, 컴퓨터는 이를 호랑이로 분류할 수도 있을 것이다. 이처럼 이미지 속 상황에 대한 이해를 하는 능력이 요구된다.
2. K-Nearest Neighbor (KNN) Classifier
KNN은 가장 단순한 데이터 기반 접근법(Data-Driven Approach)의 분류기이다.
분류하려는 이미지와 학습으로 저장된 이미지들 간의 거리(픽셀값의 차이)를 계산하여, 가장 가까운 k개의 이미지를 찾고, 그 중 가장 많은 클래스로 분류한다.
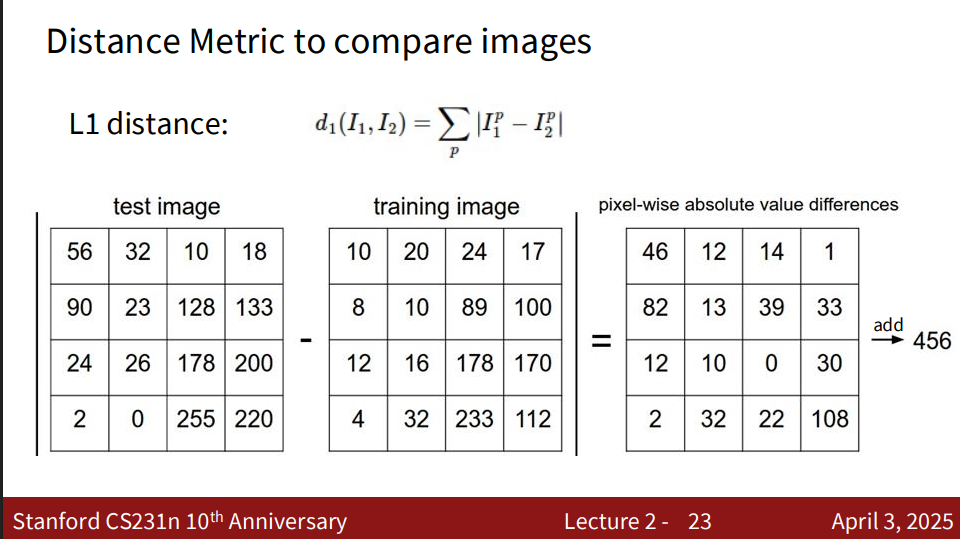
이때 이미지들간의 거리를 측정하는데 다음과 같은 방식이 있다.
- L1 Distance (맨해튼 거리): 각 픽셀 값의 차이를 절댓값하여 전부 더한 값.
- L2 Distance (유클리드 거리): 각 픽셀 값의 차이를 제곱한 것을 전부 더한 후 제곱근. (일반적인 두 점 사이의 직선 거리)
학습 방식: Lazy Learning
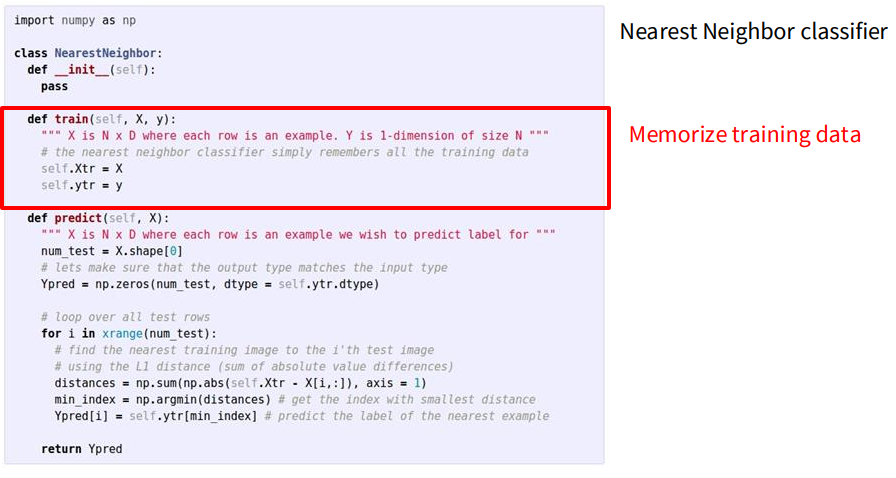
def train(self, X, y):
    self.Xtr = X  # 전체 학습 데이터를 그대로 저장
    self.ytr = y
코드와 같이 train함수에서 그냥 전체 데이터셋을 메모리에 그대로 복사하고 있다. (주석 확인)
이처럼 일반적인 모델처럼 “학습(가중치 업데이트)”을 하는 게 아니라 훈련 데이터를 통째로 외워버리는 것이 KNN의 특징이며, 이를 “게으른 학습(Lazy Learning)” 이라고도 한다.
하지만 이러한 방식으로 인해 한계가 명확하다.
- 예측 속도: 학습은 빠르지만, 예측 시 전체 데이터와 거리를 계산해야 하므로 매우 느림
- 낮은 표현력: 픽셀 간 거리는 이미지의 의미적 정보를 담지 못함(Not informative). 이미지를 한 픽셀씩 밀거나, 가리거나, 밝기를 바꾸면 거리값이 크게 변해버림
3. Linear Classifier
파라미터 기반 접근법 (Parametric Approach)의 분류기로, 학습할 때 데이터를 단순히 저장하지 않고, 원하는 결과를 얻기 위해 파라미터(W)에 데이터로부터 얻은 정보를 저장, 최적화 하는 방식이다.
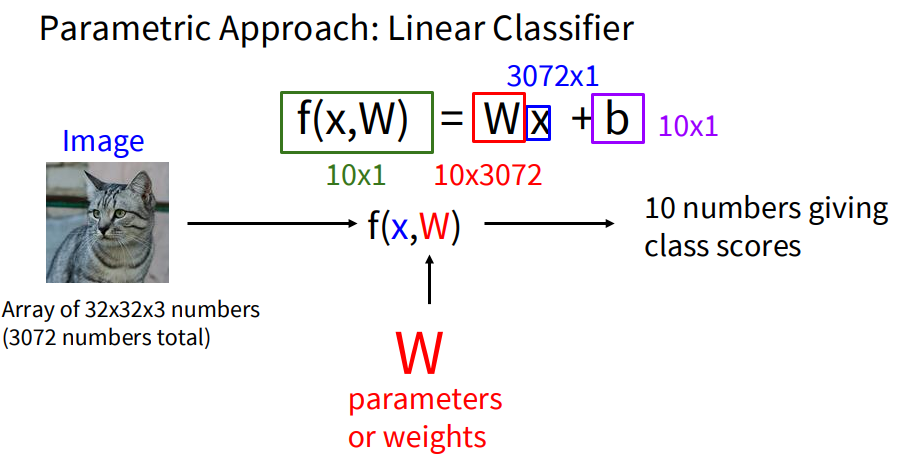
- $x$: 입력 이미지 (flatten된 벡터, 예: 32×32×3 → 3072차원)
- $W$: 가중치 행렬 (학습으로 최적화할 파라미터)
- $b$: 편향(Bias)
- 출력: 각 클래스에 대한 점수(Score)
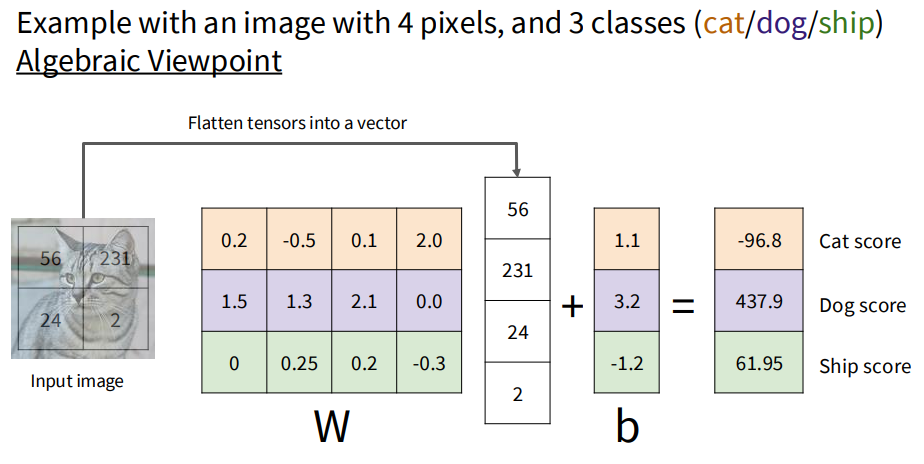
선형 분류기는 f(x,W) = Wx + b로 나타낼 수 있으며 여기서 x는 입력 이미지로, 보통 선형 분류기에 들어올때 flatten된 상태로 들어온다. (Array of 32x32x3 ->3072 numbers total)
슬라이드의 예시처럼 입력데이터와 W가 곱해지는데, W의 각 행이 해당 클래스의 정보를 담고 있어 결과 값이 그 클래스에 대한 점수를 나타내게 된다.
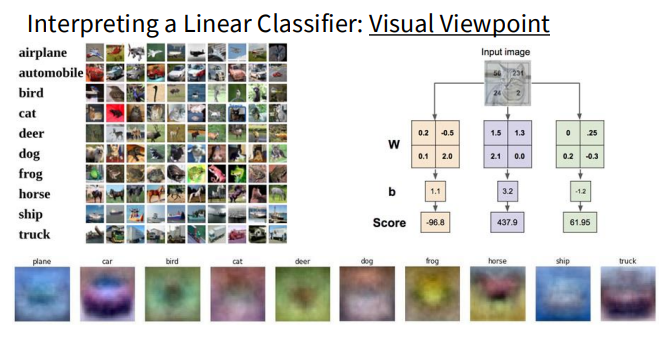
Visual Viewpoint
W의 각 행을 이미지처럼 2차원의 이미지로 시각화하면, 각 클래스에 대한 특징이 추출된 형상을 확인할 수 있다.
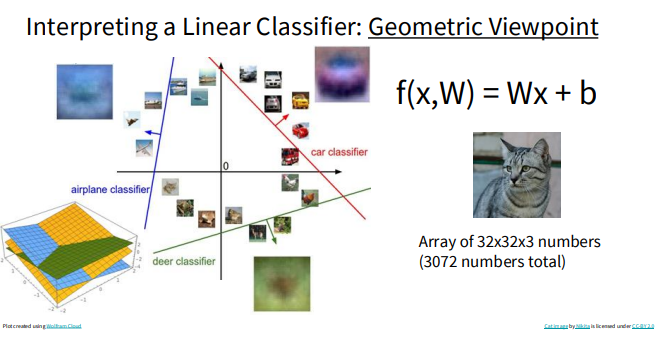
Geometric Viewpoint
$Wx + b$를 공간에 나타내보면, 해당 클래스와 아닌 것을 분리하는 초평면(Hyperplane) 의 법선 벡터 역할을 한다.
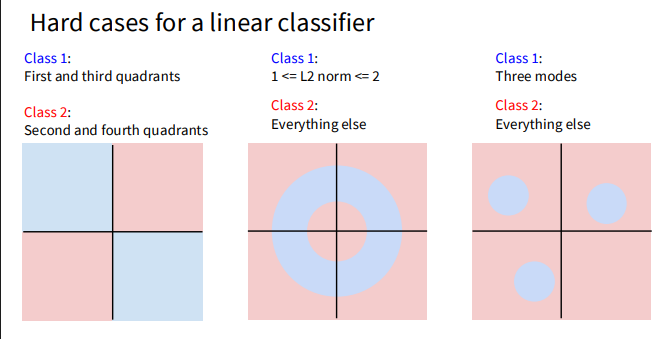
하지만 이처럼 선형 분류기는 선형적으로 분리 가능하지 않으면 제대로 클래스를 분류할 수 없다는 치명적인 단점이 있다.
4. Loss Function & Softmax Loss
손실 함수는 모델의 예측이 실제 정답에 비해 얼마나 잘못 되었는지를 측정하는 함수이다. 모델을 학습시킨다는 것은 이 손실함수 값을 최소화하도록 모델의 파라미터를 조정하는 것이다.
Softmax
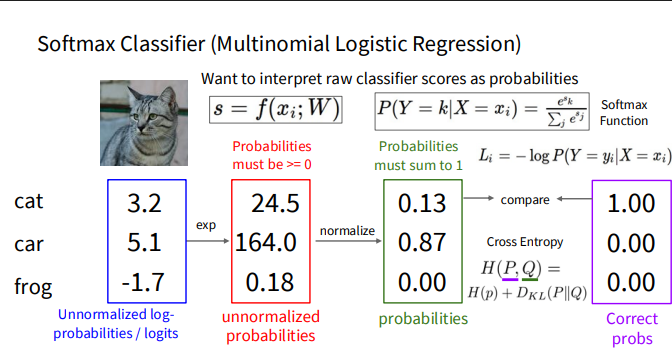
선형 분류기의 출력인 점수(logit) 그 자체로는 확률적 해석이 불가능하다.
Softmax함수는 여러 개의 출력값을 모두 합쳐서 1(100%)이 되는 확률 분포로 변환해준다. 이로써 분류기의 예측값을 각 클래스에 대한 예측 확률로 변환할 수 있다.
\[\text{softmax}(z_i) = \frac{e^{z_i}}{\sum_j e^{z_j}}\]아래의 공식은 softmax의 개선된 공식으로, 지수에 입력 z의 최댓값을 빼줌으로써 수치 안정성을 확보한다.
\[\text{softmax}(z_i) = \frac{e^{z_i - \max(z)}}{\sum_j e^{z_j - \max(z)}}\]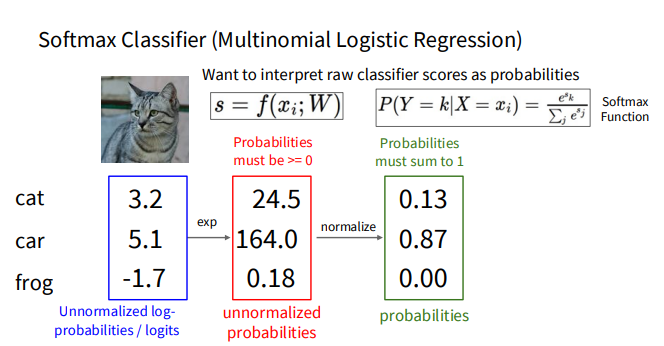
Cross-Entropy Loss
확률 분포와 실제 정답(One-hot 벡터)과의 차이를 측정하는 손실 함수이다.
\[L = -\sum_{c} y_c \log(\hat{p}_c)\]“모델이 예측한 확률 분포가 정답 분포와 얼마나 멀리 있는가?”
- $y_c$: 정답 레이블 (정답 클래스는 1, 나머지는 0인 One-hot 벡터)
- $\hat{p}_c$: 클래스 $c$의 예측 확률
정답 클래스를 제외한 나머지 $y_c$는 모두 0이므로, 결국 정답 클래스의 예측 확률만 남는다.
만약 정답으로 예측한 클래스의 확률이 1 이라면 손실함수의 값이 0이므로 최소이고, 정답 클래스의 예측확률이 작을 수록 앞에 - 부호로 인해 점점 손실함수의 값은 커지는 식이다.
\[L = -\log(\hat{p}_{y_i})\]Softmax Loss
Softmax Loss는 Softmax 함수 + Cross-Entropy Loss 를 결합한 것으로, 정답 클래스의 예측 확률에 음의 로그를 취한 형태이다.
\[L_i = -\log\left(\frac{e^{z_{y_i}}}{\sum_j e^{z_j}}\right)\]