hemisus

1. Regularization
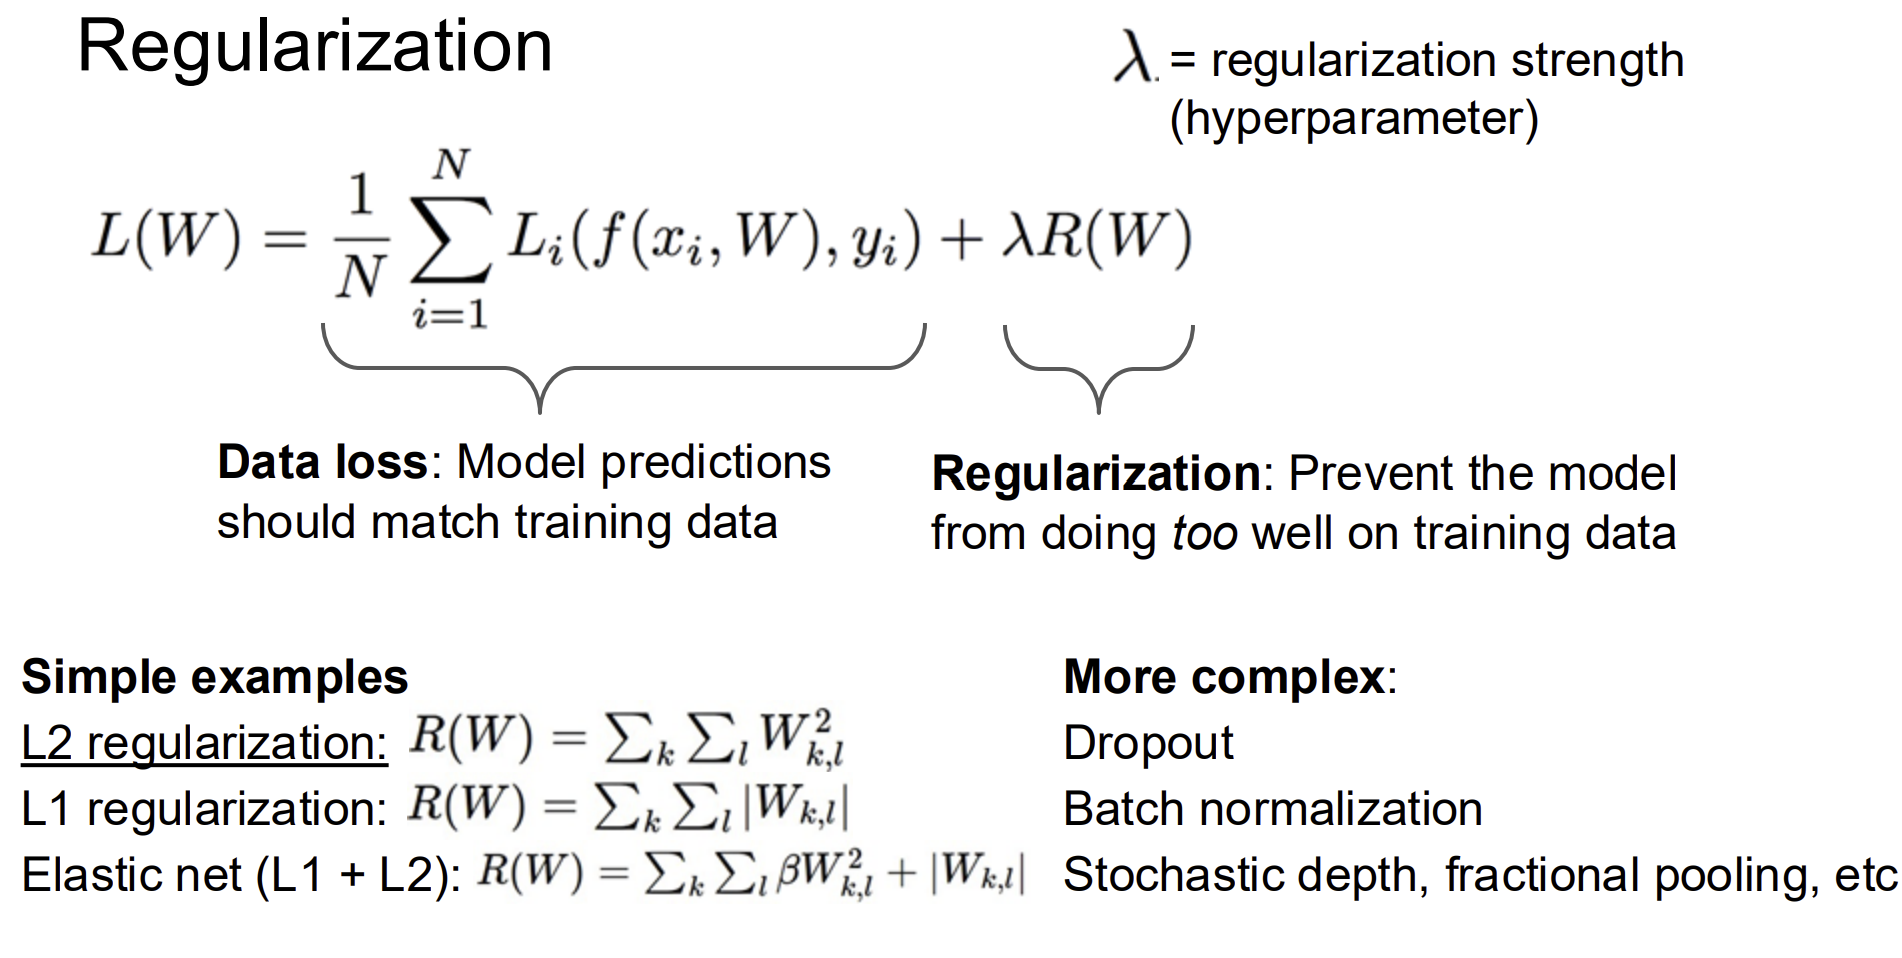
정규화 항은 손실함수에 추가되어 data loss이외에도 패널티를 부여해 모델이 Training Data에 과적합되는 것을 방지한다.
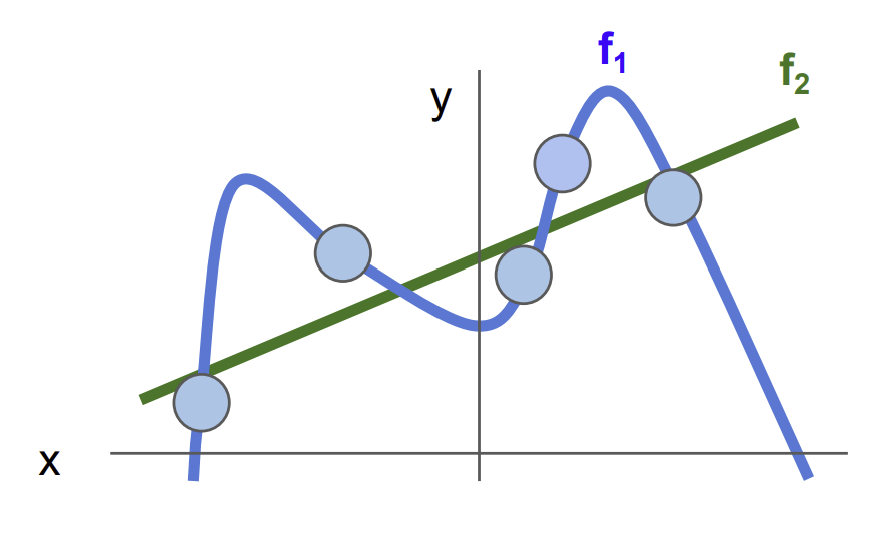
아래와 같이 학습된 모델 f1, f2가 있을때, f1은 모든 데이터의 지점을 통과하여 Training Loss는 f2보다 낮겠지만, 새로운 데이터 (Test Data)에 대한 Loss는 데이터의 추세를 더 잘 반영하는 f2가 더 낮을 것을 알 수 있다.
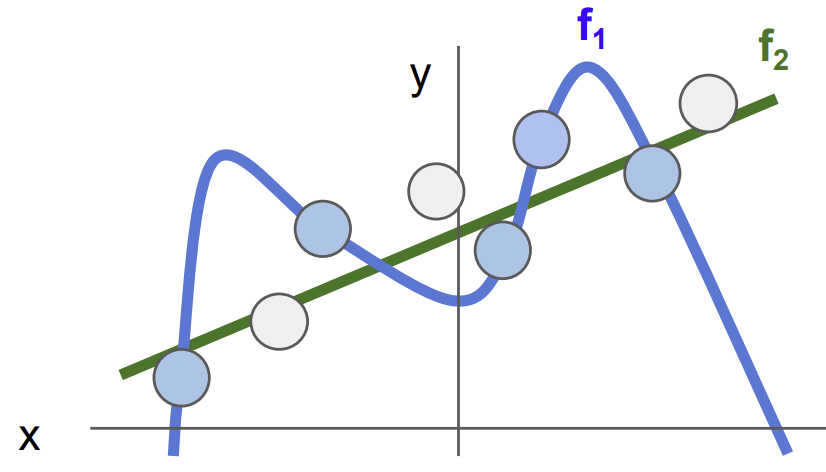
이처럼 Training loss는 f1이 더 작았지만 f2가 더 학습이 잘 된 모델이라고 할 수 있다. 이렇게 모델이 적당하게 학습할 수 있도록 패널티를 부여하는 것이 Regularization이다.
+) 오컴의 면도날(Occam’s Razor): ‘같은 현상을 설명하는 두 개의 주장이 있다면, 간단한 쪽을 선택하라,
1.1 L2 Regularization
L2 Regularization은 모든 가중치의 제곱합을 손실함수에 추가한다.
제곱을 하기 때문에 가중치가 클수록 패널티가 크게 작용하여 가중치를 빠르게 감소시키는 weight decay효과가 있다. 반대로 이미 값이 작은 가중치는 제곱하면 더 작아져 수치에 거의 영향을 주지 않는다.
이러한 특성으로 인해 L2는 가중치를 전체적으로 작지만 고르고 분산된(spread out) 형태로 만드는 경향이 있다.
전체 Loss는 다음과 같다:
\[L_{total} = L_{data} + \frac{\lambda}{2} W^2\]여기서 1/2이 붙는 이유는 미분을 깔끔하게 하기 위한 수학적 편의이다.
\[\frac{\lambda}{2} W^2 \quad \xrightarrow{\text{미분}} \quad \frac{\lambda}{2} \cdot 2W = \lambda W\]1.2 L1 Regularization
L1은 가중치를 제곱하는 대신 절댓값을 취해 더한 값을 사용한다.
제곱을 하지 않기 때문에 작은 가중치의 값을 0이 되게 만들어 해당 feature를 모델에서 제거하는 효과가 있다. 이는 모델을 더 단순하고 희소한(Sparse) 형태로 만든다.
\[L_{total} = L_{data} + \lambda \sum |W|\]또한 L1, L2 공통적으로 조율모수 λ가 붙는데, 이 값 또한 커질수록 패널티의 영향이 커지며, 분산(Variance)은 감소하고 편향(Bias)이 증가한다.
아래와 같이 x=[1,1,1,1]; w1=[1,0,0,0]; w2=[0.25,0.25,0.25,0.25]일 때, w · x는 모두 1이지만 L2 Regularization을 할 경우 w2가 더 선호하는 가중치가 될 것이다.
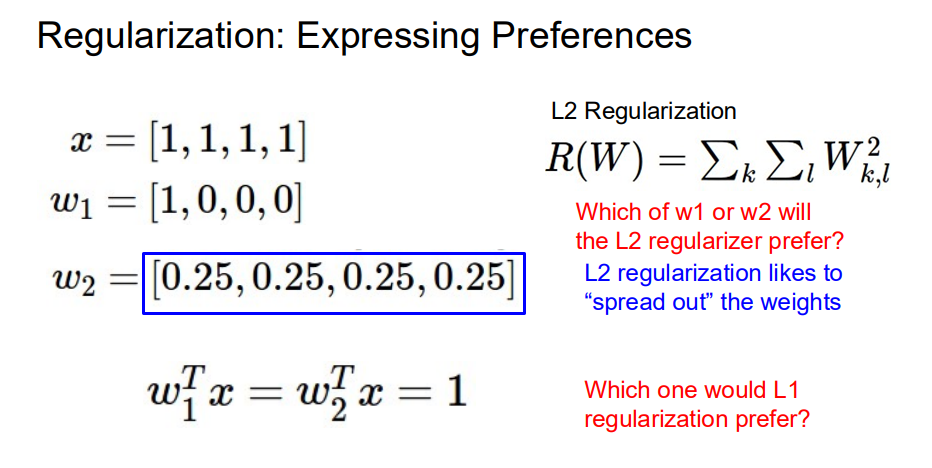
L1 Regularization의 경우 이 예제에서는 w1, w2 둘 다 동일한 정규화 값을 가지지만 L1은 w1처럼 Sparse한 형태의 가중치를 선호할 것이다.
항상 어떤 정규화를 옳다거나, 정규화가 무조건 모델을 단순하게 만든다는 원칙은 없으며, 데이터와 모델에 따라 자신이 적절한 정규화 방법을 선택해야 한다.
1.3 ElasticNet
ElasticNet은 이 L1과 L2를 복합적으로 활용하는 정규화 기법이다.
하이퍼파라미터 r을 활용하여 각 기법의 영향도를 조절할 수 있으며, 한가지 기법만을 활용하는 것 또한 가능하다.
2. Optimization
손실 함수의 값을 최소화하는 모델의 가중치를 찾는 과정이 바로 Optimization(최적화)이다.
이 최적화의 가장 기본이 되는 알고리즘은 Gradient Descent(경사하강법)이다. 손실함수의 경사(기울기)를 따라 내려가면서 가중치를 업데이트하여 손실함수가 가장 작아지는 지점을 찾는 방법이다.
\[W ← W − η · ∇_W L\]이 수식은 Gradient Descent의 가중치 업데이트 수식이다.
| 기호 | 의미 |
|---|---|
| W (우변) | 현재 가중치 |
| η (eta) | Learning Rate (학습률) — 한 번에 얼마나 이동할지 결정하는 하이퍼파라미터 |
| ∇_W L | 손실 함수 L을 가중치 W로 편미분한 값 (Gradient) |
| W (좌변) | 업데이트된 새로운 가중치 |
Gradient(∇_W L) 는 수학적 정의상 함수값이 가장 가파르게 증가하는 방향과 그 크기를 나타내는 벡터이다.
우리의 목표는 Loss를 최소화하는 것이므로, Gradient의 반대 방향(−) 으로 W를 조정하는 것이다.
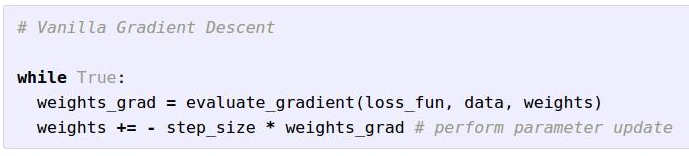
딥러닝의 최적화에서는 거의 대부분 이러한 Analytic Gradient를 계산하여 최적화를 진행하고, Numeric Gradient는 구현이 올바른지 디버깅하는 용도로만 활용된다.
| Numeric Gradient | Analytic Gradient | |
|---|---|---|
| 방법 | h를 아주 작게 설정하여 (f(x+h) - f(x)) / h 로 근사 계산 |
미적분을 이용해 Gradient를 수식으로 직접 유도 |
| 정확도 | 근사값 (부정확) | 정확한 값 |
| 속도 | 매우 느림 | 빠름 |
| 사용 목적 | Gradient 구현이 올바른지 검증할 때 (Gradient Check) | 실제 학습에 사용 |
3. Variant of Gradient Descent
3.1. Stochastic Gradient Descent (SGD)
기본적인 경사하강법은 전체 데이터에 대한 Loss와 Gradient를 계산하고 나서야 1회의 가중치 업데이트가 진행이 되었다. 이 방식은 데이터의 크기가 커질 경우 학습 속도가 매우 느릴 것이다.
이를 해결하기 위해 SGD에서는 전체 데이터에서 무작위로 일부 데이터를 뽑은 mini-batch에서 그래디언트를 계산해 W를 여러번 업데이트한다.
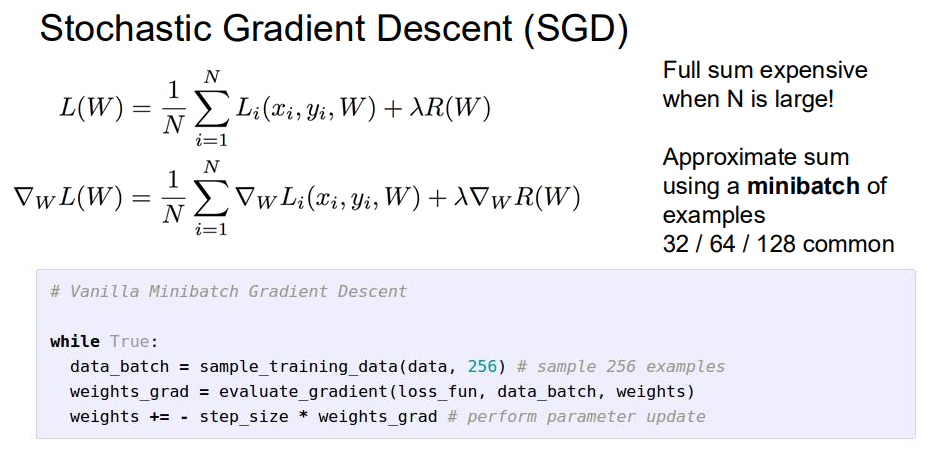
원래 SGD는 데이터를 1개씩 뽑아 업데이트 하는 것을 의미하지만, 실제로는 Mini-batch SGD를 통칭하여 SGD라고 부르는 경우가 대부분이다.
| Epoch | 전체 데이터에 대해 한 번 학습을 완료하는 시점 |
| Batch Size | 한 배치에 있는 데이터의 수 |
| Iteration | 한 Epoch를 완료하기 위해 반복하는 횟수 (한 Epoch에서 이루어지는 파라미터 업데이트 횟수) |
| GD | SGD | Mini-batch SGD | |
|---|---|---|---|
| Batch Size | 전체 데이터 (N) | 1 | 일부 (32, 64, 128) |
| 1 Epoch 당 Iteration | 1 | N | N / Batch Size |
| 학습 속도 | 느림 | 빠르지만 불안정 | 빠르고 안정적 |
SGD의 문제점
1. Loss Surface의 경우에 따라 진동이 발생함
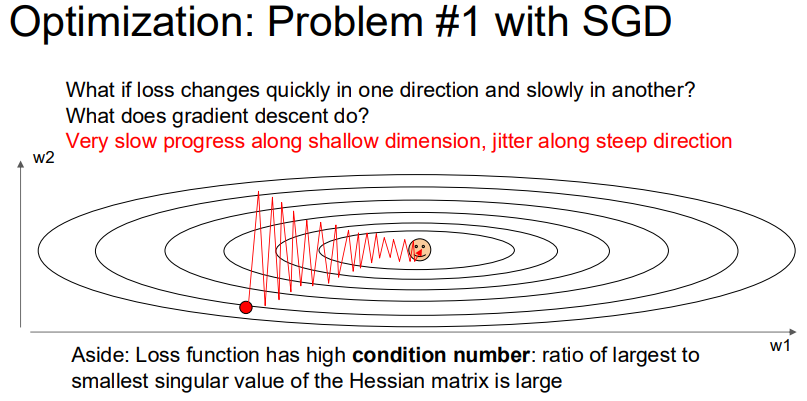
손실 함수가 어떤 방향으로는 매우 가파르고, 다른 방향으로는 매우 완만한 형태를 가지는 경우, 우리가 실제로 가고 싶은 곳은 완만한 방향의 끝에 있는 최솟값인데, 가파른 방향의 진동 때문에 지그재그로 비효율적으로 이동하게 된다.
좁고 긴 협곡의 바닥으로 내려가야 하는 상황을 비유하면, 협곡의 양 벽면(가파른 방향) 사이에서 왔다갔다 튕기거나 바깥으로 벗어날 수 있으며, 실제로 가야 할 아래쪽(완만한 방향)으로는 아주 조금씩만 전진하게 된다.
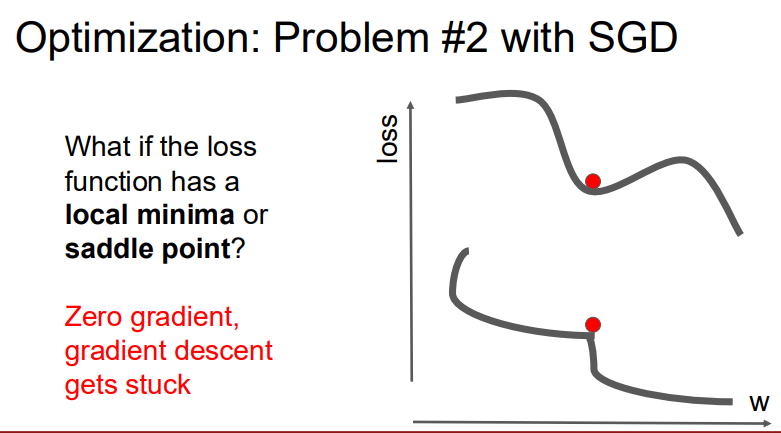
2. 지역 최솟값(Local Minimum) / 안장점(Saddle Point)에 갇힘
손실 함수의 Gradient가 0이 되는 지점에 도달하면 W 업데이트가 멈추게 된다. 이 지점이 전역 최솟값(Global Minimum)이 아니더라도 Gradient가 0이므로 더 이상 탈출할 수 없다.
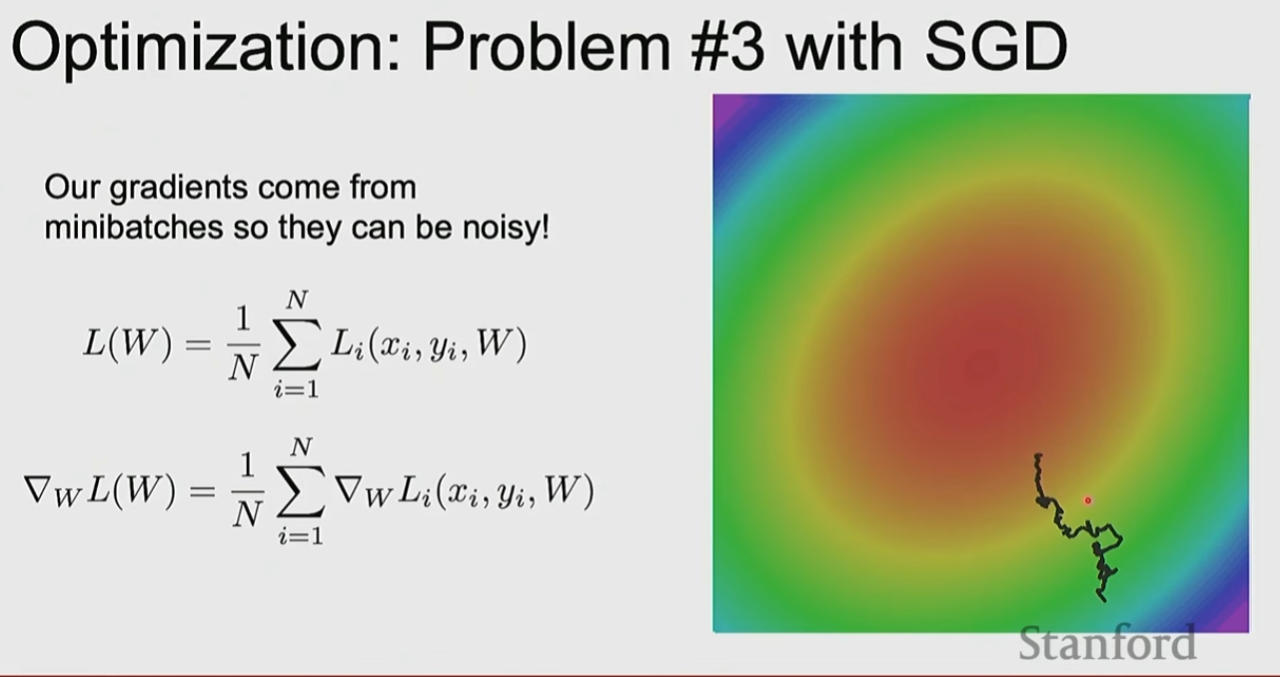
3. Mini-batch 샘플링에 의한 Gradient 노이즈
모든 데이터가 아닌 일부 샘플링된 데이터를 기반으로 Gradient를 계산하기 때문에 전체 데이터에 대한 손실함수의 그래디언트를 정확히 반영하지는 못한다. 장기적으로는 Loss의 최소 지점을 찾아갈 수 있으나, 매 Step이 항상 올바른 방향을 보장하지는 않는다.
3.2. SGD + Momentum
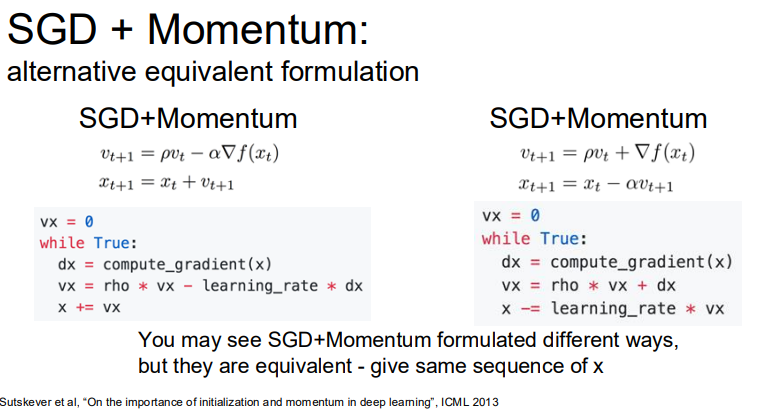
기존 파라미터가 업데이트되어 온 방향을 기억하여 다음 업데이트에 반영하는 방식이다. 마치 물체가 움직이던 방향으로 관성을 가지는 것과 같다.
아래 식과 코드처럼 감쇠 계수 ρ(rho)가 곱해지며 누적된 Gradient(Vt)를 이용해 파라미터를 업데이트한다.
이로써 gradient=0이 되더라도 누적된 속도(Vt)가 남아있어 빠져나올 수 있고, 여전히 진동 문제는 남아있으나 최솟값을 향하는 방향의 Gradient가 지속적으로 누적되면서 점차 올바른 방향으로의 이동이 강화된다.
3.3. RMSProp
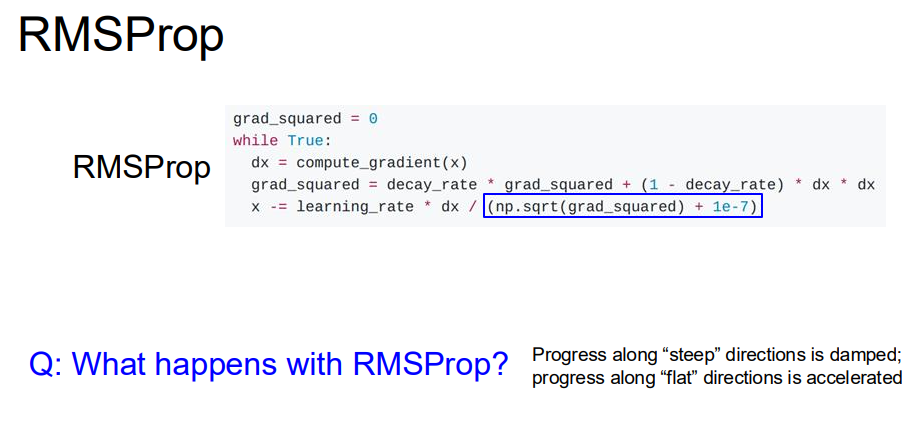
RMSProp은 Gradient의 크기를 추적하여 얼만큼 다음 step의 이동량을 조절하는 알고리즘이다.
Momentum에서는 Gradient의 방향과 크기가 함께 누적되었다면, RMSProp에서는 Gradient를 제곱하여 각 방향이 얼마나 가파른지 크기만을 추적한다. 이 누적된 제곱값으로 파라미터 업데이트 시 Learning Rate를 나눠줌으로써, 가파를수록 적게 움직이고, 완만한 구간에서는 크게 움직이는 효과를 보여준다.
\[S_t = \rho \cdot S_{t-1} + (1 - \rho) \cdot (\nabla_W L)^2\] \[W \leftarrow W - \eta \cdot \frac{\nabla_W L}{\sqrt{S_t} + \epsilon}\]| 기호 | 의미 |
|---|---|
| $S_t$ | Gradient 제곱의 누적값 (이동 평균) |
| $\rho$ | 감쇠 계수 (보통 0.9 또는 0.99) |
| $(\nabla_W L)^2$ | 현재 Gradient의 제곱 |
| $\epsilon$ | 0으로 나누는 것을 방지하기 위한 아주 작은 값 (예: $10^{-7}$) |
사람이 경사가 심한 곳은 조심히 작은 보폭으로 가고, 완만한 평지는 빠르게 이동하는 것을 생각하면된다.
3.4 Adam
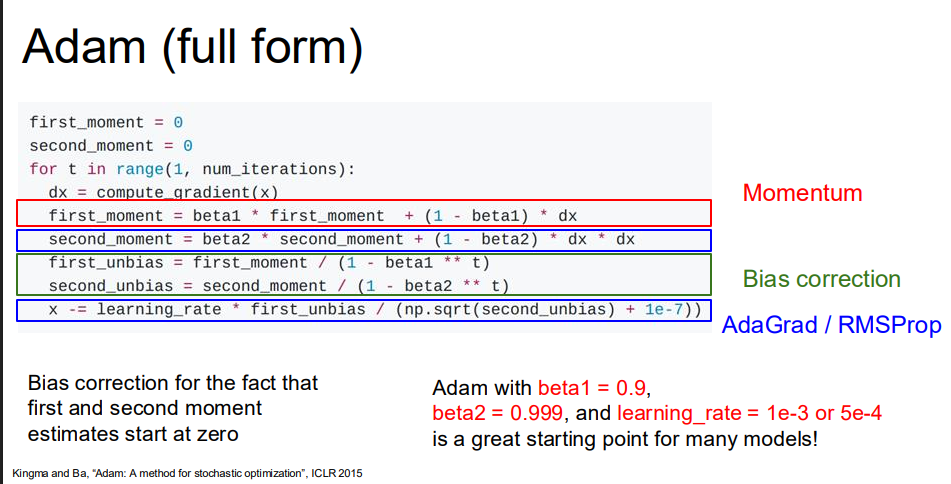
Momentum SGD와 RMSProp의 기법을 합친 알고리즘으로, 오늘날 가장 많이 사용되는 최적화 기법이다.
- Momentum: Gradient의 방향을 누적하여 관성을 부여 (1차 모멘트)
- RMSProp: Gradient의 제곱을 누적하여 방향별 Learning Rate를 조절 (2차 모멘트)
1차 모멘트 (Momentum)
\[m_t = \beta_1 \cdot m_{t-1} + (1 - \beta_1) \cdot \nabla_W L\]2차 모멘트 (RMSProp)
\[v_t = \beta_2 \cdot v_{t-1} + (1 - \beta_2) \cdot (\nabla_W L)^2\]Bias Correction
Momentum과 RMSProp의 계산식은 거의 동일한데, 학습 초기에는 누적된 값이 거의 없어 $m_t$, $v_t$ 모두 0에 가깝게 되고, 이로 인해 업데이트 시 비정상적으로 큰 Step을 뛰게 될 수 있다.
이를 보정하기 위해 $1 - \beta^t$로 나누어주는 Bias Correction을 적용한다. 학습 초기($t$가 작을 때)에는 $\beta^t$가 1에 가까워 보정 효과가 크고, 학습이 진행될수록 $\beta^t$가 0에 수렴하면서 보정의 영향이 사라진다.
\[\hat{m}_t = \frac{m_t}{1 - \beta_1^t}, \quad \hat{v}_t = \frac{v_t}{1 - \beta_2^t}\] \[W \leftarrow W - \eta \cdot \frac{\hat{m}_t}{\sqrt{\hat{v}_t} + \epsilon}\]| 기호 | 의미 | 일반적인 기본값 |
|---|---|---|
| $m_t$ | Gradient의 이동 평균 (1차 모멘트) | - |
| $v_t$ | Gradient 제곱의 이동 평균 (2차 모멘트) | - |
| $\beta_1$ | 1차 모멘트 감쇠 계수 | 0.9 |
| $\beta_2$ | 2차 모멘트 감쇠 계수 | 0.999 |
| $\eta$ | Learning Rate | $10^{-3}$ |
| $\epsilon$ | 0으로 나누는 것을 방지하기 위한 작은 값 | $10^{-8}$ |
+) AdamW
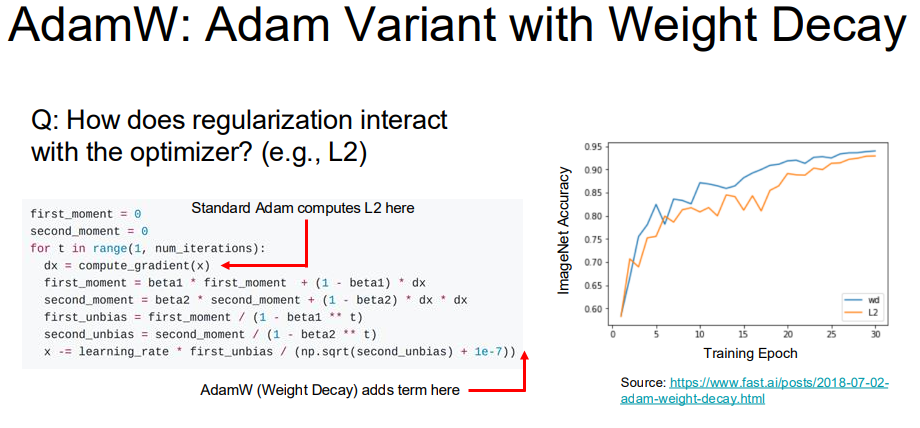
기존 Adam에서 L2 Regularization을 적용하면, 정규화 항이 Gradient에 포함된 채로 1차/2차 모멘트 계산에 들어간다. 이렇게 되면 Adaptive Learning Rate(√v_t로 나누는 부분)가 Data Loss의 Gradient뿐만 아니라 Regularization 항까지 함께 스케일링해버린다.
AdamW는 Weight Decay를 Gradient 계산과 분리하여, 파라미터 업데이트 단계에서 직접 적용한다.
\[W \leftarrow W - \eta \cdot \left( \frac{\hat{m}_t}{\sqrt{\hat{v}_t} + \epsilon} + \lambda W \right)\](Weight Decay $\lambda W$를 업데이트 시 별도로 적용. $\lambda W$ 는 L2정규화 항의 미분 결과)
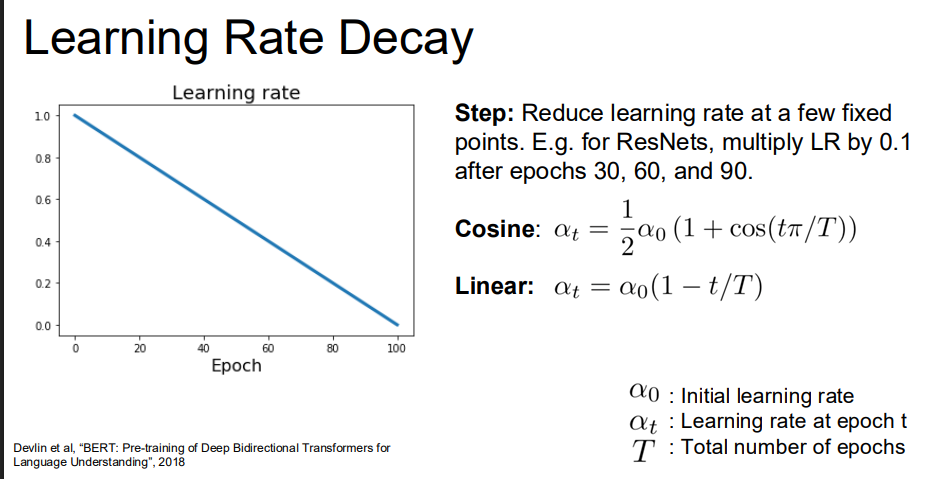
4. Learning Rate Scheduling
전체 학습 과정 동안 반드시 같은 Learning Rate를 유지할 필요는 없으며, 오히려 이를 조절하는 것이 좋은 방법이다. 보통 학습이 진행될수록 LR을 감소시켜 Loss의 최소 지점 근처에서 수렴할 수 있도록 한다.
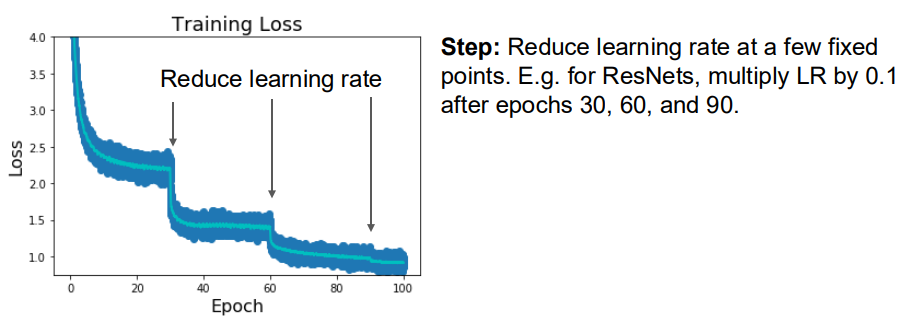
4.1 Step Decay
고정된 학습 반복 횟수(Epoch)마다 Learning Rate를 일정 비율로 줄이는 방식이다. (ResNet 등에서 사용)
4.2 Cosine Decay
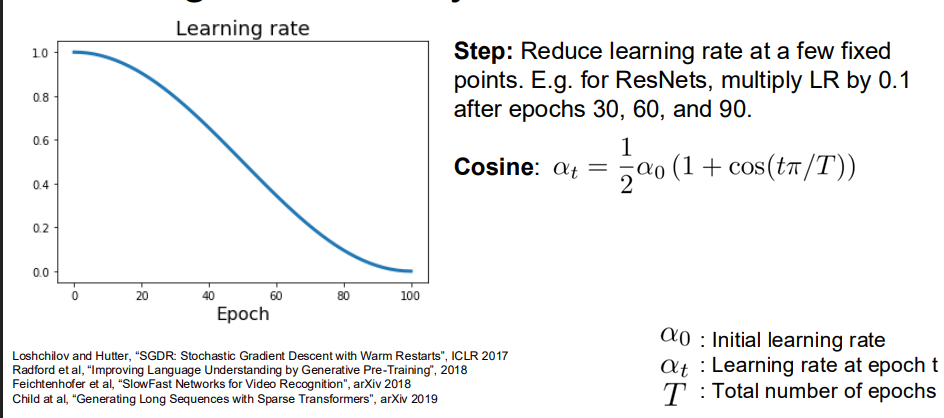
Learning Rate를 코사인 함수의 곡선을 따라 부드럽게 감소시키는 방식이다. 초반에는 천천히 감소하다가 중반에 빠르게 감소하고, 후반에 다시 천천히 감소하는 특성을 가진다.
4.3 Linear Decay
Learning Rate를 학습이 진행됨에 따라 선형적으로 균일하게 감소시키는 방식이다.
4.4 Linear Warmup
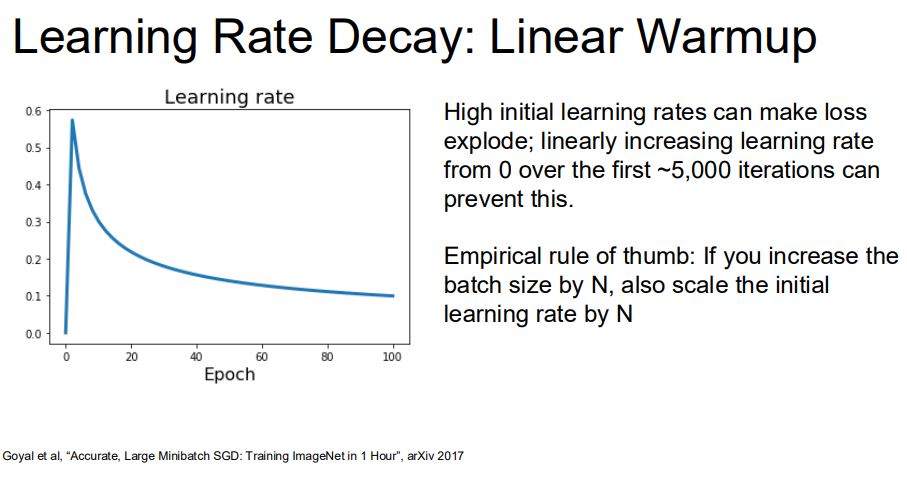
초기부터 큰 Learning Rate를 사용하면 학습이 불안정할 수 있다. Linear Warmup은 학습 초기에 LR을 0에서 시작하여 목표 LR까지 점점 증가시켜 초기 학습의 안정성을 확보한다.