hemisus

1. Activation Function
선형 연산만으로 신경망을 구성하면 여러 개의 선형층을 쌓더라도 결국 하나의 선형층과 동일하게 표현된다. 이는 기존에 Linear Classifier와 마찬가지로 선형적으로 구분 가능한 문제만 해결할 수 있으며, 복잡한 비선형 관계를 학습할 수 없다.
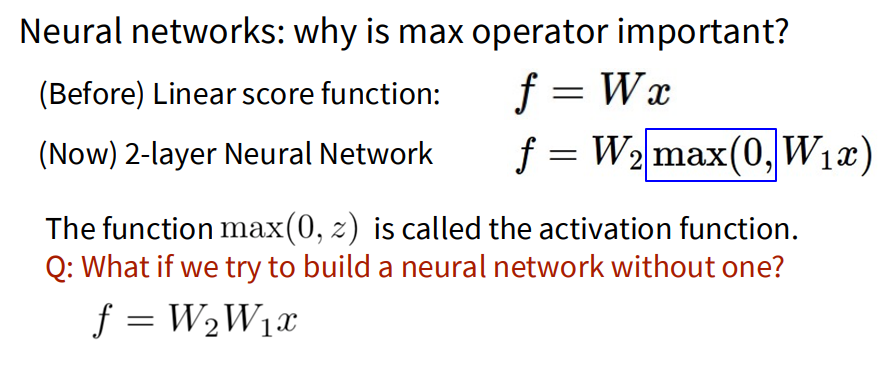
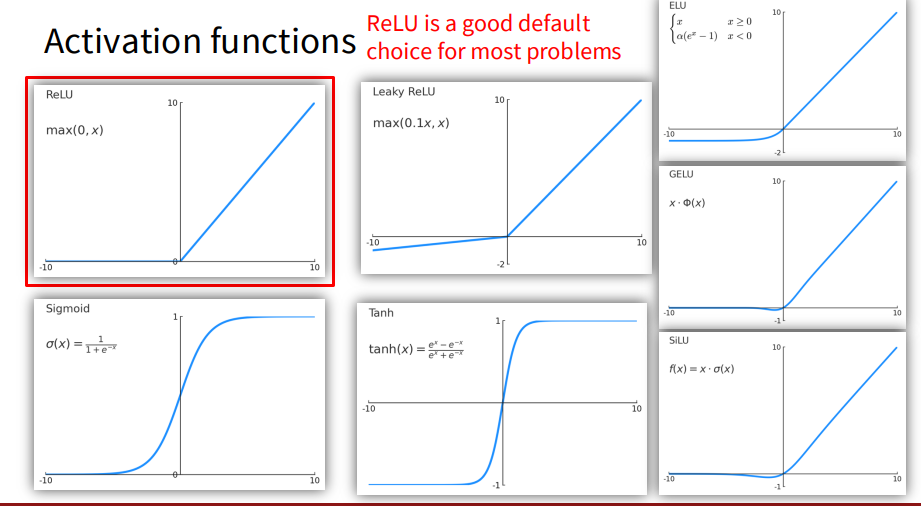
이 한계를 극복하기 위해 활성화 함수(Activation Function) 를 사용한다. 활성화 함수는 각 층의 출력에 비선형성을 추가해주며, 일반적으로 신경망은 선형 층과 활성화 함수를 번갈아 쌓는 구조로 이루어진다.
또한, 한 층의 모든 뉴런이 다음 층의 모든 뉴런과 연결된 구조를 Fully Connected Layer(Dense Layer) 라고 한다.
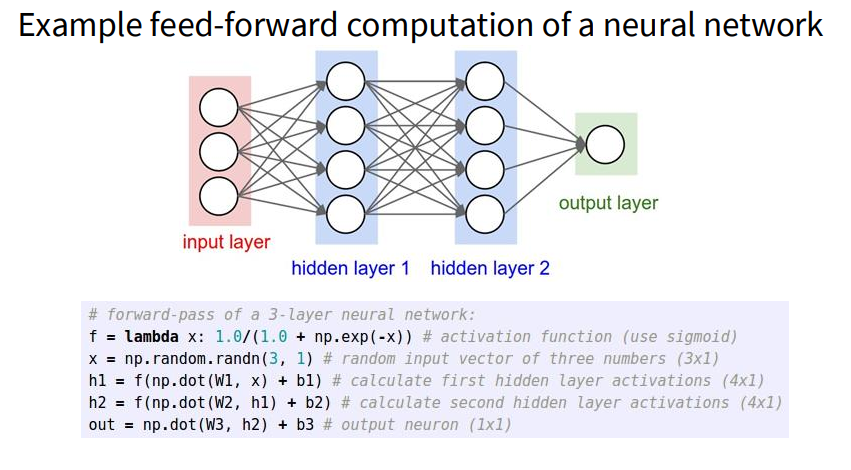
대표적인 활성화 함수로는 ReLU, Sigmoid, tanh 등이 있으며, 각 함수의 세부적인 특징과 장단점은 이후 강의에서 다뤄질 예정이다.
2. Backpropagation
이전 강의에서 다룬 optimizer가 loss의 gradient를 이용해 파라미터를 업데이트 하는 역할을 했다면, 역전파(Backpropagation)는 딥러닝에서 각 파라미터에 대한 gradient를 실제로 계산하는 표준적인 방법이다.
역전파에 대해 본격적으로 다루기 전에, 강의에서는 신경망 구조를 계산 그래프(Computational Graph) 형태로 나타낸다.
Computaional Graph
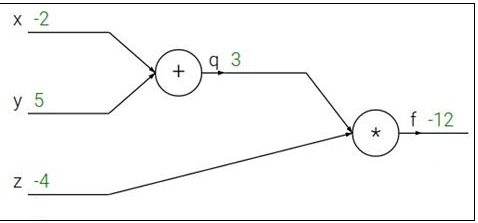
Computational Graph는 계산의 구조를 node와 edge로 나타낸 것으로, 노드에는 연산을 표기하고 엣지에는 연산 결과를 화살표와 함께 표시한다.
이로써 전체 연산 구조를 시각화할 수 있음과 동시에, 특정 부분의 지역적인 계산에만 집중할 수도 있다.
역전파의 원리
우리가 역전파를 하는 목적은 Loss를 최소화 시키기 위해, 모델의 파라미터(가중치W나 편향b)를 어느 방향으로 얼마나 조정해야 하는지 알아내기 위함이다. 이를 식으로 나타내보면 Loss L에 대한 W의 편미분으로 나타낼 수 있다.
\[∂L/∂W\]이때, 딥러닝 모델은 복합적인 여러 수학적 연산의 결합물이다. 단순히 L을 W에 대해 편미분하는 것은 간단하지만, 조정해야할 파라미터가 Loss에서 여러 단계의 연산을 거쳐야만 접근 가능한 경우도 있다. 이를 연쇄법칙(Chain Rule)을 통해 loss에서부터의 변화량을 모델의 모든 노드에까지 전파할 수 있다.
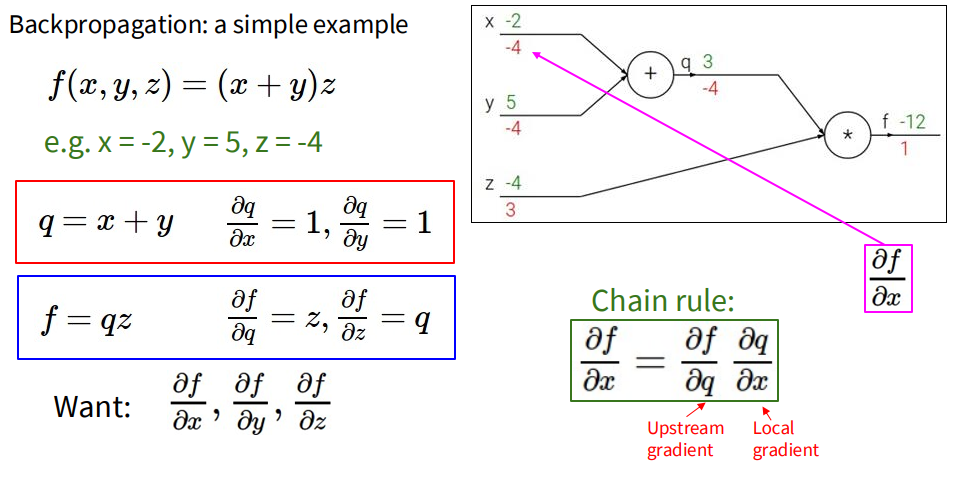
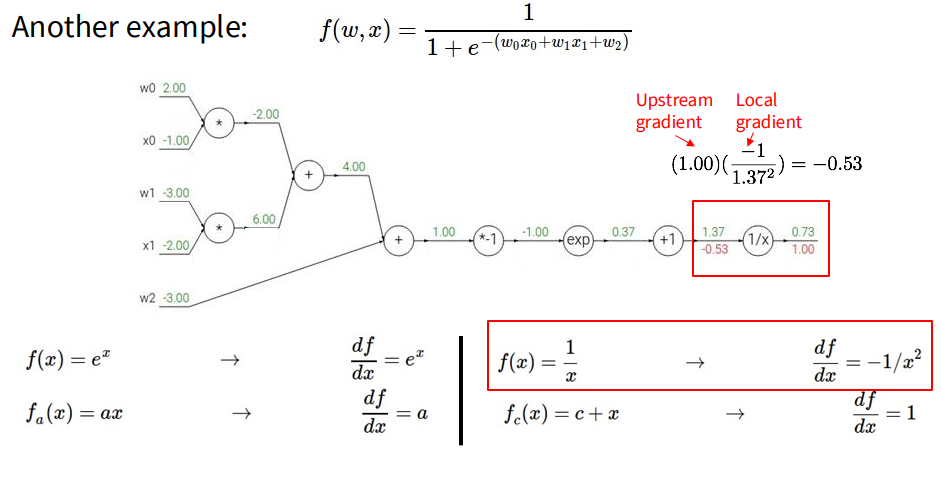
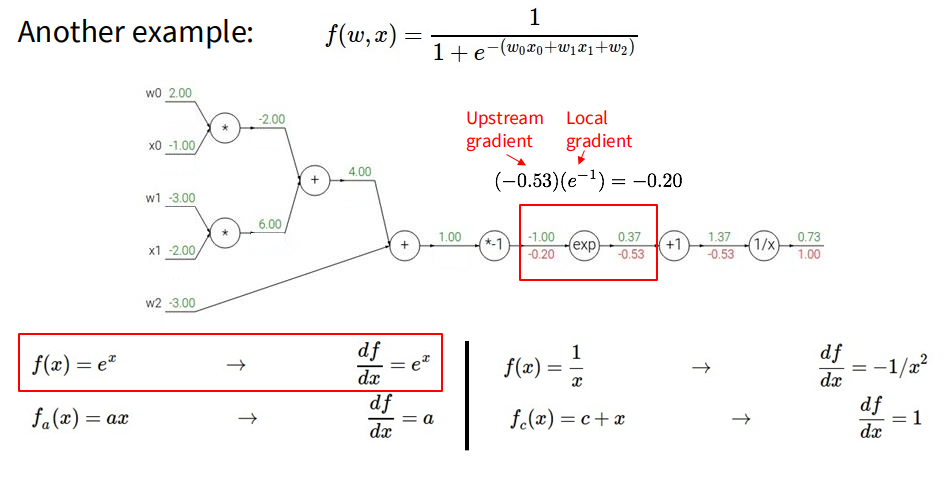
위의 슬라이드를 보면 초록색 숫자는 순전파 결과값이고, 빨간색 숫자가 각 노드의 gradient이다.
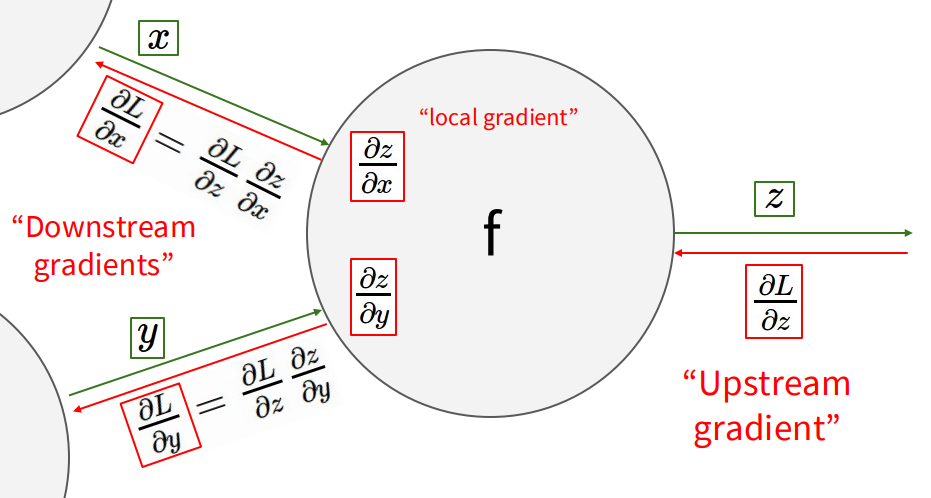
이때, 위의 계산 그래프를 보다시피 역방향으로 gradient를 구할때 전체 연산을 처음부터 끝까지 풀어서 미분할 필요가 없다. 자신의 상위 노드(upstream)에서 전달된 gradient에 자신의 연산에 대한 local gradient를 곱하기만 하면, 해당 노드의 gradient를 구할 수 있다.
- 지역 그래디언트(Local Gradient): 현재 노드의 연산에 대한 미분값
- 상류 그래디언트(Upstream Gradient): 현재 노드보다 출력(Loss) 쪽에 가까운, 이미 계산된 gradient
- 하류 그래디언트(Downstream Gradient): 현재 노드보다 입력 쪽에 가까운 노드의 gradient
Details
PyTorch와 같은 라이브러리의 autograd도 이와 동일한 방식으로 동작한다. 연산의 종류에 따라 gradient를 구하는 규칙이 미리 정의되어 있으니, 그 값을 downstream으로 계속 전달하고 누적하는 방식이다.
대표적인 두 연산을 예시로 보면:
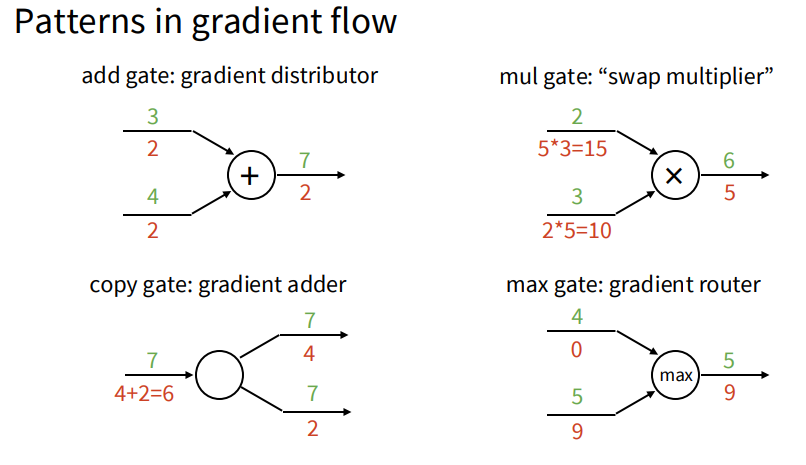
- 덧셈 f(x) = c + x에서 x에 대한 미분은 1이다. 따라서 downstream으로는 1 × upstream gradient, 즉 upstream gradient를 그대로 전달한다.
- 곱셈 f = a × b에서 ∂f/∂a = b, ∂f/∂b = a이다. 따라서 각각 b × upstream gradient, a × upstream gradient를 downstream으로 전달한다.
3. Backpropagation in Tensor
앞서 원리 설명을 위해 역전파 대상이 scalar였다면, 실제 파라미터는 vector, matrix와 같은 n-dimensional array일 것이다. 기본적인 원리는 동일하나, scalar에서의 미분 대신 야코비안 행렬(Jacobian Matrix) 이 local gradient로 등장한다.
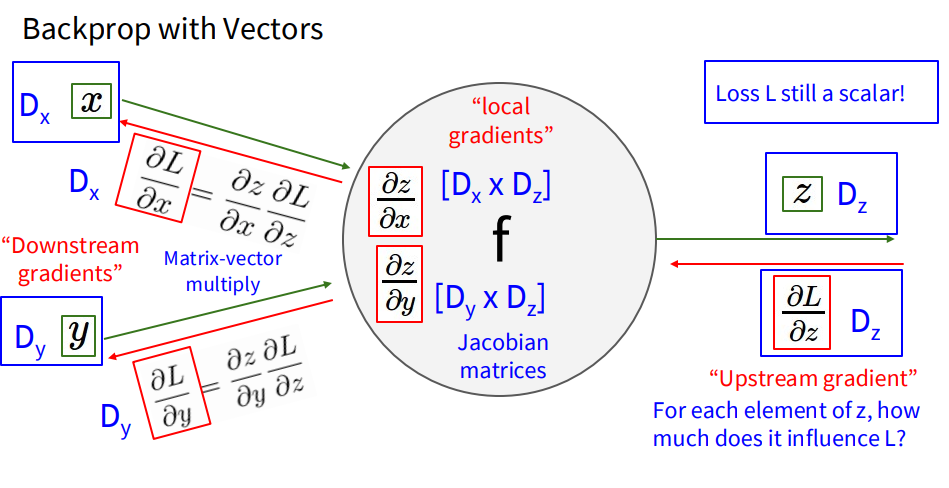
야코비안 행렬 J의 (i, j) 원소는 ∂y_i / ∂x_j로 정의된다. 그런데 ReLU와 같은 원소별 연산(element-wise operation) 에서는 출력 y_i가 오직 입력 x_i에만 의존하므로 i ≠ j인 경우 ∂y_i / ∂x_j = 0이 된다. 즉 야코비안이 대각 행렬(diagonal matrix) 이 되어 대부분의 원소가 0인 sparse matrix가 된다.
파라미터 수가 많아질수록 야코비안 행렬의 크기도 급격히 커지기 때문에, 이를 명시적으로 구성하는 것은 메모리와 연산 측면에서 매우 비효율적이다. 따라서 실제로는 야코비안 행렬을 직접 만들지 않고, upstream gradient와의 곱 결과만 원소별 곱셈으로 바로 계산하는 방식을 사용한다.
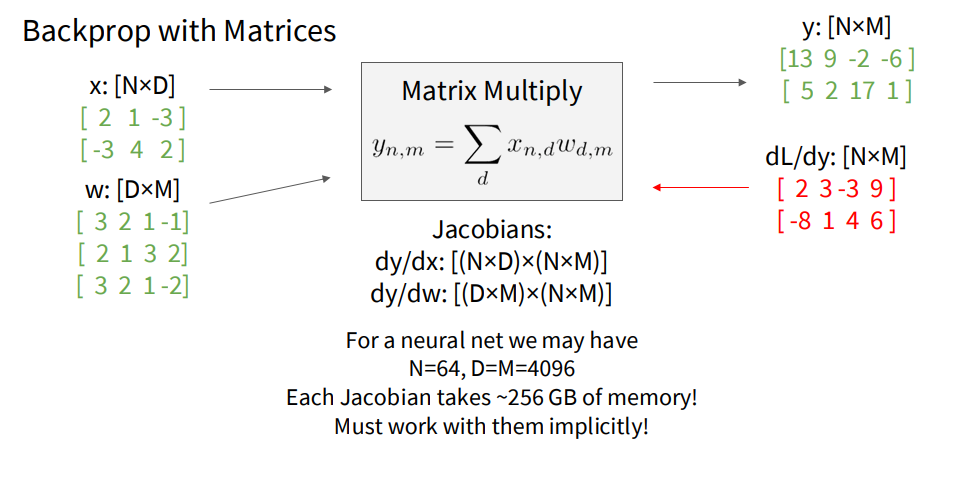
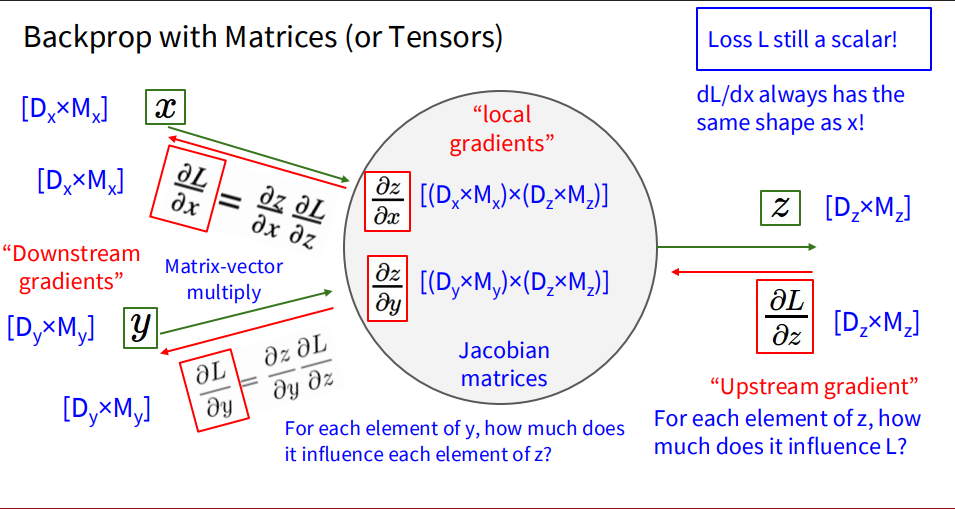
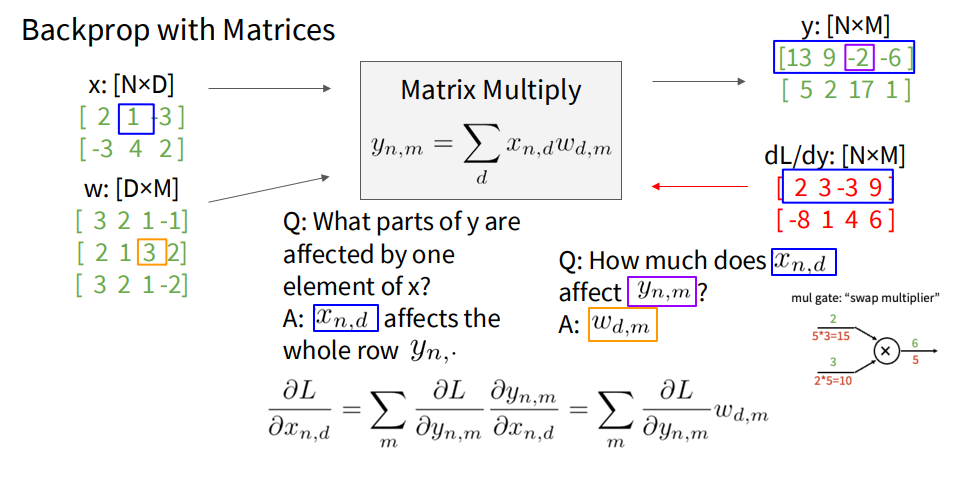
Backprop with Matrices
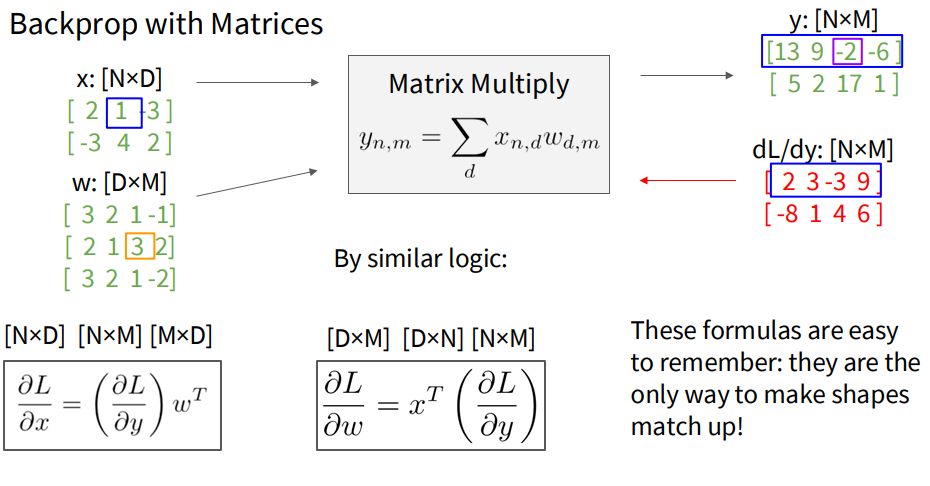
행렬 곱셈 y = xw (x: [N×D], w: [D×M], y: [N×M])의 역전파를 살펴보면, upstream gradient dL/dy의 shape은 y와 동일하게 [N×M]이다.
각 파라미터에 대한 gradient는 다음과 같이 계산된다:
\[\frac{\partial L}{\partial x} = \frac{\partial L}{\partial y} w^T \quad \text{([N×D] = [N×M] × [M×D])}\] \[\frac{\partial L}{\partial w} = x^T \frac{\partial L}{\partial y} \quad \text{([D×M] = [D×N] × [N×M])}\]이 공식은 외울 필요 없이, 결과의 shape이 원래 파라미터의 shape과 일치하도록 행렬의 순서와 전치(transpose)를 맞추면 자연스럽게 유도된다. “the only way to make shapes match up!”