hemisus

딥러닝 아키텍처가 주목받기 이전에는, 이미지 분류와 같은 대부분의 task에서 Feature Extraction을 사람이 직접 수행하였다. 분류에 중요하다고 판단되는 feature를 직접 정의하는 코드를 작성하고, 이를 벡터와 같은 수치 배열로 변환한 뒤 Linear Classifier 등의 분류기에 입력으로 사용하는 방식이었다.
반면 오늘날의 딥러닝 아키텍처는, 이러한 Feature Extraction 과정조차 모델이 학습을 통해 스스로 수행한다. 이 방식이 사람이 직접 feature를 설계하는 것보다 더 정확할 뿐 아니라, 사람이 미처 포착하지 못한 feature까지 찾아낼 수 있다는 것이 핵심 아이디어다.
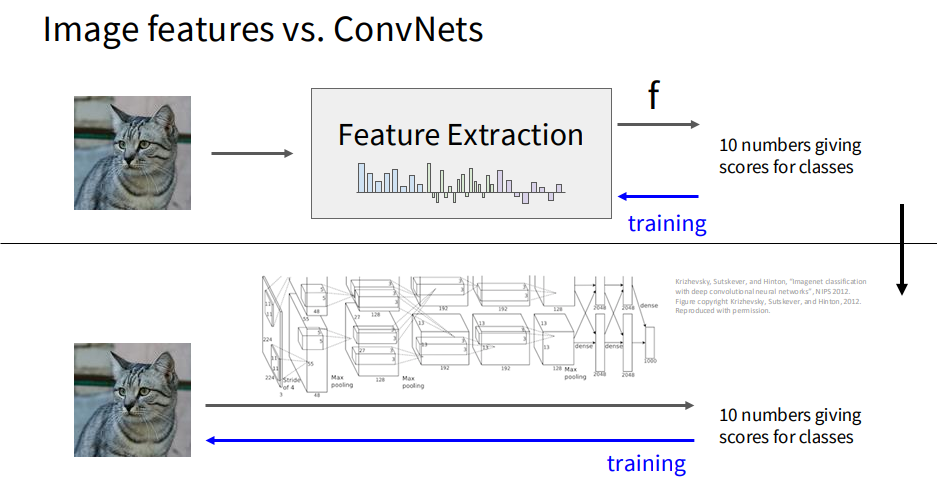
실제로 이 아이디어는 옳았고, 지난 십여 년간 End-to-End Learning 기반의 Neural Network가 다양한 분야에서 뛰어난 성능을 보여줬다. 이번 강의에서는 이미지 분류 task에서 이러한 feature 학습을 가능하게 하는 CNN(Convolutional Neural Network) 구조에 대해 다룬다.
1. CNN: Convolutional Neural Network
앞선 강의에서 이미지를 모델의 입력으로 사용할 때, 이를 1차원 벡터로 flatten하는 과정에서 이미지의 공간적 구조(spatial structure)가 손실되는 문제가 있었다. CNN은 이 문제를 해결하면서 이미지 분류에서 훨씬 뛰어난 성능을 보이는 아키텍처이다.
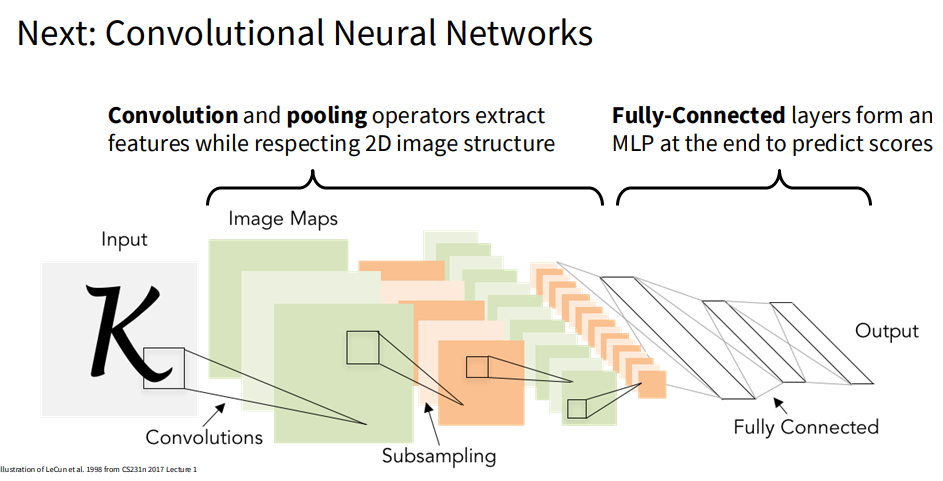
CNN 아키텍처는 기본적으로 합성곱층(Convolutional Layer) 과 풀링층(Pooling Layer), 그리고 활성화 함수가 번갈아 쌓이는 구조로 이루어진다.
Fully Connected Layer와 Template Matching
Fully Connected Layer에서의 dot product는 본질적으로 template matching이다. 두 벡터가 같은 방향을 가리킬수록 내적값이 커지고, 직교하면 0에 가까워지기 때문이다.
Fully Connected Layer의 핵심을 정리하면 다음과 같다:
- 가중치 행렬은 일종의 template의 집합(bank of templates) 이다.
- 각 template은 입력과 동일한 크기(size)를 가진다.
- 출력은 각 template과 입력 간의 matching score이다.
Convolutional Layer
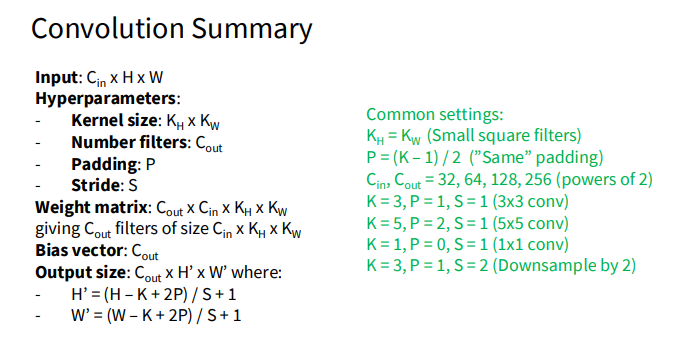
CNN은 이러한 template matching과 filter bank의 개념을 Convolutional Layer로 일반화한다. Fully Connected Layer와의 핵심적인 차이는 두 가지다:
- 필터가 입력 size와 같을 필요가 없다.
- 이미지를 flatten하지 않는다. 더이상 이미지를 펼치지 않고 입력 이미지의 공간적 구조 (C × H × W) 를 그대로 유지한다.
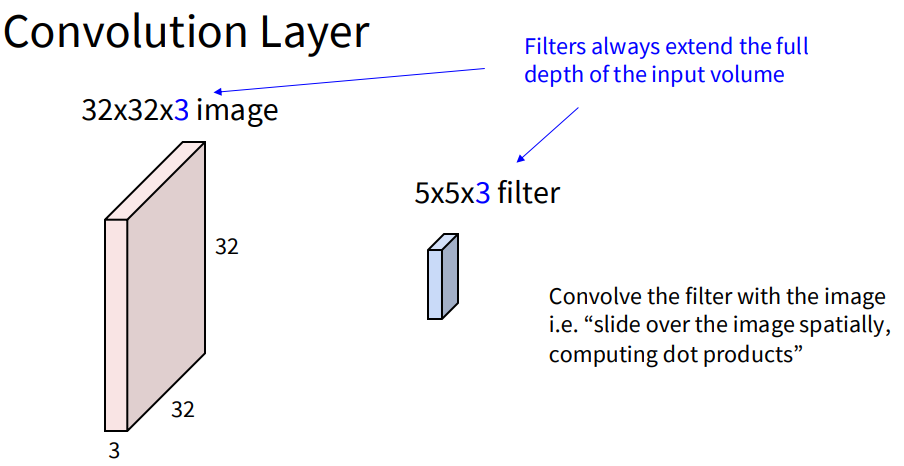
필터(filter, 혹은 kernel) 는 작은 크기의 sub-image(가중치 텐서)로, 입력 이미지 전체를 슬라이딩 윈도우(sliding window) 방식으로 이동하며 각 위치에서 dot product를 수행한다. 이때 필터의 채널 수는 입력 이미지의 채널 수와 반드시 일치해야 한다.
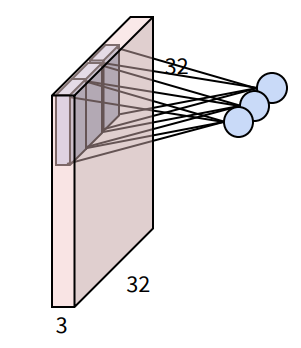
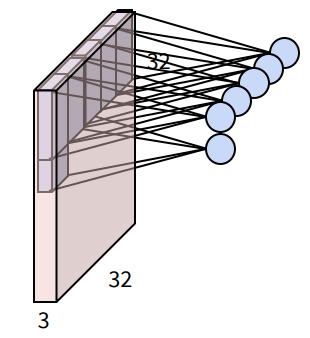
이러한 필터와 이미지의 부분 내적을 모든 위치에 대해 반복하면 2D activation map이 생성되며, 이 map의 각 값은 이미지의 해당 위치가 필터 패턴과 얼마나 일치하는지를 나타낸다.
필터를 여러 개 사용하면 각 필터마다 하나의 activation map이 생성될 것이고, 이를 쌓으면 최종적으로 (필터 수 × H’ × W’) 크기의 출력 텐서가 만들어진다. 이때 필터의 수가 곧 출력의 채널 수가 된다.
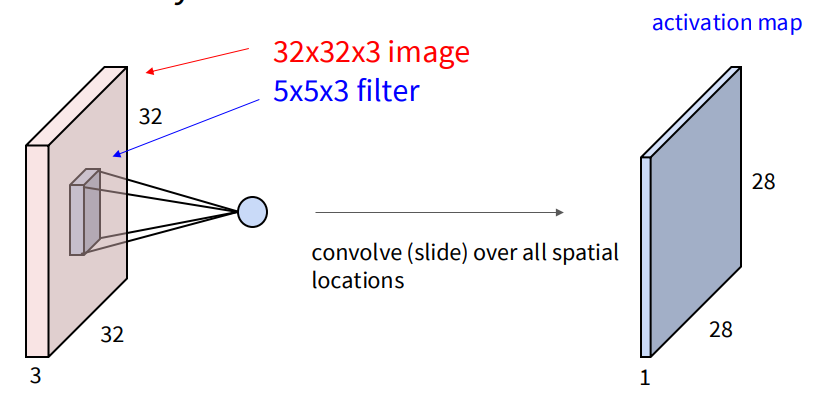
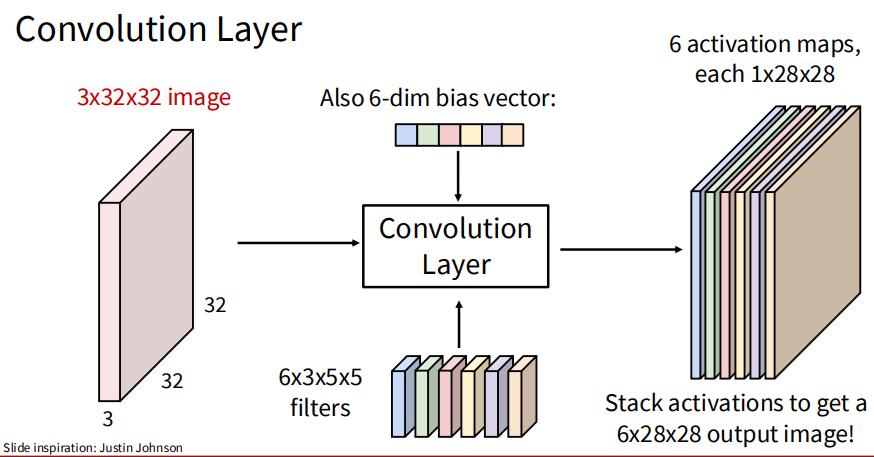
정리하면, Convolutional Layer의 출력은 activation map이며, 학습을 통해 조정되는 값은 필터의 가중치이다. CNN은 이러한 합성곱층(선형 연산) 과 활성화 함수 또는 풀링층(비선형 연산) 이 번갈아 쌓이는 구조이다.
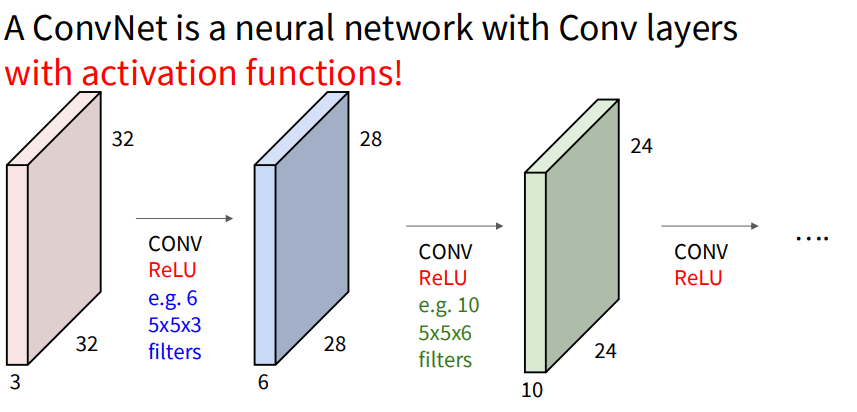
What do Conv filters learn?
필터가 직접 경사하강법을 통해 학습한 결과는 이미지의 특징을 추출할 수 있는 값들일 것이다. 실제로 AlexNet의 첫번째 layer의 filter를 확인해보면 다음과 같다.
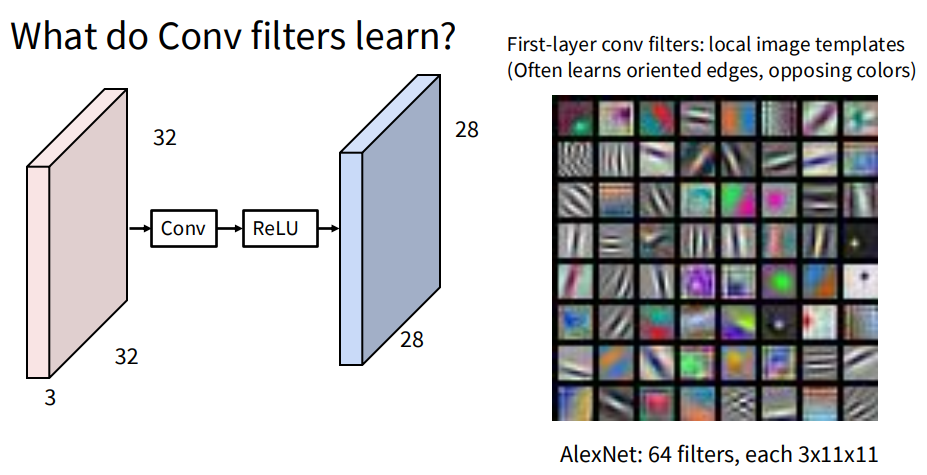
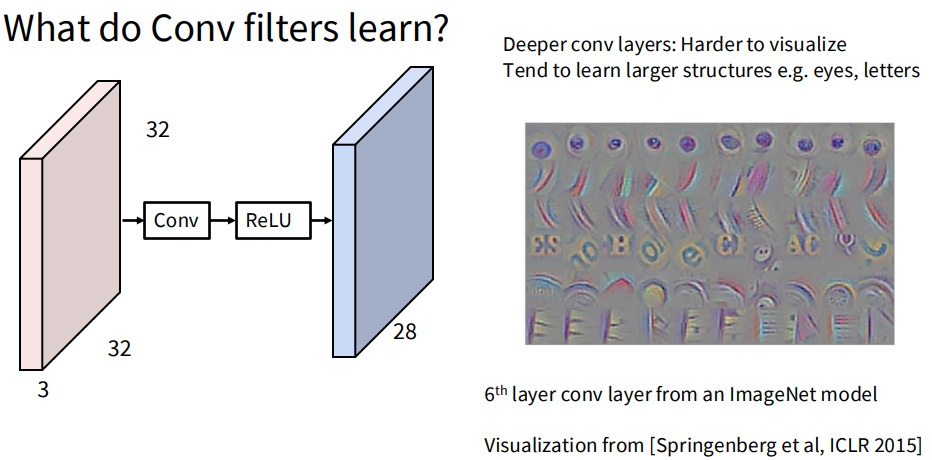
이미지를 학습한 대부분의 CNN에서 앞쪽 레이어는 특정 방향의 edge, 색상 대비와 같은 저수준(low-level) 특징을 학습하고, 깊은 레이어로 갈수록 이러한 저수준 특징들이 조합되어 텍스처, 패턴, 물체의 일부나 전체와 같은 고수준(high-level) 특징을 학습하게 된다.
이렇게 모델이 데이터를 단순한 특징에서 점점 추상적인 특징을 학습하는 과정을 계층적 특징 학습(hierarchical feature learning)이라고 하며, CNN이 이러한 특성을 보이는 것은 각 필터의 수용 영역(receptive field)의 크기가 점점 넓어지기 때문이다.
Receptive Field
Receptive Field란 activation map의 한 픽셀이 영향을 받는 원본 입력 이미지의 영역을 말한다.
예를 들어 필터 크기가 3×3이라면, 1번째 레이어 activation map의 한 픽셀은 원본 이미지의 3x3의 정보를 담고 있을 것이다. 이때 그 다음 레이어는 이 activation map 위에서 또 3×3을 보는데, 해당 map이 이미 원본의 3x3을 담고 있으니 2번째 activaion map의 한 픽셀은 원본 이미지의 5×5 영역에 영향을 받는 것이다.
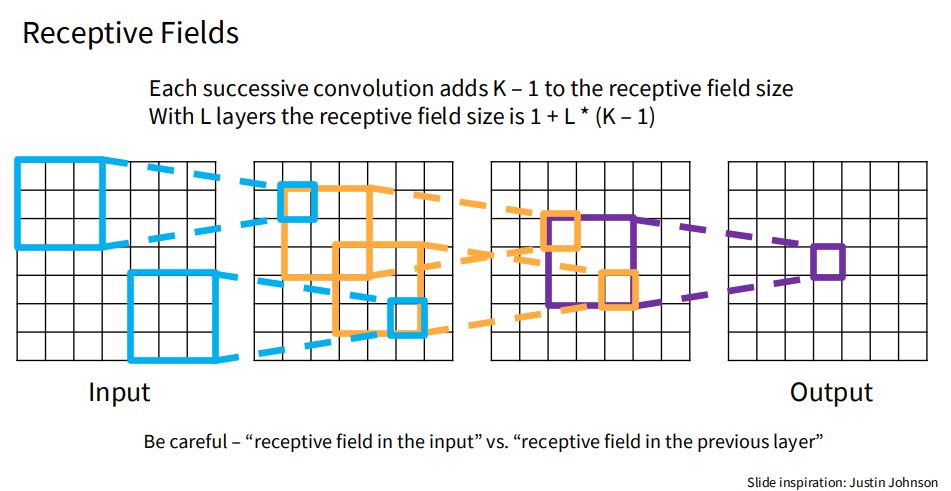
이렇게 레이어가 쌓일수록 receptive field는 점점 커져, $L$번째 레이어의 receptive field 크기는 대략 $1 + L*(필터 크기-1)$로 증가한다.
\[\text{Receptive Field Size} = 1 + L \times (K - 1)\]결국 깊은 레이어의 뉴런일수록 원본 이미지의 더 넓은 영역을 종합해서 하나의 값을 만들어내기 때문에, 자연스럽게 지역적인 특징보다 더 추상적인 특징을 학습하는 것이다.
한편, 필터들이 서로 다른 특징으로 수렴할 수 있는 이유는 학습 시작 시 필터가 서로 다른 값으로 랜덤 초기화되기 때문이다. 만약 모든 필터가 동일한 값으로 초기화된다면, 역전파 시 동일한 gradient를 받아 결국 같은 특징만을 학습하는 대칭 문제(Symmetry Problem) 가 발생한다.
Stride, Padding
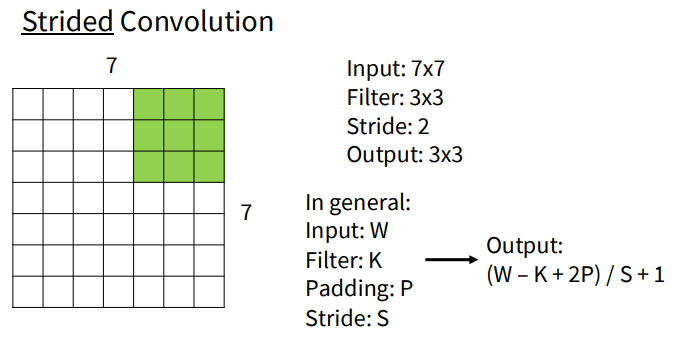
- Stride: 필터가 이미지(데이터) 위를 이동할 때의 이동 간격이다.
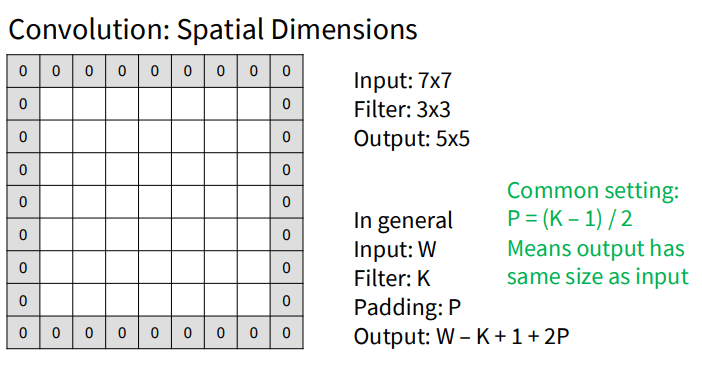
- Padding: 이미지의 가장자리를 특정 값(0)으로 채우는 것이며, 보통 합성곱 연산 후에도 이미지의 크기를 유지하고 싶을때 사용된다.
입력 크기 $W$, 필터 크기 $K$, 패딩 $P$, 스트라이드 $S$가 주어졌을 때, 출력 크기 $W’$는 다음과 같다:
\[W' = \frac{W - K + 2P}{S} + 1\]예를 들어 입력이 7×7, 필터가 3×3, Padding=0, Stride=1이면:
\[W' = \frac{7 - 3 + 0}{1} + 1 = 5\]출력은 5×5가 된다. Padding=1로 설정하면:
\[W' = \frac{7 - 3 + 2}{1} + 1 = 7\]입력과 동일한 7×7 크기가 유지된다.
Pooling
activation map의 크기를 줄이는데 stride를 크게하는 방법 외에도 Pooling을 사용한다. 합성곱과 비슷하게 kernel을 map위에서 슬라이딩하는데, 합성곱 대신 풀링의 종류에 따라 값을 계산한다.
대표적인 풀링 방식은 두 가지다:
- Max Pooling: kernel 영역 내의 최댓값을 취한다. 영역에서 가장 강한 신호만을 남김.
- Average Pooling: kernel 영역 내의 평균값을 취한다.
아래는 kernel 크기 2×2, stride=2로 Max Pooling을 수행하는 예시로, 출력 크기가 절반으로 줄어드는 것을 확인할 수 있다.
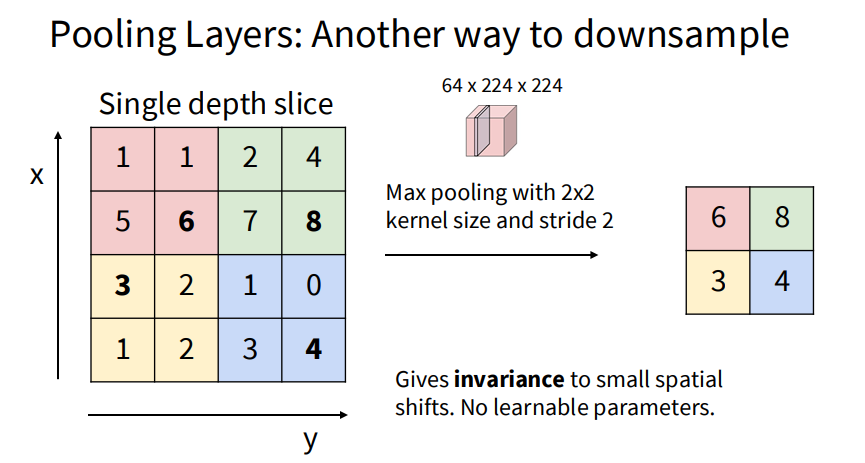
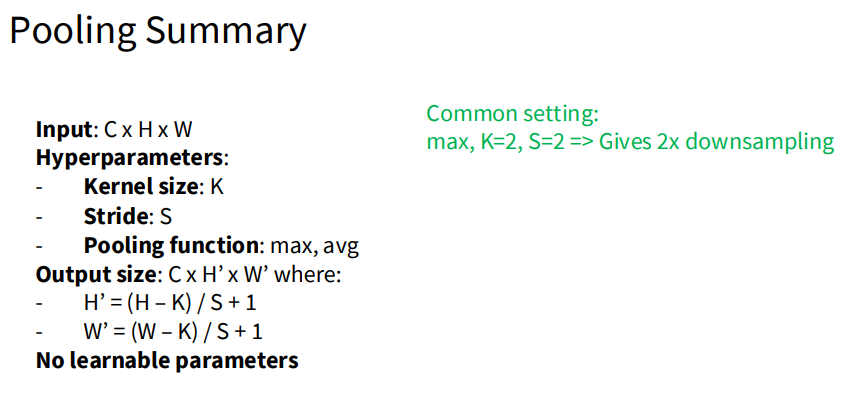
주의할 점은 Average Pooling은 합성곱과 마찬가지로 선형(linear) 연산인 반면, Max Pooling은 최댓값을 선택하는 비선형(non-linear) 연산이라는 점이다. 이 때문에 Max Pooling은 별도의 활성화 함수 없이도 비선형성을 추가하는 효과가 있다.
Translation Equivariance
Equivariance(등변성)은 입력에 변환을 가했을 때 출력도 동일한 변환이 적용되는 성질이다.
\[f(T(x))=T(f(x))\]입력 x를 먼저 변환하고 함수 f를 적용한 결과와, 함수 f를 먼저 적용하고 변환한 결과가 같다. 합성곱 연산은 같은 필터가 이미지의 모든 위치에 동일하게 적용(weight sharing)되기 때문에 사진처럼 개구리의 위치가 달라도 feature map에서 동일한 패턴이 이동한 위치에 그대로 나타난다.