hemisus

1. Recurrent Neural Network
순환 신경망(RNN)은 입력과 출력을 시퀀스 단위로 처리하는 모델이다. 기존의 Feed-Forward 신경망이 고정된 크기의 입력만 받을 수 있었던 것과 달리, 가변적인 크기의 입력을 받을 수 있고, 데이터의 “순서(Order)”와 “시간적 흐름(Time-step)”을 처리할 수 있는 것이 가장 큰 특징이다.
아래 슬라이드는 RNN의 유형을 입력, 출력의 갯수에 따라 분류한 것이다.
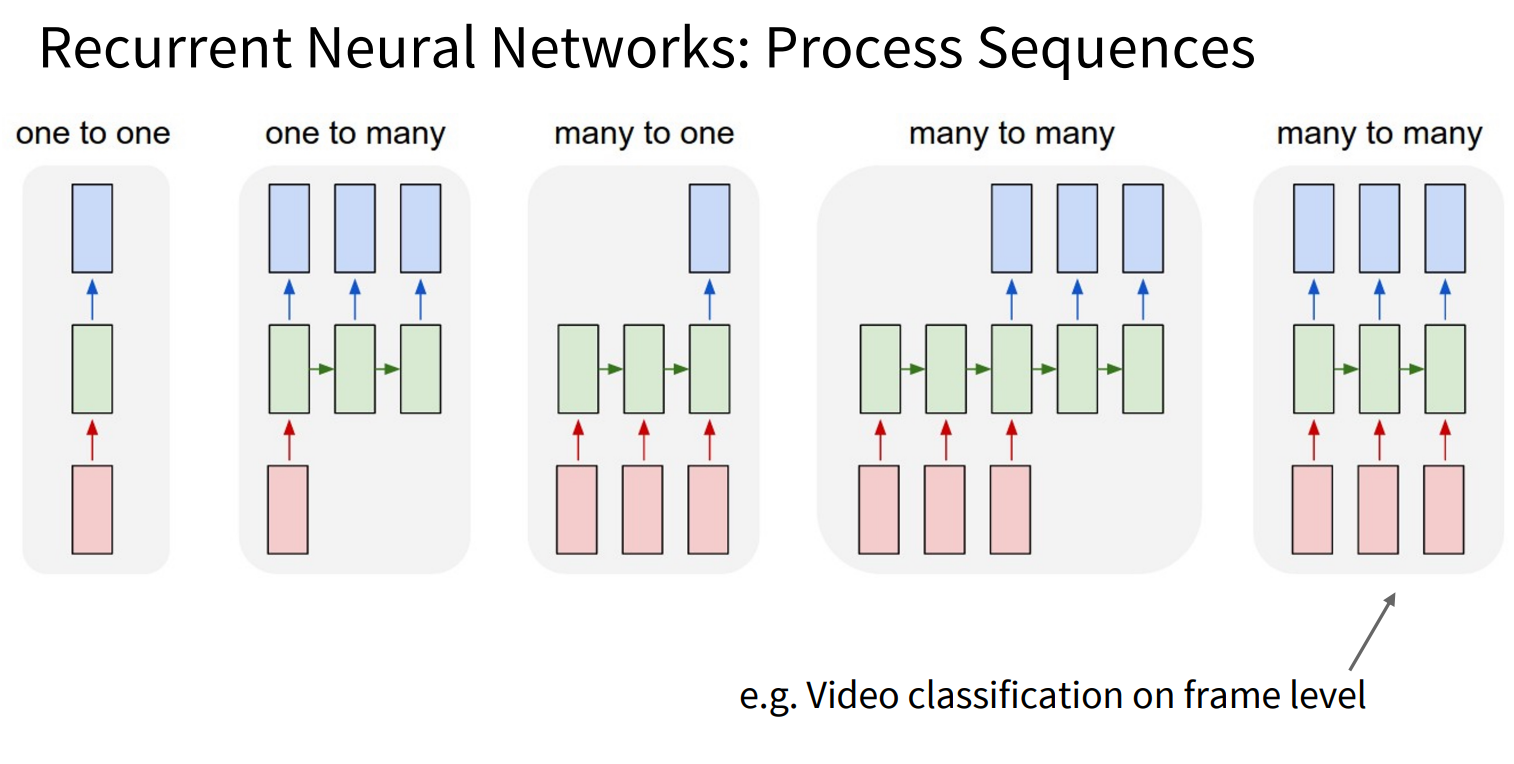
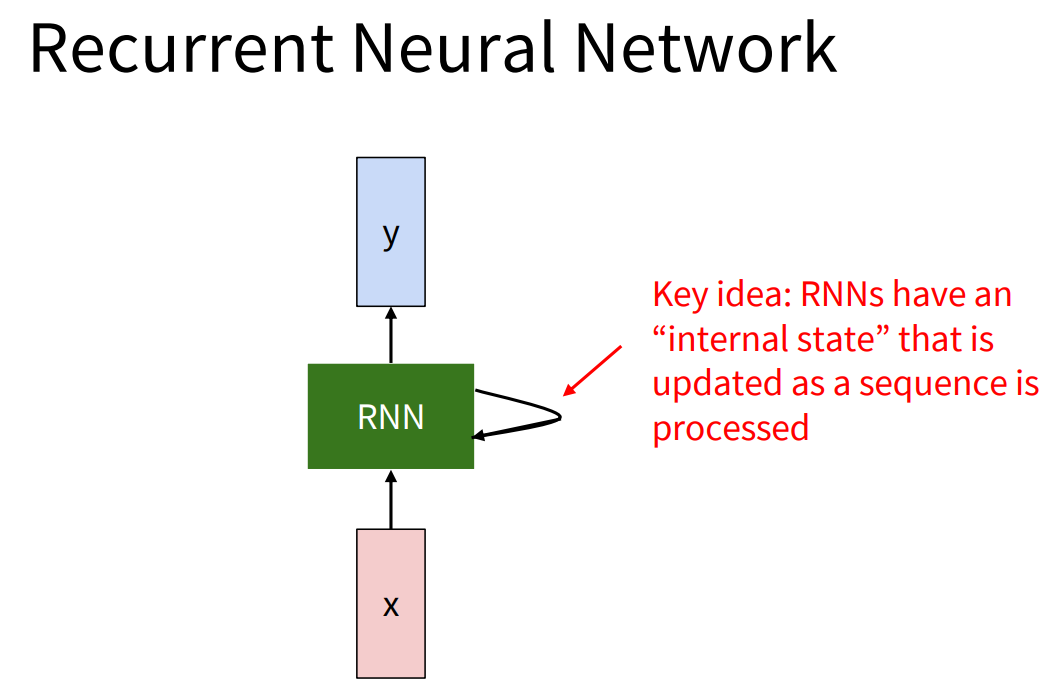
다른 신경망들과 마찬가지로 입력에 대해 가중치(Weight) 연산을 거쳐 출력을 내는 것은 동일하지만, RNN의 가장 큰 차이점은 은닉 상태(hidden state)라는 내부 메모리를 가진다는 점이다.
은닉 상태 $h_t$는 RNN 셀이 다음 시점 $t+1$의 자신에게 보내는 값으로, 해당 시점까지의 과거 정보들을 압축한 벡터(Vector)이다. 이를 현재 시점의 입력값 $x_t$와 함께 사용하여 새로운 결과를 계산한다.
Vanilla RNN의 수식
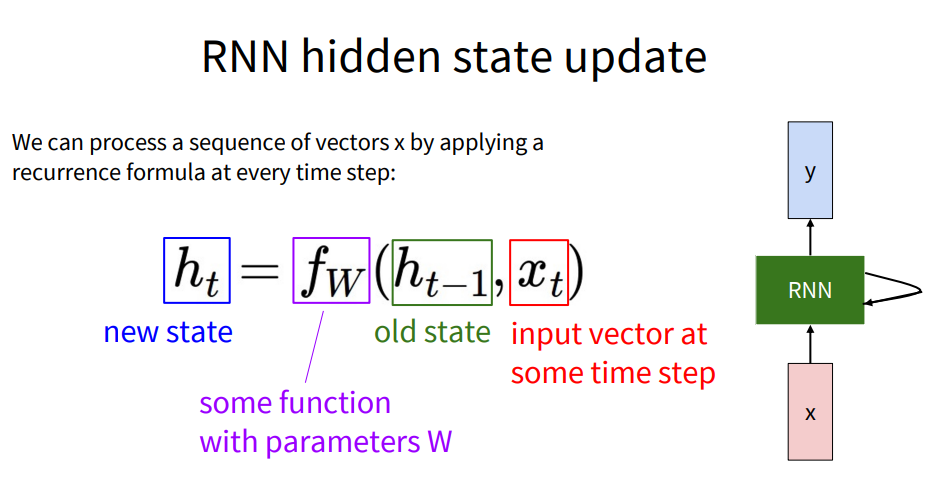
먼저, RNN의 hidden state update를 점화식으로 표현하면 다음과 같다.
\[h_t = f_W(h_{t-1}, x_t)\]함수 $f_W$는 파라미터(가중치) $W$를 가지며, 매 타임스텝마다 동일한 함수와 동일한 가중치가 재사용된다.
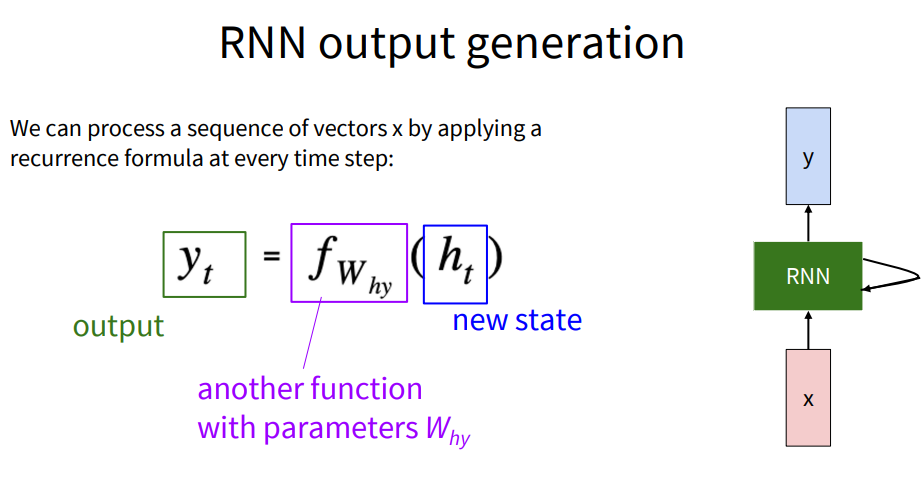
Hidden State가 아닌 실제 Output을 출력할때는 또 다른 가중치인 $W_{hy}$를 사용한다.
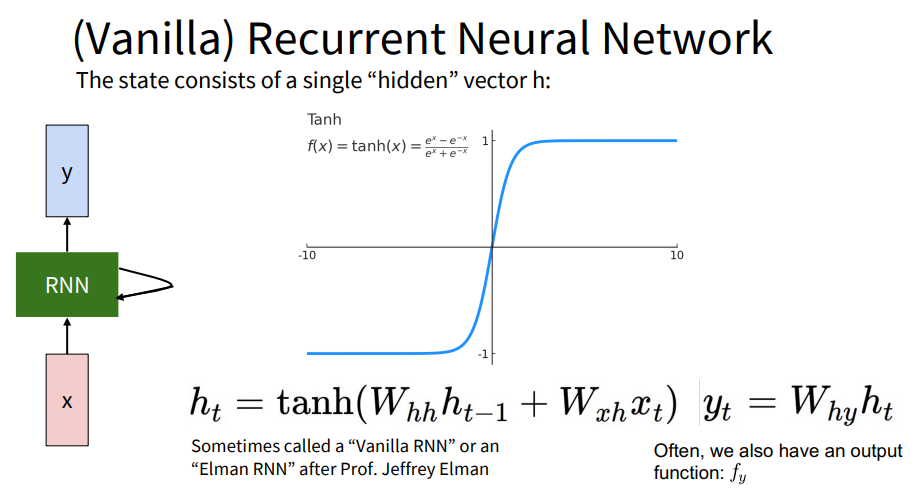
가장 기본적인 형태인 Vanilla RNN의 수식으로 전개하면 아래와 같다.
\[h_t = \tanh(W_{hh}h_{t-1} + W_{xh}x_t)\] \[y_t = W_{hy}h_t\]이전 상태의 정보 $h_{t-1}$와 현재의 입력 $x_t$가 각각의 가중치 행렬 $W_{hh}$, $W_{xh}$와 곱해지고, 이 두 값을 더한 뒤, 활성화 함수인( $\tanh$ )를 통과시켜 현재 시점의 은닉 상태 $h_t$를 업데이트한다.
Backpropagation through time (BPTT)
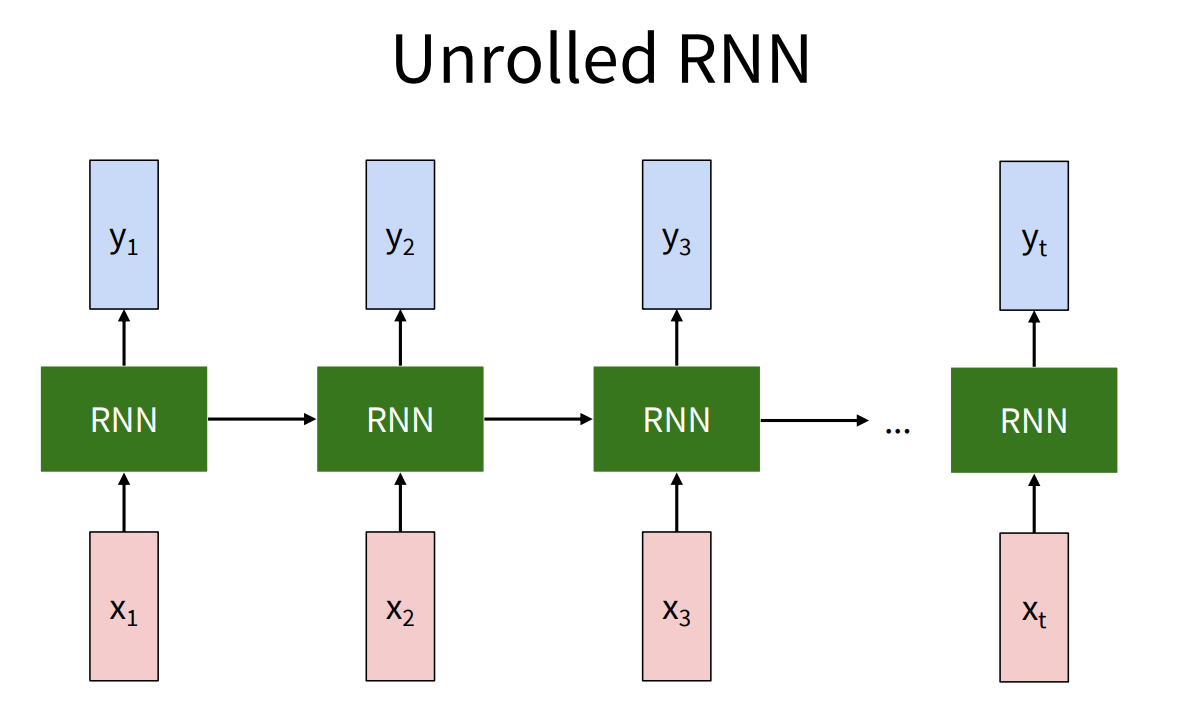
RNN은 시간 흐름에 따라 연산 과정을 펼쳐놓았을 때, 각 시점의 Loss를 이용하여 역전파를 통해 학습한다. 이처럼 시간의 흐름에 거슬러 올라가는 역전파를 Backpropagation Through Time (BPTT)라고 한다.
이후 설명은 Many to Many 유형을 기준으로 설명된다.
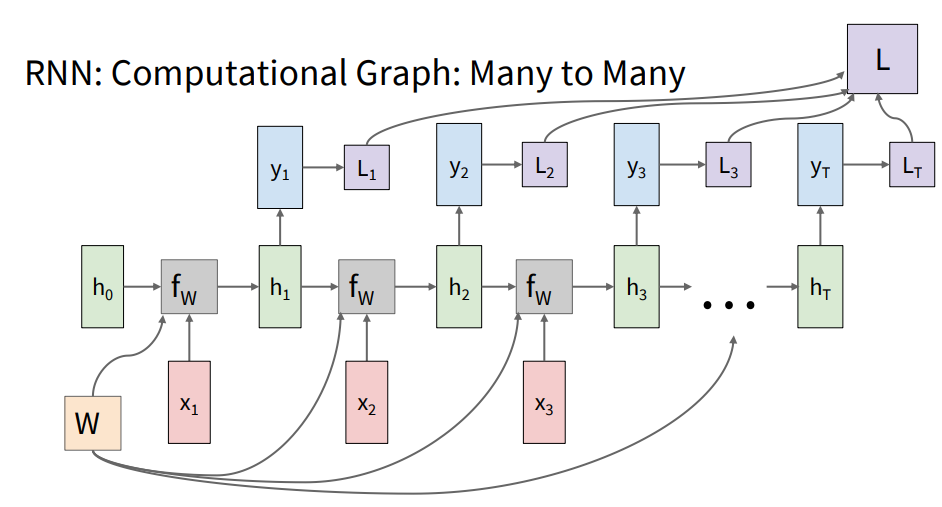
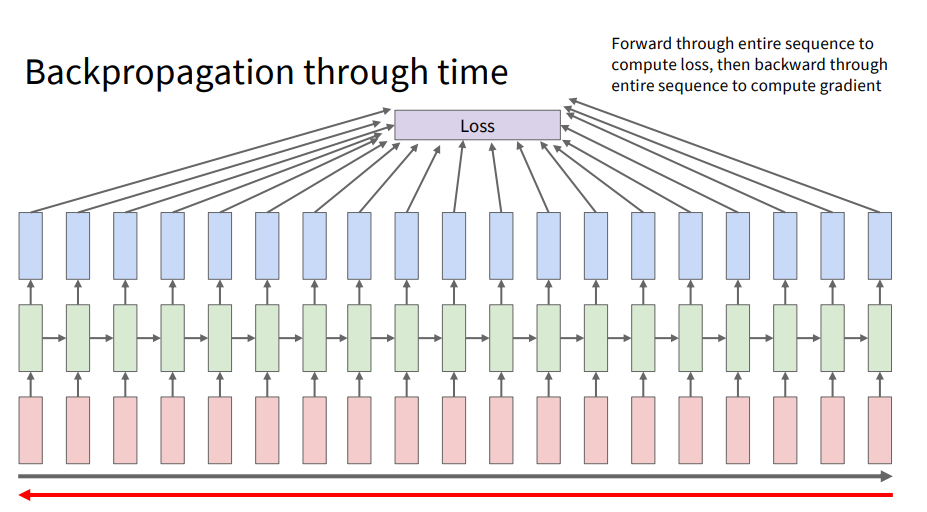
모든 시점의 출력에 대한 손실을 구해 더한 전체 손실 $L$을 기반으로, 매 시점마다 공유되는 가중치 $W$의 그래디언트를 누적하여 업데이트한다.
이때 핵심은 “모든 시점에서 동일한 가중치 행렬 $W$($W_{hh}, W_{xh}, W_{hy}$)가 공유된다”는 점이다.
일반적인 깊은 신경망(DNN)은 층(Layer)마다 서로 다른 가중치를 가지지만, RNN은 시간에 따라 펼쳐진 각 단계마다 완전히 똑같은 가중치 $W$가 사용된 상태이다. 다변수 함수의 연쇄 법칙에 의해, 동일한 변수 $W$가 여러 결과($L_1, L_2, \dots, L_T$)에 영향을 미쳤다면, 전체 그래디언트는 각 손실이 $W$에 미치는 그래디언트를 모두 더한 값이 된다.
\[\frac{\partial L}{\partial W} = \sum_{t=1}^{T} \frac{\partial L_t}{\partial W}\]나아가, 특정 시점 $t$의 손실 $L_t$가 가중치 $W$에 미치는 영향($\frac{\partial L_t}{\partial W}$)을 구하려면, 현재 시점 $t$뿐만 아니라 과거의 모든 시점($k=1, 2, \dots, t$)에서 $W$가 은닉 상태에 기여한 영향을 시간 역순으로 전부 거슬러 올라가며 곱하고 더해야 한다.
\[\frac{\partial L_t}{\partial W} = \sum_{k=1}^{t} \frac{\partial L_t}{\partial y_t} \frac{\partial y_t}{\partial h_t} \frac{\partial h_t}{\partial h_k} \frac{\partial h_k}{\partial W}\]계산 및 업데이트 과정 요약:
- 시퀀스의 맨 마지막 시점 $T$부터 시작하여 과거 방향(왼쪽)으로 역전파를 진행.
- 각 시점 $t$에서 역전파되어 내려오는 그래디언트는 두 갈래로 나뉜다:
- 하나는 아래로 내려가 입력층의 가중치에 대한 그래디언트를 구하고,
- 다른 하나는 이전 시점 $t-1$의 은닉 상태($h_{t-1}$) 방향으로 흘러감
- 이렇게 시간의 역방향으로 흘러가는 그래디언트들이 각 시점의 가중치 $W$ 노드를 지나칠 때마다, 해당 위치에서 계산된 그래디언트 값들을 각각의 가중치 행렬( $dW_{hh}, dW_{xh}, dW_{hy}$ )에 계속해서 누적하여 저장.
- 시퀀스의 맨 처음($t=1$)까지 역전파가 모두 끝나면, 최종적으로 누적된 그래디언트를 이용해 가중치 $W$를 단 한 번 업데이트한다.
Truncated BPTT
이론적으로는 전체 시퀀스에 대해 Full BPTT를 수행하는 것이 맞지만, 실무적으로 시퀀스의 길이($T$)가 매우 길어지면(예: 수천 단어가 넘는 문장이나 긴 비디오) 다음과 같은 문제가 발생한다.
- 메모리 및 계산량 폭발: 역전파를 수행하려면 순전파 때 계산했던 모든 타임스텝의 은닉 상태($h_t$)와 활성화 값을 메모리에 유지해야 한다. 시퀀스가 길어질수록 필요한 메모리와 계산량이 증가.
- 기울기 소실/폭발 (Gradient Vanishing / Exploding): 동일한 가중치 행렬 $W$가 $T$만큼 반복해서 곱해지기 때문에, 역전파 과정에서 그래디언트가 사라지거나(Vanishing) 무한대로 커지는(Exploding) 문제가 발생.
이러한 대규모 시퀀스 데이터를 학습시키기 위한 현실적인 해결책으로 Truncated BPTT를 소개한다. 전체 시퀀스를 한 번에 처리하지 않고, 일정한 타임스텝 크기(t=10, 20…)로 쪼개어 학습하는 방식이다.
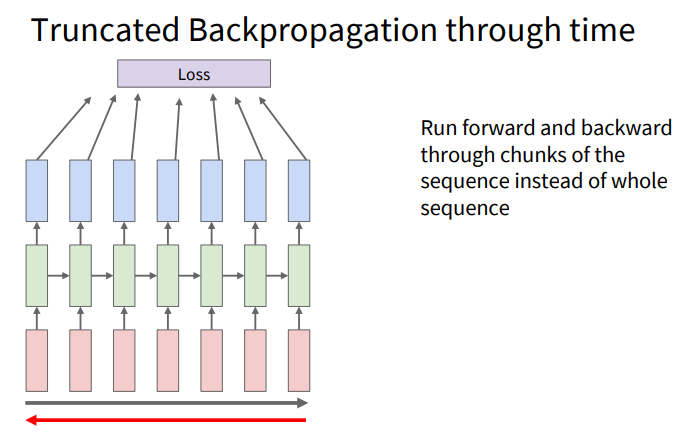
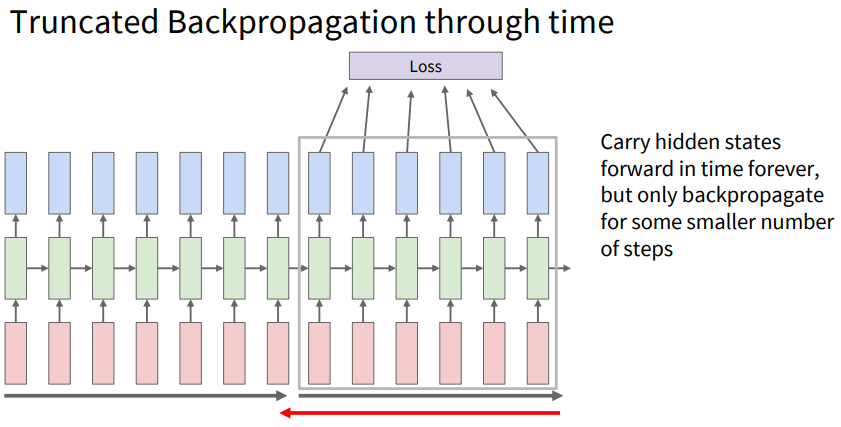
- 지정된 청크 크기만큼만 순전파를 진행하고, 해당 구간 내의 시점별 손실($L_t$)을 계산한다.
- 해당 청크 내에서만 역전파를 수행하여 가중치 $W$를 업데이트.
- 다음 청크 구간으로 넘어갈 때, 이전 청크의 마지막 은닉 상태 $h_t$ 값을 전달하여 다음 순전파의 초기값으로 사용한다.
- 다음 청크의 역전파를 계산할 때는 이전 청크로 그래디언트가 넘어가지 않도록 한다. (메모리를 절약하면서 과거의 정보 맥락을 유지)
위의 설명은 매 타임스텝마다 Loss가 발생하는 Many-to-Many를 가정한 것이고, Many-to-One 구조에서는 Loss가 마지막 청크의 최종 시점에만 존재한다.
따라서 마지막 출력층이 포함된 청크의 그래디언트만 계산하고 이전 청크는 아예 업데이트 하지 않거나(엄격한 Truncated BPTT), 출력층 청크의 가장 왼쪽 그래디언트만 메모리에 저장해두고 이전 청크에게 넘겨주는 방식을 적용할 수 있다.(Memory-Efficient BPTT)
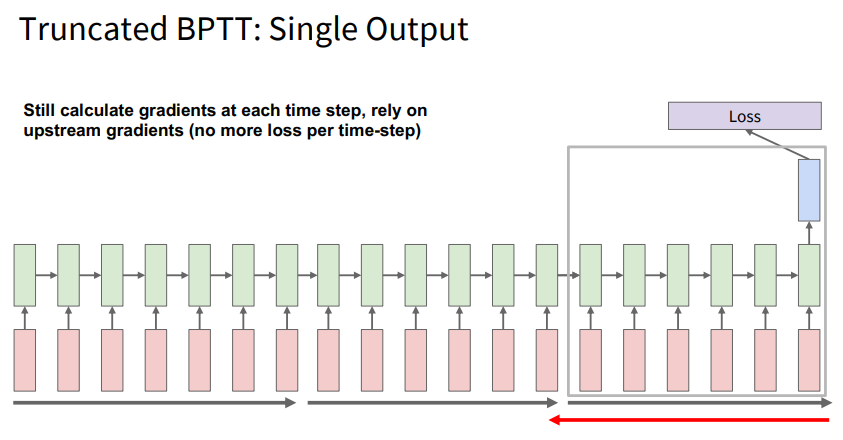
Memory-Efficient BPTT
일부 중간 시점의 값만 캐시하여 완전히 그래디언트를 단절시키지 않는 방법을 Memory-Efficient BPTT라고 한다.
- 전체를 청크로 나누어 순전파를 진행할 때, 내부의 모든 연산 결과를 저장하지 않고 각 청크의 시작 지점의 은닉 상태(이전 청크에서 넘어온 최종 은닉 상태)만 메모리에 저장
- 마지막 출력층이 포함된 청크에서 최종 Loss를 기반으로 역전파를 수행할 때, 역전파가 해당 청크의 시작점(가장 왼쪽)에 도달하면, 그 위치의 그래디언트를 끊지 않고 저장해둠.
- 1번 과정에서 저장해 둔 은닉 상태 경계값을 초기값으로 삼아 해당 청크 구간만 순전파를 다시 한 번 계산. 이를 통해 지워졌던 활성화 값들을 복구한 뒤, 2번에서 기억해 둔 그래디언트를 이어받아 역전파를 마저 진행.
이 방식을 사용하면 역전파 시 순전파를 중복해서 다시 계산해야 하므로 연산 시간은 늘어나지만, 메모리 사용량을 단일 청크 크기만큼으로 고정시킨 채 Full BPTT의 효과를 얻을 수 있다.
2. LSTM (Long Short-Term Memory)
Vanilla RNN의 한계
앞서 말했듯이, Vanilla RNN은 시퀀스의 Time step이 길어질수록 과거의 정보가 뒤로 갈수록 점점 손실되는 장기 의존성 문제(Long-term dependency problem)를 겪는다.
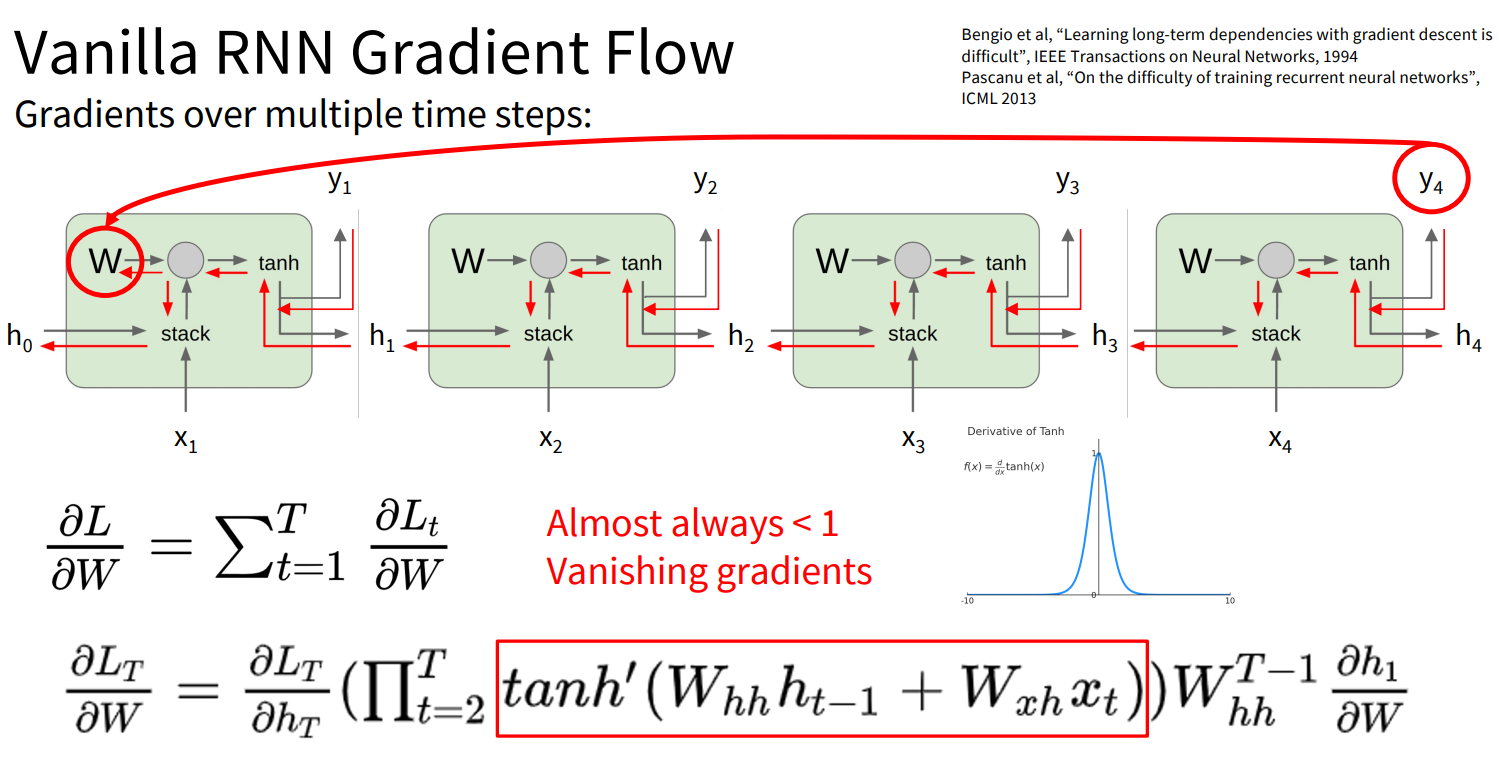
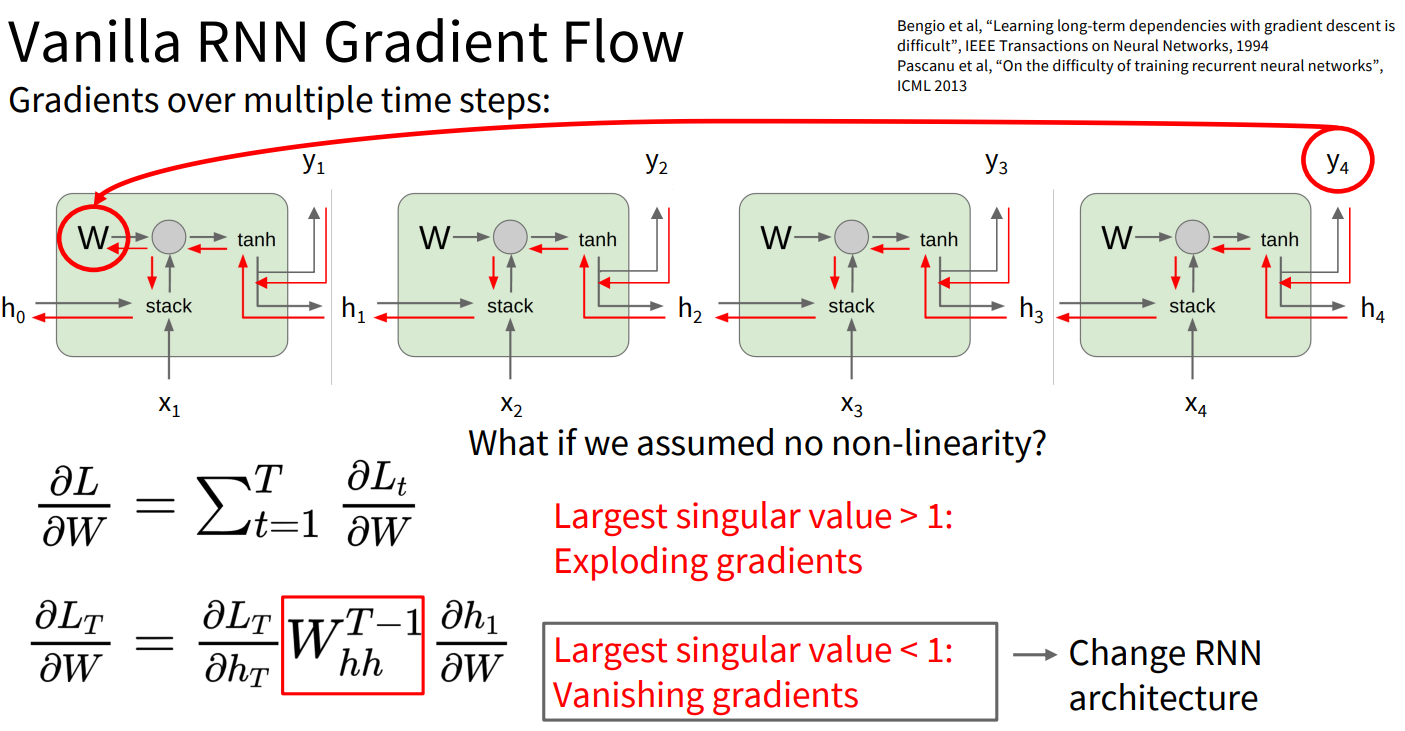
역전파(Backpropagation) 과정에서 은닉 상태 $h_t$의 미분값을 구하려면 동일한 가중치 행렬 $W_{hh}$가 타임스텝의 수만큼 거듭제곱($W_{hh}^t$)되어 곱해진다. 이때 가중치 행렬의 가장 큰 특이값(Singular value)이 1보다 크면 기울기가 무한대로 치솟는 Gradient Exploding이, 1보다 작으면 0으로 수렴해버리는 Gradient Vanishing 현상이 발생한다. (보통 활성화 함수인 $\tanh$의 미분값이 1보다 작기 때문에 Vanishing 문제가 빈번하게 발생함.)
이러한 고질적인 Vanilla RNN의 한계를 극복하기 위해 제안된 구조가 LSTM(Long Short-Term Memory)이다.
LSTM(Long Short Term Memory)의 핵심 구조
LSTM은 기존 RNN의 은닉 상태 $h_t$ 외에도, 정보가 단절 없이 흐를 수 있는 셀 상태(Cell State, $c_t$)를 추가로 도입하고, 은닉 상태 또한 계산하는 방식이 조금 달라진다.
“은닉 상태 = 단기기억, 셀 상태 = 장기기억”
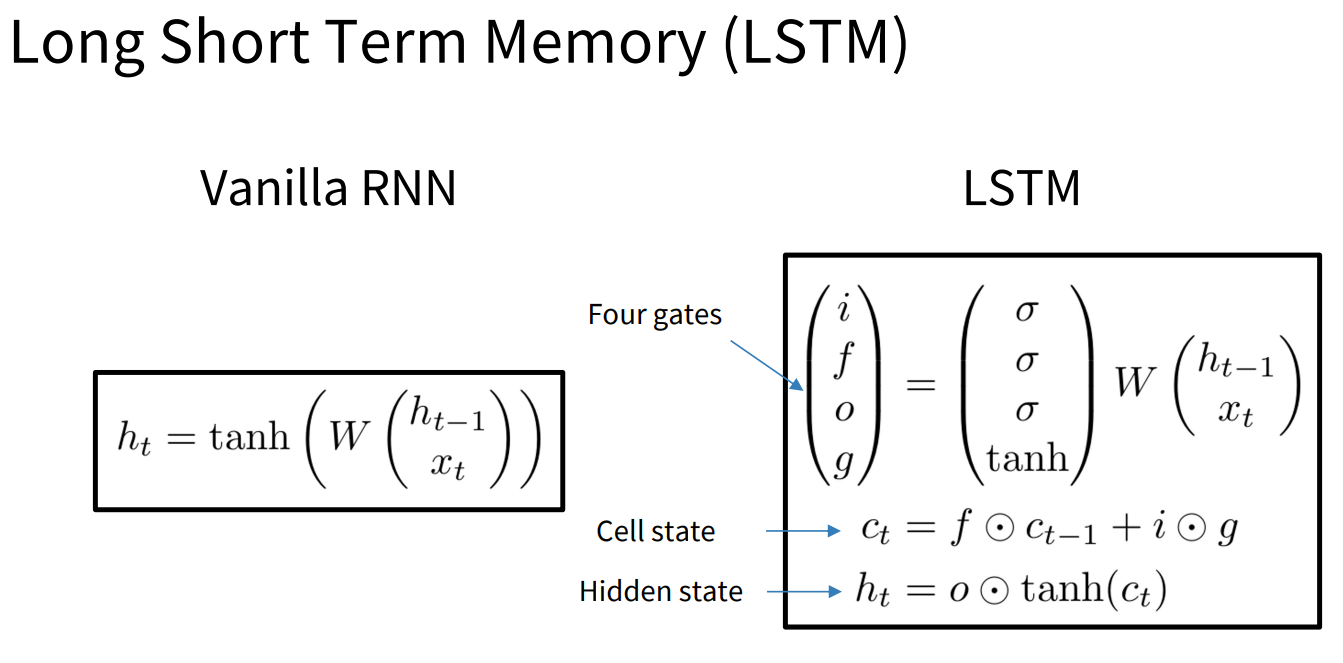
Vanilla RNN은 이전 은닉 상태 $h_{t-1}$와 현재 입력 $x_t$을 받아 $\tanh$ 함수를 거쳐 새로운 $h_t$를 만들었다면, LSTM은 이 두 값을 입력으로 받아 4개의 Gate를 통과시키며 정교하게 정보를 조작한다.
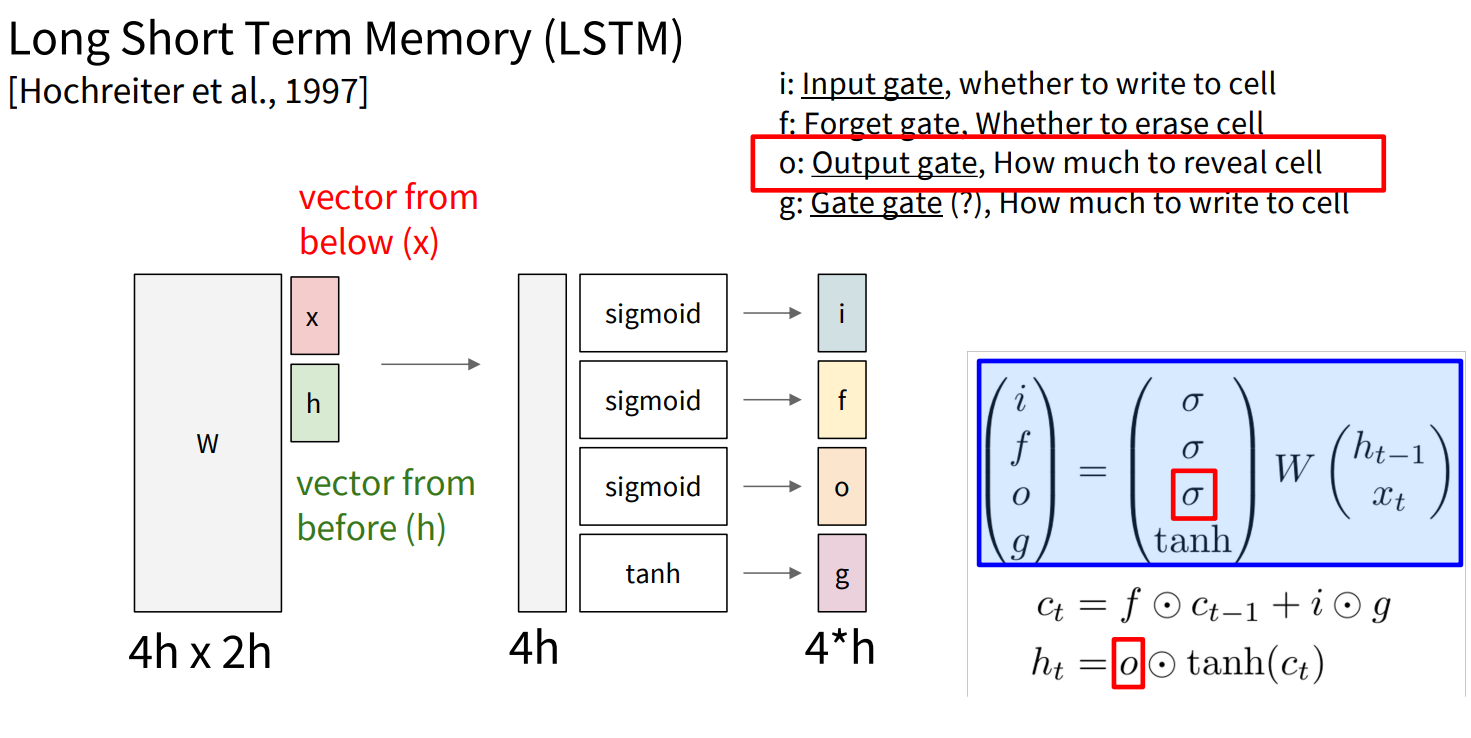
이전 은닉 상태 $h_{t-1}$과 현재 입력 $x_t$ 벡터에 각각 다른 가중치 행렬 $W$를 곱하여 4개의 게이트 값을 계산한다. 수식적으로는 표기의 간결함을 위해 두 벡터를 병합하여(Concat) 하나의 큰 가중치 행렬 $W$를 곱하는 것으로 표현한다.
\[\begin{pmatrix} i \\ f \\ o \\ g \end{pmatrix} = \begin{pmatrix} \sigma \\ \sigma \\ \sigma \\ \tanh \end{pmatrix} W \begin{pmatrix} h_{t-1} \\ x_t \end{pmatrix}\]- $i$ (Input Gate): 새로운 정보를 ‘얼마나(How much)’ 반영할지 결정하는 필터이다. 시그모이드($\sigma$)를 통과하여 0~1 사이의 값을 가지며, 클수록 정보를 더 받아들임.
- $f$ (Forget Gate): 과거의 정보를 얼마나 잊을지 결정한다. 시그모이드($\sigma$)를 통과하므로 0~1 사이의 값을 가지며, 0에 가까울수록 과거 정보($c_{t-1}$)를 많이 지우고, 1에 가까울수록 정보를 보존.
- $g$ (Gate Gate(?)): 셀 상태에 새롭게 기록하고 싶은 ‘정보의 내용물(What)’ 자체이다. $\tanh$를 통과하여 -1~1 사이의 값을 가지며, 어떤 방향(+ 또는 -)으로 상태를 변화시킬지 그 후보값을 나타냄.
- $o$ (Output Gate): 업데이트된 최종 셀 상태($c_t$)를 바탕으로, 다음 은닉 상태($h_t$)로 얼마나 내보낼지 결정함.
State 업데이트
위에서 구한 4개의 Gate 값을 이용하여 LSTM은 두 가지 상태(Cell State와 Hidden State)를 업데이트한다. ($\odot$ 기호는 요소별 곱셈(Element-wise multiplication)을 의미.)
1) Cell State 업데이트 ($c_t$)
\[c_t = f \odot c_{t-1} + i \odot g\]- $f \odot c_{t-1}$ (과거 기억 필터링): 이전 셀 상태에 Forget Gate를 곱해 불필요한 과거 기억을 삭제.
- $i \odot g$ (새로운 기억 융합): 현재 시점의 정보 내용물($g$)에 Input Gate($i$)의 반영 비율을 곱하여 필터링한 뒤, 그 결과를 과거 기억에 덧셈(+)으로 추가.
2) Hidden State 업데이트 ($h_t$)
\[h_t = o \odot \tanh(c_t)\]- 새롭게 완성된 $c_t$를 $\tanh$에 통과시킨 뒤, Output Gate $o$와 곱해 최종적으로 외부(출력층 및 다음 시점)로 보낼 은닉 상태 $h_t$를 계산.
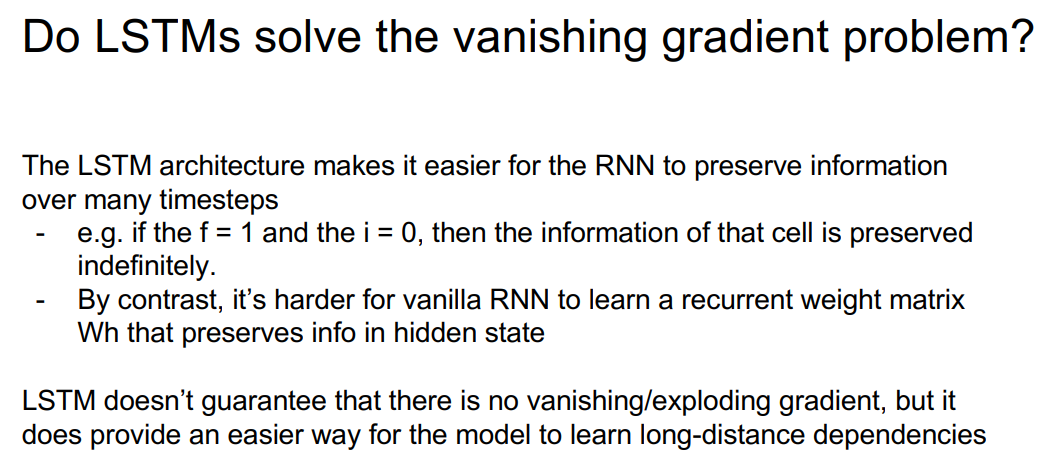
Do LSTMs solve the vanishing gradient problem?
핵심은 Cell State($c_t$)의 덧셈(+) 연산에 있다.
Vanilla RNN은 매 타임스텝마다 가중치 행렬 $W$를 ‘행렬 곱’으로 누적하기 때문에 그래디언트가 소실되었다. 하지만 LSTM의 $c_t$ 업데이트 식($c_t = f \odot c_{t-1} + i \odot g$)을 보면, $c_{t-1}$에서 $c_t$로 넘어갈 때 행렬 곱셈이 아닌 덧셈(+)을 통해 과거 정보를 이어받는다.
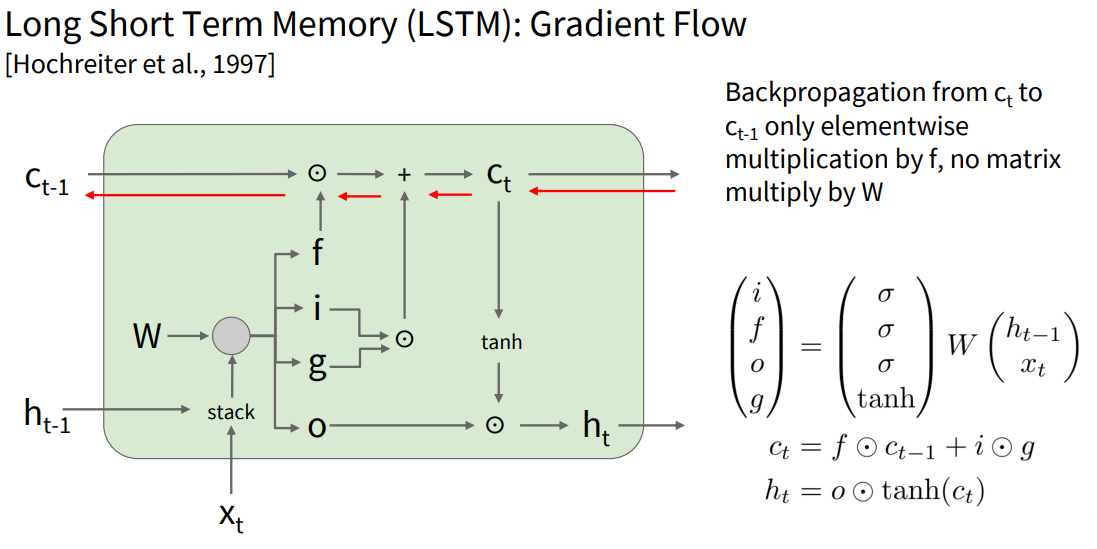
덧셈 연산은 역전파 시 그래디언트를 1 그대로 흘려보내주는 역할을 한다. 즉, Forget Gate $f$가 1에 가까운 값을 유지해 준다면, 아무리 먼 과거의 정보라도 방해를 받지 않고 전달될 수 있다. 이는 ResNet의 Skip Connection과 유사한 성질이다.