 hemisus

1. Seq2Seq
Seq2Seq(Sequence-to-Sequence)은 크게 인코더(Encoder)와 디코더(Decoder)로 구성된 RNN 기반 아키텍처이다.
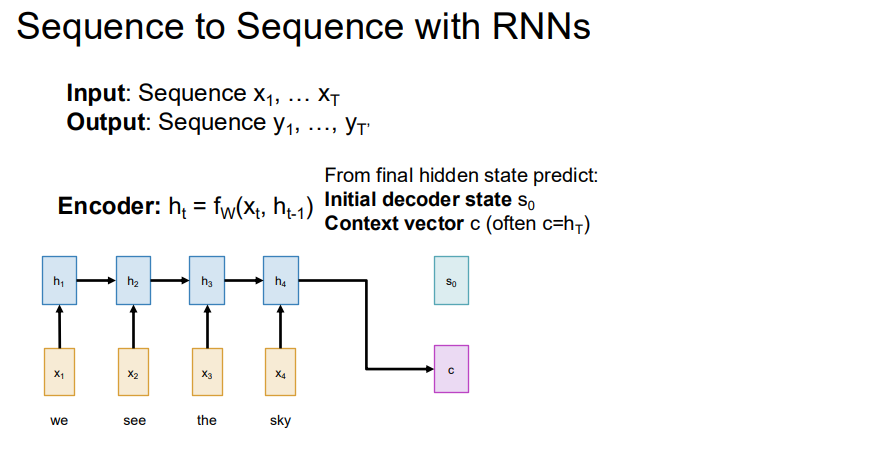
인코더는 현재 시점의 입력 $x_t$와 이전 시점의 은닉 상태 $h_{t-1}$을 받아 다음 은닉 상태 $h_t$를 계산한다.
\[h_t = f(x_t, h_{t-1})\]이 은닉 상태 $h_t$는 시점 $t$까지의 입력 정보를 누적하여 담고 있는 벡터이다. 인코더의 마지막 시점의 은닉 상태를 컨텍스트 벡터(context vector) $c$라고 부르며, 이를 디코더의 첫 은닉 상태로 그대로 사용하거나 초기 은닉 상태를 계산하는 데 이용한다.
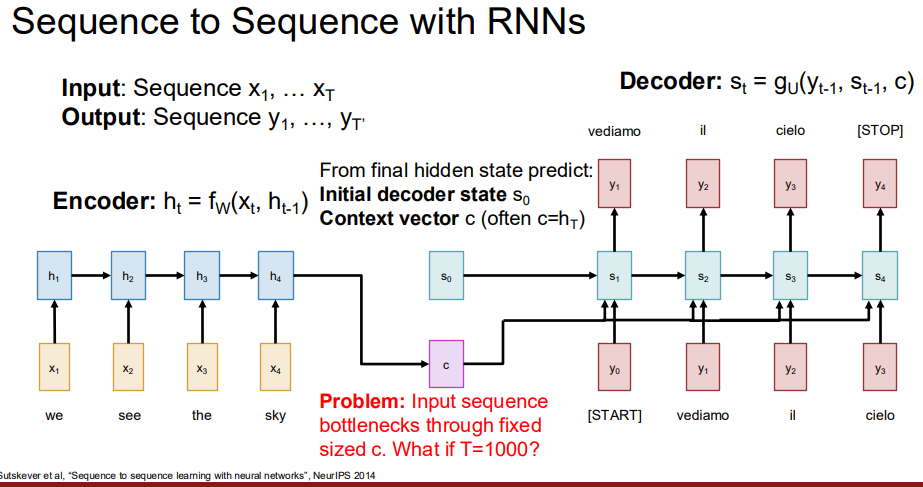
디코더는 이전 시점의 은닉 상태 $s_{t-1}$, 이전 시점의 예측값(출력 토큰) $y_{t-1}$, 그리고 컨텍스트 벡터 $c$를 이용하여 매 시점마다 예측값을 출력한다.
\[s_t = g(y_{t-1}, s_{t-1}, c)\]슬라이드와 같이 디코더는 매 시점마다 단어를 하나씩 순차적으로 번역해나가는 방식으로 동작한다.
하지만 이러한 작동 방식에는 한계가 존재한다. 문장의 길이가 매우 길거나 입력이 여러 문장으로 이루어진 글일 경우, 모든 정보를 고정된 크기의 컨텍스트 벡터 $c$ 하나에 압축해서 담는 것은 매우 어렵다. 특히 입력 시퀀스의 앞쪽 정보일수록 인코더를 거치는 동안 점점 손실되는 장기 의존성 문제(long-term dependency problem)가 발생한다.
이 문제를 완화하기 위해 제안된 방식이 바로 Attention이다.
2. Attention
Attention은 디코더가 하나의 고정된 컨텍스트 벡터에만 의존하는 대신, 인코더의 모든 시점의 은닉 상태를 매 예측 시점마다 다시 참고할 수 있도록 하는 방식이다. 이때 모든 은닉 상태를 동일한 비율로 참고하는 것이 아니라, 해당 시점에 필요한 정보에 더 높은 비중을 두어 집중(attend)하여 참고한다.
작동 과정
인코더의 동작은 Seq2Seq과 동일하다고 가정하고, 디코더의 첫 은닉 상태 $s_0$이 있다고 가정하자.
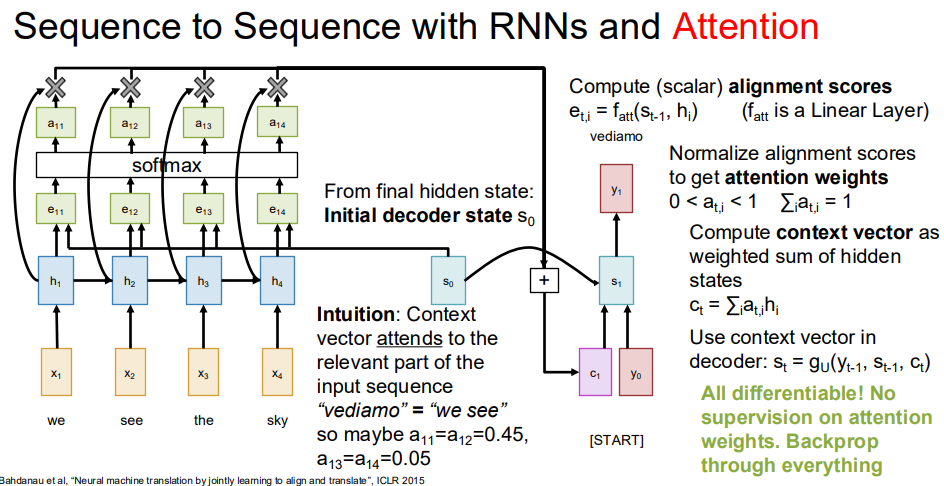
먼저 Alignment Score(Attention Score라고도 불림)를 구한다. 이는 인코더의 각 은닉 상태가 디코더의 현재 시점 은닉 상태와 얼마나 유사한지를 나타내는 값이다. 인코더의 각 은닉 상태 $h_i$를 디코더의 은닉 상태 $s_0$과 내적하여 시점마다 스칼라 값을 구한다.
\[e_{1,i} = h_i \cdot s_0\]이렇게 구한 스코어를 softmax에 통과시켜, 0~1 사이의 값을 가지며 합이 1인 확률 분포 형태의 Attention 가중치 $a_{1,i}$를 얻는다.
\[a_{1,i} = \frac{\exp(e_{1,i})}{\sum_j \exp(e_{1,j})}\]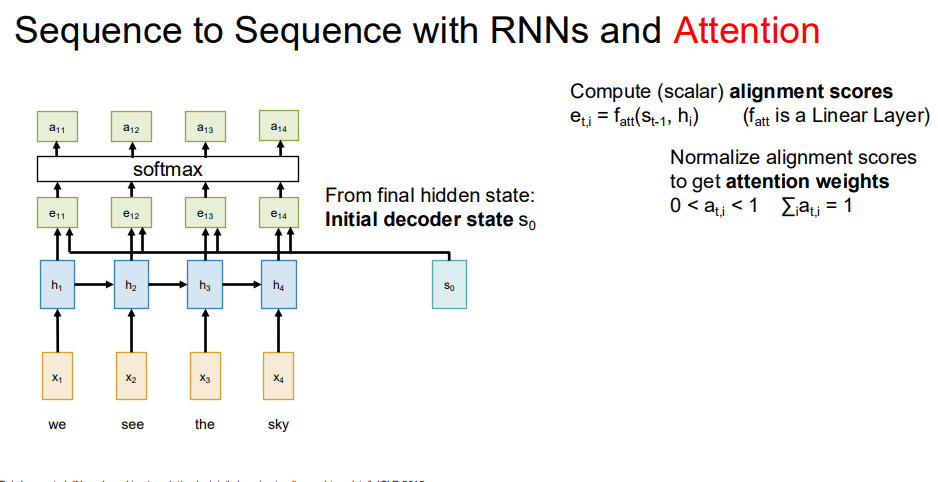
이후 컨텍스트 벡터 $c_1$을 구한다. 모든 인코더 은닉 상태 $h_i$를 방금 구한 Attention 가중치 $a_{1,i}$로 가중합하여 구한다.
\[c_1 = \sum_i a_{1,i} h_i\]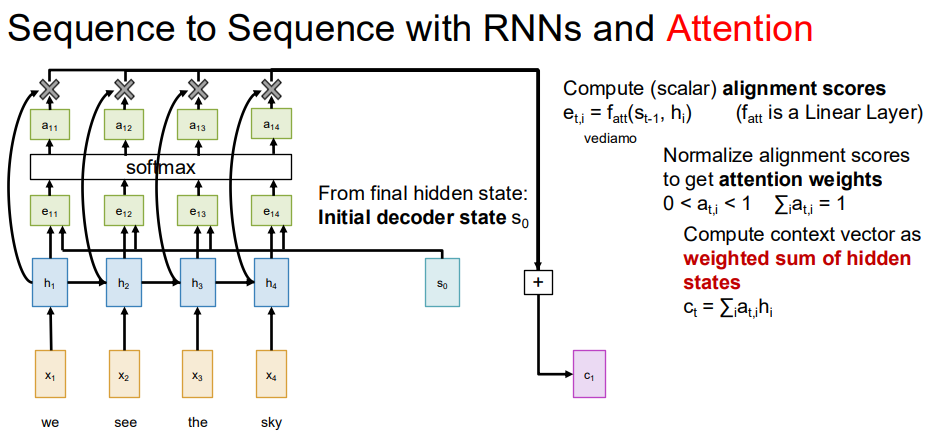
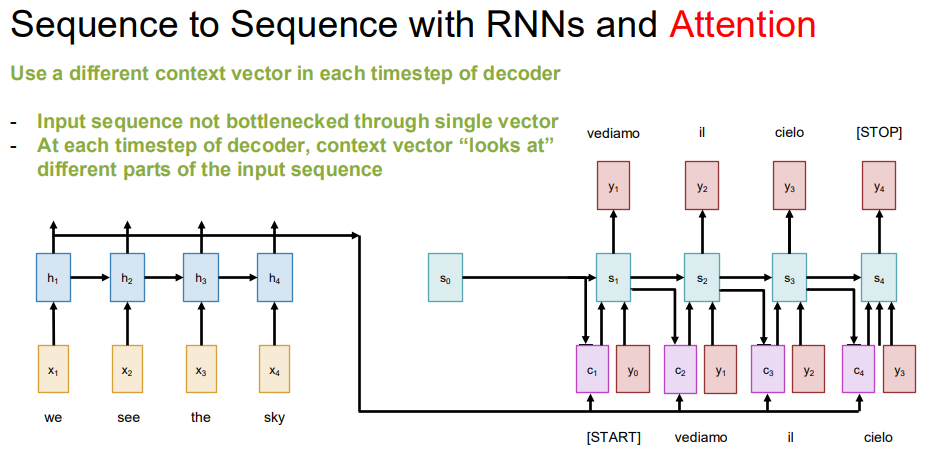
이제 디코더는 이전 시점의 은닉 상태 $s_{t-1}$, 이전 시점의 예측값(출력 토큰) $y_{t-1}$, 그리고 현재 시점의 컨텍스트 벡터 $c_t$를 이용하여 매 시점마다 예측값을 출력한다. Seq2Seq과의 차이점은, 컨텍스트 벡터를 매 시점 새롭게 계산하여 사용한다는 점이다.
이 과정을 반복하면 매 시점 동일한 컨텍스트 벡터를 사용하는 대신, 입력에서 그때그때 연관된 정보를 참고하여 더 좋은 성능으로 예측을 수행할 수 있다. 이로써 입력 시퀀스 전체를 하나의 고정된 벡터로 압축해야 했던 bottleneck이 사라졌고, 매 시점마다 입력 시퀀스의 다른 부분에 더 집중할 수 있게 되면서 예측 성능이 향상되었다.
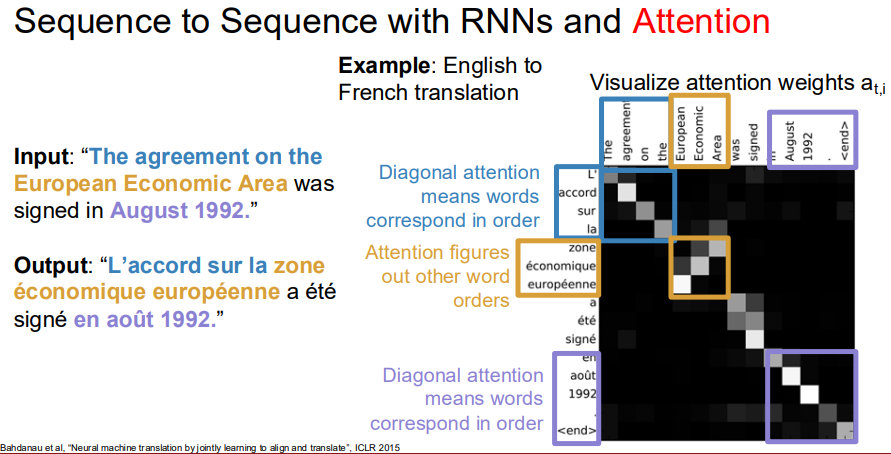
아래 슬라이드를 보면, 영어를 프랑스어로 번역하는 작업을 수행할 때 더 연관된 단어에 높은 가중치가 할당된 것을 시각적으로 확인할 수 있다.
이때 어떤 단어가 더 연관이 있고 어떤 정보를 더 참조해야 하는지는 인간이 직접 지시하는 것이 아니라, 모델이 역전파를 통해 직접 optimize되며 학습한 결과이다. 즉 위의 Attention 과정은 모두 미분 가능한(differentiable) 연산으로 구성되어 있다.
Query, Key, Value
위에서 살펴본 attention 과정을 조금 더 일반화된 형태로 표현하면, Query, Key, Value라는 세 종류의 벡터를 이용해 정리할 수 있다. 이 표현 방식은 이후 self-attention과 Transformer의 핵심 구성 요소가 되므로 중요하다.
앞서 구한 attention 과정을 다시 보면, 두 가지 역할이 섞여 있다는 것을 알 수 있다.
- 디코더의 은닉 상태 $s_{t-1}$은 “지금 무엇을 찾고 싶은가”에 대한 질의 역할을 한다. –> Query
- 인코더의 은닉 상태 $h_i$는 Query와의 유사도를 계산하는 데 사용되는 동시에(–> Key), 실제로 가중합되어 컨텍스트 벡터를 구성하는 데도 사용된다(–> Value).
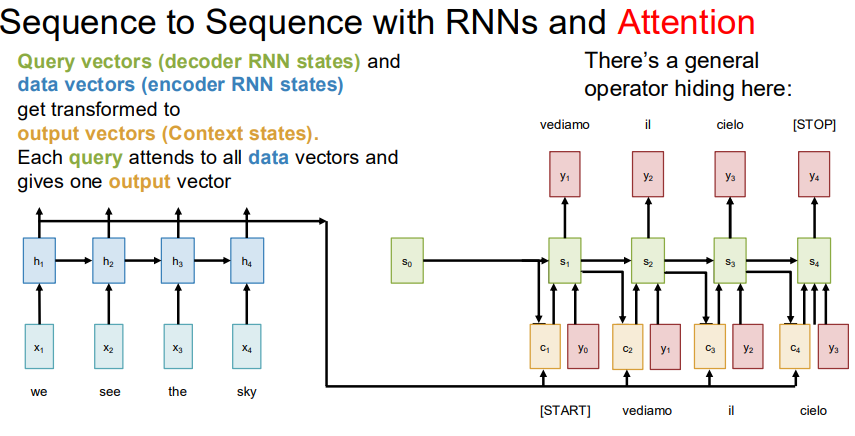
즉, 위 방식에서는 $h_i$가 Key와 Value 역할을 동시에 수행하고 있었던 것이다. 이를 일반화하면, 하나의 입력 벡터로부터 서로 다른 선형 변환(Matrix Multiply)을 통해 Query, Key, Value를 각각 만들어낼 수 있다.
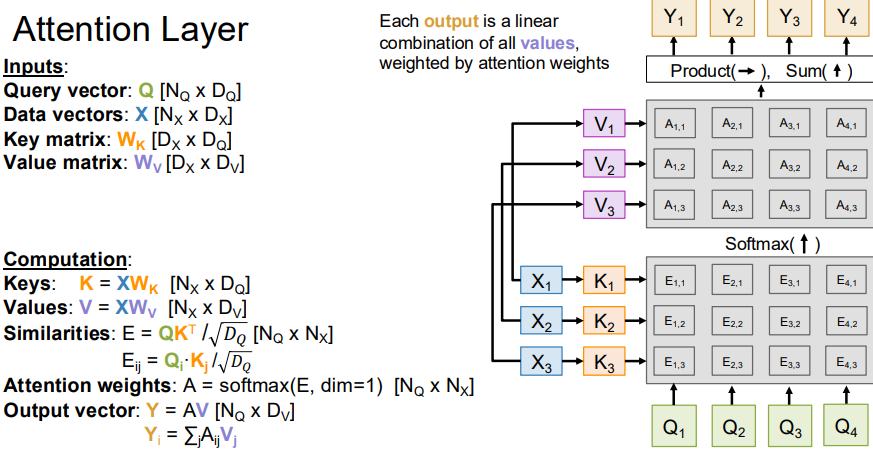
Attention Layer
\[Q = XW_Q, \quad K = XW_K, \quad V = XW_V\]여기서 $X$는 입력 벡터(들의 집합), $W_Q, W_K, W_V$는 각각 Query, Key, Value를 만들기 위해 학습되는 가중치 행렬이다. Key와 Value를 분리함으로써 “어떤 기준으로 유사도를 비교할지”(Key)와 “실제로 어떤 정보를 가져올지”(Value)를 독립적으로 학습할 수 있게 된다.
행렬의 shape을 구체적으로 살펴보면 다음과 같다.
입력 시퀀스에 $N$개의 벡터(토큰)가 있고, 각 입력 벡터의 차원이 $D$라고 하자. 즉 $X$의 shape은 $(N, D)$이며, $X$의 각 행(row)이 하나의 토큰에 대응한다.
- $W_Q, W_K$: shape $(D, D_Q)$ → $Q, K$의 shape은 $(N, D_Q)$
- $W_V$: shape $(D, D_V)$ → $V$의 shape은 $(N, D_V)$
$Q$와 $K$는 이후 내적을 해야 하므로 반드시 같은 차원 $D_Q$를 가져야 한다. 반면 $V$는 내적 연산에 참여하지 않고 가중합에만 쓰이기 때문에 이론적으로는 $Q, K$와 다른 차원 $D_V$를 가져도 무방하다. 다만 실제 구현에서는 연산이 편리하도록 $D_Q = D_K = D_V$로 동일하게 설정하는 것이 일반적이다.
- $Q$의 $i$번째 행: $i$번째 토큰이 “무엇을 찾고 싶은가”를 나타내는 쿼리 벡터
- $K$의 $j$번째 행: $j$번째 토큰의 정보를 드러내는 키 벡터
- $V$의 $j$번째 행: $j$번째 토큰이 실제로 “전달할 정보”를 담은 값 벡터
전체 계산 과정은 다음과 같이 정리된다.
1. 유사도 계산
Query와 모든 Key 사이의 유사도를 내적으로 구한다.
\[\text{score} = \frac{QK^T}{\sqrt{D_Q}}\]$Q$의 shape은 $(N, D_Q)$, $K^T$의 shape은 $(D_Q, N)$이므로, $QK^T$의 shape은 $(N, N)$이 된다. 이 행렬의 $(i, j)$ 원소는 $i$번째 토큰의 Query와 $j$번째 토큰의 Key 사이의 유사도를 의미한다. 즉,
- 행(row) $i$: $i$번째 토큰(쿼리)이 나머지 모든 토큰(키)과 얼마나 유사한지를 담은 벡터
- 열(column) $j$: $j$번째 토큰(키)이 나머지 모든 토큰(쿼리)으로부터 얼마나 주목받는지를 담은 벡터
벡터의 차원 $D_Q$가 커질수록 내적 값의 분산이 커져 softmax의 gradient가 매우 작아지는 문제가 있어, 이를 방지하기 위해 $\sqrt{D_Q}$로 나누어 스케일링한다. 이를 Scaled Dot-Product Attention이라 한다.
2. 가중치 계산 (softmax)
\[A = \text{softmax}\left(\frac{QK^T}{\sqrt{D_Q}}\right)\]여기서 핵심은 softmax를 행(row) 방향, 즉 axis=1로 적용한다는 점이다. $(N, N)$ 행렬에서 행 $i$는 “토큰 $i$가 쿼리일 때, 모든 토큰(키) $j = 1, \dots, N$에 대해 계산한 유사도”를 담고 있다. 이 행에 softmax를 적용하면, 하나의 쿼리 $i$가 나머지 모든 키들에 나눠주는 가중치의 합이 1이 되도록 정규화된다.
\[A_{i,j} = \frac{\exp(\text{score}_{i,j})}{\sum_{k=1}^{N} \exp(\text{score}_{i,k})}\]만약 axis=0(열 방향)으로 softmax를 적용한다면 이는 “하나의 키가 모든 쿼리들로부터 받는 관심의 합이 1”이 되도록 정규화하는 것이 되어 의미가 완전히 달라진다. 우리가 원하는 것은 “각 쿼리가 자신의 관심을 여러 키에 어떻게 분배하는가”이므로, 반드시 행(row) 방향, axis=1로 계산해야 한다.
3. 출력 계산
이 가중치로 Value들을 가중합하여 최종 출력을 구한다.
\[\text{Attention}(Q, K, V) = AV = \text{softmax}\left(\frac{QK^T}{\sqrt{D_Q}}\right)V\]$A$의 shape은 $(N, N)$, $V$의 shape은 $(N, D_V)$이므로 $AV$의 shape은 $(N, D_V)$가 된다. 즉 출력의 $i$번째 행은, $i$번째 토큰(쿼리)이 자신의 attention 가중치(행 $i$)로 모든 토큰의 Value 벡터를 가중합한 결과이다.
\[\text{output}_i = AV_i = \sum_{j=1}^{N} A_{i,j} V_j\]여기서 $V_j$는 $V$의 $j$번째 행, 즉 $j$번째 토큰의 value 벡터 전체를 가리킨다 ($X, Q, K$와 마찬가지로 $V$도 “행 = 토큰”). $A$의 열 인덱스 $j$와 $V$의 행 인덱스 $j$가 정확히 같은 토큰을 가리키기 때문에, 별도의 transpose 없이 $AV$가 그대로 계산된다.
Note. $AV$를 실제로 계산할 때는 $D_V$개의 열에 대해 각각 $AV_{:,k} = \sum_j A_{i,j}V_{j,k}$ 형태로 (병렬로) 계산되는데, 열 하나만 떼어보면 “모든 토큰의 $k$번째 feature 값들”일 뿐 특정 토큰의 정보가 아니다. 하지만 모든 열에 걸쳐 동일한 가중치 $A_{i,j}$가 재사용되므로, $D_V$개 차원별 계산 결과를 이어붙이면 $\sum_j A_{i,j}V_j$, 즉 토큰 단위로 value 벡터 전체를 가중합한 것과 정확히 같아진다.
입력이 $N$개의 벡터였던 것처럼, 출력 역시 $N$개의 벡터(shape $(N, D_V)$)로, 입력 토큰 개수는 그대로 유지되면서 각 토큰의 표현이 attention을 통해 재구성된다.
이것이 기본적인 하나의 Attention Layer를 이룬다.
Cross-Attention
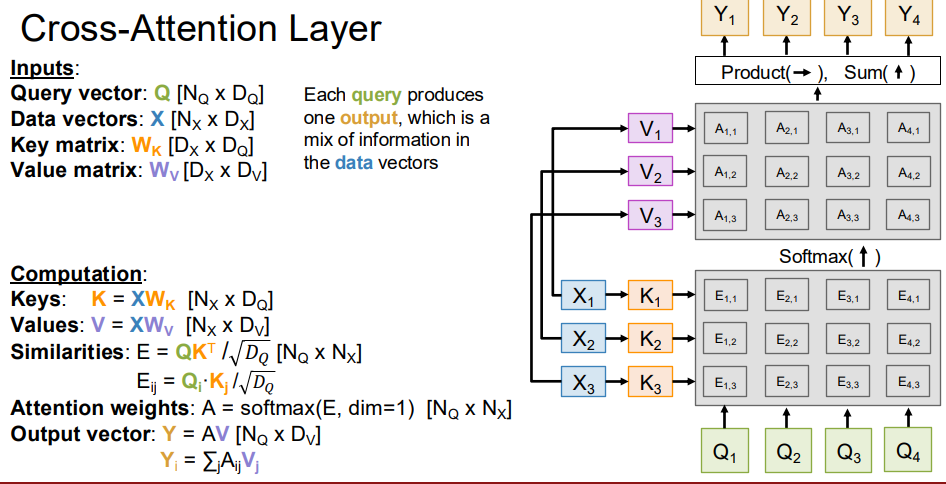
Cross-Attention은 글의 맨 처음에 다뤘던 Seq2Seq + Attention 구조와 동일한 구조로, 디코더의 은닉 상태 $s_{t-1}$이 Query로, 인코더의 은닉 상태들 $h_i$가 Key/Value로 사용되었던 과정을, Q/K/V 프레임워크로 다시 표현한 것이 바로 cross-attention이다. (Query와 Key&Value의 출처가 동일하지 않음)
\[Q = X_1 W_Q, \quad K = X_2 W_K, \quad V = X_2 W_V\]- Query: 정보를 요청하는 쪽의 $X_1$으로부터 계산
- Key, Value: 정보를 제공하는 쪽의 $X_2$로부터 계산
Self-Attention
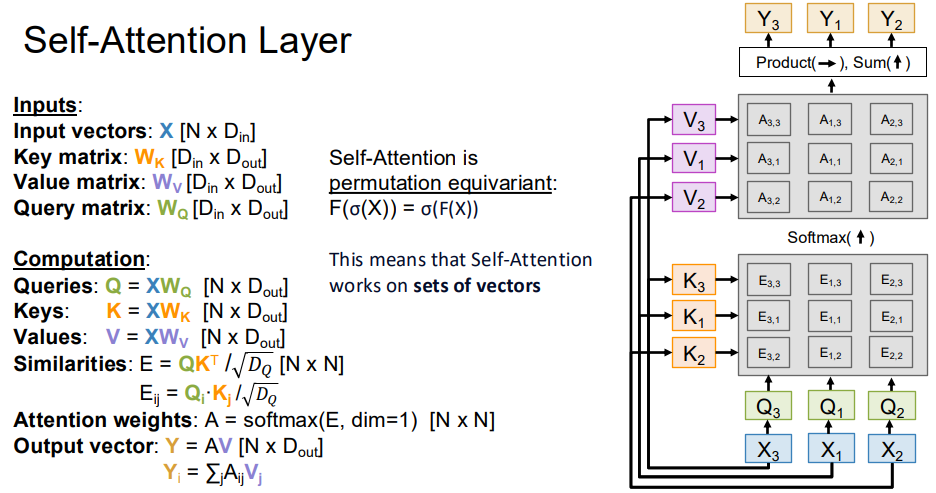
Self-Attention은 Query, Key, Value가 모두 동일한 입력으로부터 계산되는 경우이다.
\[Q = XW_Q, \quad K = XW_K, \quad V = XW_V\]앞서 정리한 Attention Layer의 수식 자체는 동일하고, $Q, K, V$가 모두 같은 입력 $X$로부터 계산된다는 점이 핵심이다.
- 병렬 처리 가능 (RNN과의 결정적 차이): RNN 기반 Seq2Seq에서는 $h_t$를 구하기 위해 반드시 $h_{t-1}$이 먼저 계산되어야 했으므로, 시퀀스를 순차적으로만 처리할 수 있었다. 반면 self-attention은 $QK^T$ 연산이 하나의 행렬곱으로 이루어지므로, 시퀀스 내 모든 토큰에 대한 attention을 한 번에(병렬로) 계산할 수 있다.
- Permutation Equivariant: self-attention 연산 자체는 입력 토큰의 순서를 구분할 수 있는 어떤 정보도 담고 있지 않다. 입력 토큰들의 순서를 뒤섞으면(permute), 출력 역시 동일하게 순서만 뒤섞인 채로 나온다. 하지만 자연어처럼 순서가 의미에 중요한 영향을 미치는 데이터를 다룰 때 이는 문제가 되므로, Transformer는 각 토큰에 positional encoding을 더해준다.
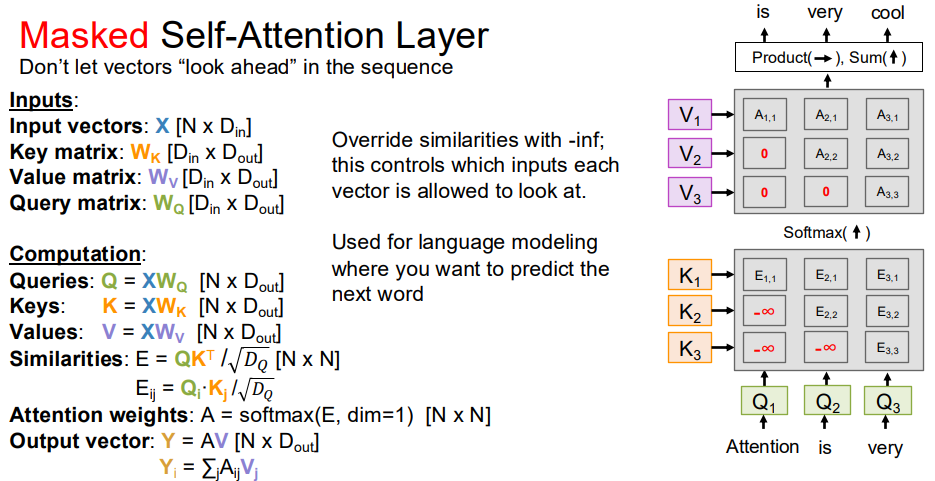
- Masked Self-Attention: 디코더에서 self-attention을 사용할 경우, 아직 생성되지 않은 미래 시점의 토큰 정보를 미리 참고해버리면 문제가 된다. 이를 방지하기 위해 attention score 행렬에서 미래 위치에 해당하는 원소를 $-\infty$로 마스킹한 뒤 softmax를 적용하여, 해당 위치의 가중치가 0이 되도록 만든다. 이를 masked self-attention이라 하며, Transformer 디코더의 핵심 구성 요소이다.
Multi-Head Attention
지금까지 살펴본 attention layer는, 입력을 $D_Q$차원의 Q, K, V벡터로 선형변환해서 어텐션을 수행하였다. 그런데 문장 안에는 동시에 여러 종류의 관계가 존재한다(인접한 단어 관계, 주어-동사 관계, 의미적으로 먼 관계). Attention layer가 단 하나의 Q, K, V만 사용한다면, 이런 다양한 종류의 관계를 전부 하나의 유사도 계산에 넣어야 해서 표현력이 제한된다.
Multi-Head Attention은 하나의 큰 attention을 계산하는 대신 여러 개의 작은 attention을 독립적으로 병렬 계산한 뒤 합치는 방식으로 해결한다. 각각의 작은 attention을 head라고 부른다.
계산 과정
head의 개수를 $h$라 하자. $i$번째 head는 자신만의 가중치 행렬 $W_Q^{(i)}, W_K^{(i)}, W_V^{(i)}$를 가지고, 입력 $X$ (shape $(N, D)$)로부터 자신만의 $Q^{(i)}, K^{(i)}, V^{(i)}$를 계산한다.
\[Q^{(i)} = XW_Q^{(i)}, \quad K^{(i)} = XW_K^{(i)}, \quad V^{(i)} = XW_V^{(i)}\]이때 각 head는 전체 차원 $D_Q$를 $h$등분한 $D_Q / h$ 차원을 가진다. 즉 $W_Q^{(i)}, W_K^{(i)}$의 shape은 $(D, D_Q/h)$, $W_V^{(i)}$의 shape은 $(D, D_V/h)$이며, 각 head의 $Q^{(i)}, K^{(i)}$는 shape $(N, D_Q/h)$, $V^{(i)}$는 shape $(N, D_V/h)$를 갖는다. (전체 $h$개 head의 차원을 모두 합치면 원래의 $D_Q$, $D_V$가 된다.)
각 head는 앞서 정의한 attention 연산을 독립적으로 그대로 수행한다.
\[\text{head}_i = \text{Attention}(Q^{(i)}, K^{(i)}, V^{(i)}) = \text{softmax}\left(\frac{Q^{(i)}{K^{(i)}}^T}{\sqrt{D_Q/h}}\right)V^{(i)}\]이 $h$개의 head 출력을 마지막 축(feature 축)을 따라 이어붙이면(concatenate) shape $(N, D_V)$가 되고, 여기에 최종적으로 학습 가능한 행렬 $W_O$ (shape $(D_V, D_{out})$)를 곱해 최종 결과물을 얻는다.
\[\text{MultiHead}(Q, K, V) = \text{Concat}(\text{head}_1, \dots, \text{head}_h)\,W_O\]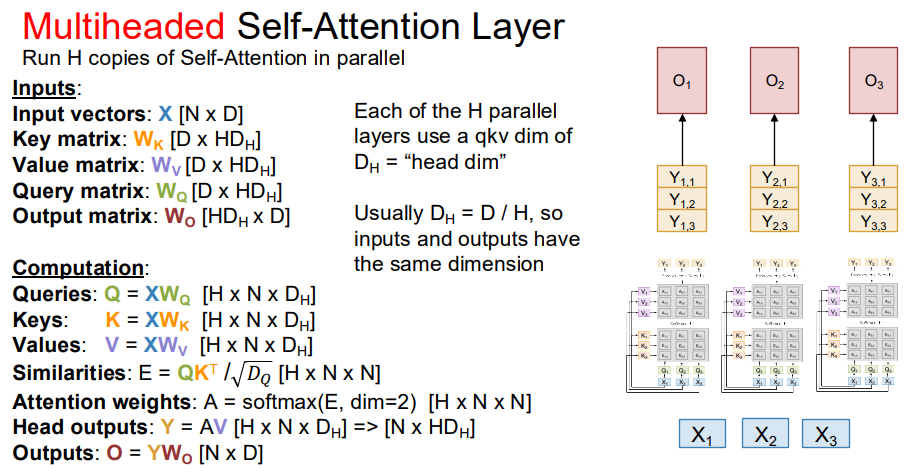
3. Transformer
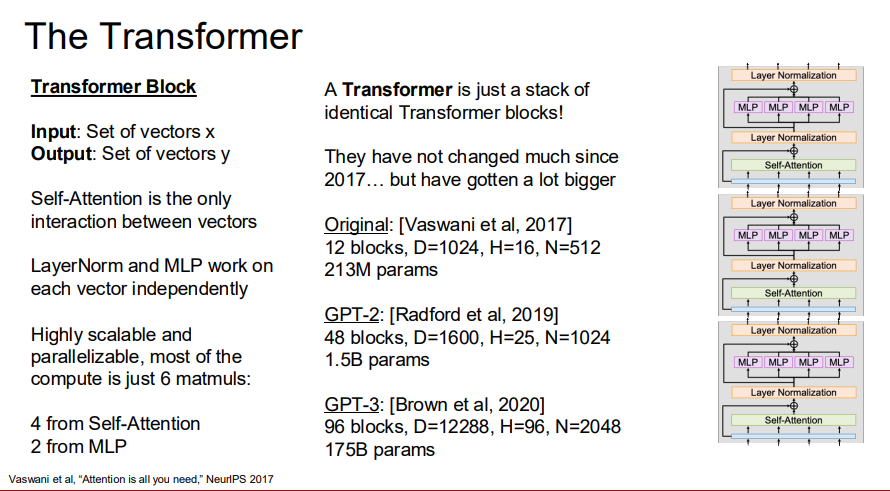
Transformer는 (Multi-Head Self-Attention + MLP)로 구성된 하나의 블록을 반복해서 쌓아 만든 아키텍처이다. Attention이 토큰들 사이에서 정보를 주고받는 역할을 한다면, MLP는 각 토큰이 받은 정보를 개별적으로 가공하는 역할을 한다.
3.1 Transformer Block
하나의 Transformer block은 다음 네 가지 구성 요소로 이루어진다.
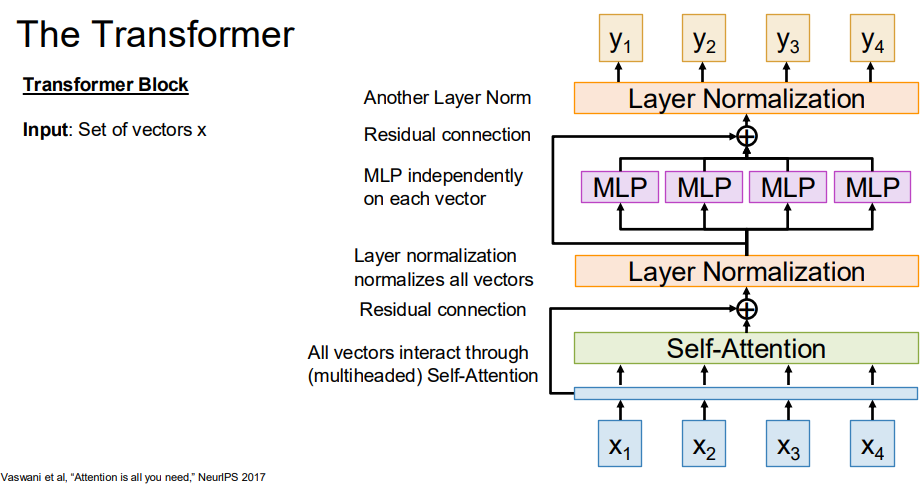
- Multi-Head Self-Attention: 토큰들 사이에서 정보를 교환한다. (지금까지 다룬 유일하게 토큰 간 상호작용이 일어나는 연산이다.)
- Residual Connection: 입력을 sub-layer의 출력에 더해준다.
- Layer Normalization (Norm): 각 토큰 벡터를 정규화한다.
- MLP (Feed-Forward Network): 각 토큰에 독립적으로 적용되는 두 개의 linear layer
이를 수식으로 정리하면 다음과 같다. 입력 $X$ (shape $(N, D)$)에 대해:
\[X' = \text{LayerNorm}\big(X + \text{MultiHeadSelfAttention}(X)\big)\] \[Z = \text{LayerNorm}\big(X' + \text{MLP}(X')\big)\]Residual Connection: Transformer block을 매우 깊게(수십~수백 층) 쌓다 보면, 역전파 과정에서 gradient가 소실되거나 최적화가 어려워지는 문제가 발생한다. Residual connection은 입력을 그대로 다음 층까지 우회 경로(shortcut)로 전달해, gradient가 손실 없이 앞쪽 층까지 흘러갈 수 있게 해준다.
Layer Normalization: 학습을 안정화하고 각 층의 입력 분포를 일정하게 유지하기 위함이다. 각 토큰 벡터 하나마다 feature 차원 $D$ 방향으로 평균과 분산을 구해 정규화한다. 즉 토큰 하나하나가 독립적으로 정규화되므로, 시퀀스 길이나 배치 크기에 영향받지 않는다. ((seq_len, embedding_dim) 행렬이 있으면, 각 행(row) - 즉 토큰 하나마다 embedding_dim 차원 방향으로 평균/분산을 구해서 정규화)
MLP (Feed-Forward Network): 시퀀스의 모든 위치(토큰)에 대해 동일한 가중치를 공유하는 두 개의 linear layer와 그 사이의 활성화 함수(ReLU 또는 GELU)로 구성되며, 보통 중간 차원을 원래보다 확장했다가 다시 원래 차원으로 축소한다.
\[\text{MLP}(x) = W_2\,\sigma(W_1 x + b_1) + b_2\]MLP는 토큰 $i$의 벡터만 입력으로 받아 토큰 $i$의 벡터만 출력하므로, 토큰 간 정보 교환이 전혀 일어나지 않는다 –> 즉 Transformer block 하나는 “attention으로 정보를 모으고(토큰 간 정보교환) → MLP로 그 정보를 가공한다(연산)”는 두 단계를 반복하는 구조이다.
3.2 Positional Encoding
앞서 self-attention의 특징에서 다뤘듯, self-attention과 MLP는 모두 permutation equivariant하다. 입력 토큰의 순서를 뒤섞으면 출력도 그대로 순서만 뒤섞여 나올 뿐, 순서 정보 자체를 활용하지 못한다. 하지만 언어처럼 순서가 의미에 결정적인 데이터를 다루려면 각 토큰이 시퀀스 내에서 몇 번째 위치에 있는지를 모델에게 알려줘야 한다.
이를 위해 각 토큰의 임베딩에 위치 정보를 담은 Positional Encoding 벡터를 더해준다.
\[X_{\text{input}} = \text{Embedding}(\text{tokens}) + PE\]원 논문(Attention is All You Need)에서는 서로 다른 주기를 갖는 sin, cos 함수를 이용한 sinusoidal positional encoding을 사용했다. 위치 $pos$, 차원 인덱스 $i$에 대해:
\[PE_{(pos,\, 2i)} = \sin\!\left(\frac{pos}{10000^{2i/D}}\right), \qquad PE_{(pos,\, 2i+1)} = \cos\!\left(\frac{pos}{10000^{2i/D}}\right)\]이 방식의 한계점을 보완한 RoPE(Rotary Position Embedding) 방식이 이후 제안되었다.
3.3 Encoder-Decoder 구조
Transformer block을 여러 개 쌓아 Encoder와 Decoder를 구성하고, 이 둘을 연결하면 원 논문의 전체 Transformer 아키텍처가 된다.
Encoder: 입력 시퀀스 전체를 받아, Transformer block($=$ Self-Attention + MLP)을 $N$번 반복해서 쌓는다. 각 block을 지날 때마다 모든 토큰이 서로를 참고하며 문맥 정보를 더 풍부하게 담은 표현으로 갱신한다.
Decoder: 출력 시퀀스를 한 토큰씩 생성하며, 각 Transformer block마다 두 종류의 attention을 사용한다.
- Masked Self-Attention: 지금까지 생성된 출력 토큰들끼리 self-attention을 수행하되, 미래 시점의 토큰은 볼 수 없도록 마스킹한다(masked self-attention).
- Cross-Attention: Query는 디코더 자신의 표현에서, Key와 Value는 encoder의 최종 출력에서 가져온다. 디코더가 매 시점 인코더의 정보를 참고해 다음 토큰을 예측한다.
각 attention 다음에는 동일하게 residual connection, LayerNorm, MLP가 뒤따른다. 이러한 Decoder block을 $N$번 쌓은 뒤, 마지막에 linear layer와 softmax를 거쳐 다음 토큰에 대한 확률 분포를 출력한다.
3.4 RNN과의 비교
| RNN (Seq2Seq) | Transformer | |
|---|---|---|
| 토큰 간 정보 전달 경로 | 순차적 ($O(N)$ 단계를 거쳐야 먼 토큰에 도달) | 모든 토큰이 attention을 통해 1단계($O(1)$)만에 서로 직접 연결 |
| 학습 시 병렬화 | 불가능 (이전 시점의 은닉 상태가 있어야 다음 시점 계산 가능) | 가능 (전체 시퀀스에 대한 attention을 행렬곱으로 한 번에 계산) |
| 시간복잡도/메모리 | 시퀀스 길이 $N$에 대해 선형 ($O(N)$), 은닉 차원 $D$에 대해 $O(D^2)$ | attention score 행렬이 $(N,N)$이므로 $N$에 대해 이차 ($O(N^2)$) |
| 순서 정보 | 재귀 구조 자체에 순서가 내재됨 | 별도의 positional encoding으로 순서를 명시적으로 주입해야 함 |