 hemisus

컴퓨터 비전 분야의 다양한 core task를 다룬다.
1. Semantic Segmentation
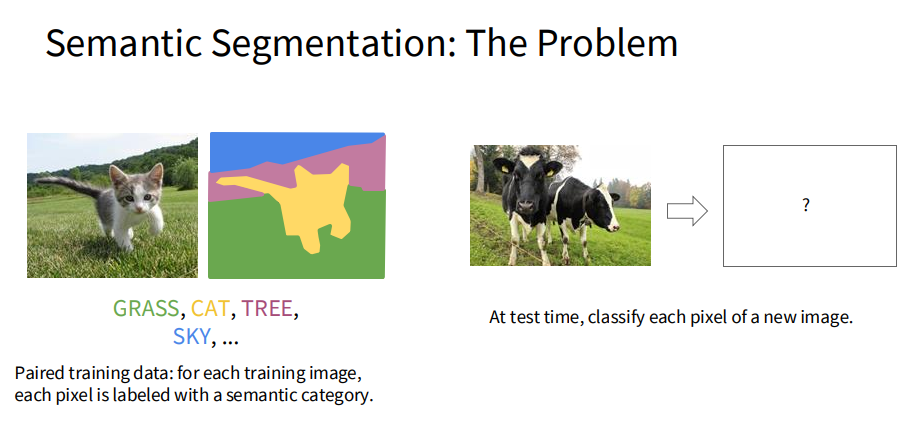
이미지 분할(Image Segmentation)의 하위 분류 중 하나로, 이미지 속의 각 픽셀이 무엇인지 파악하여 같은 종류의 객체는 같은 라벨로 묶어 분할한다.
학습 시에 training data의 image에는 각 픽셀에 대해 semantic category가 레이블되어 있다. Test 단계에서는 새로운 image의 각 pixel이 어떤 클래스인지 분류하는 문제가 된다.
각 픽셀에 대해 분류를 진행하지만 같은 클래스에 속하는 서로 다른 instance(객체)를 구분하지는 않는다. 즉, 사진 속에 소가 두 마리 있어도 둘 다 똑같이 “cow” 픽셀로만 칠해질 뿐 개체 단위로 나뉘지 않는다.
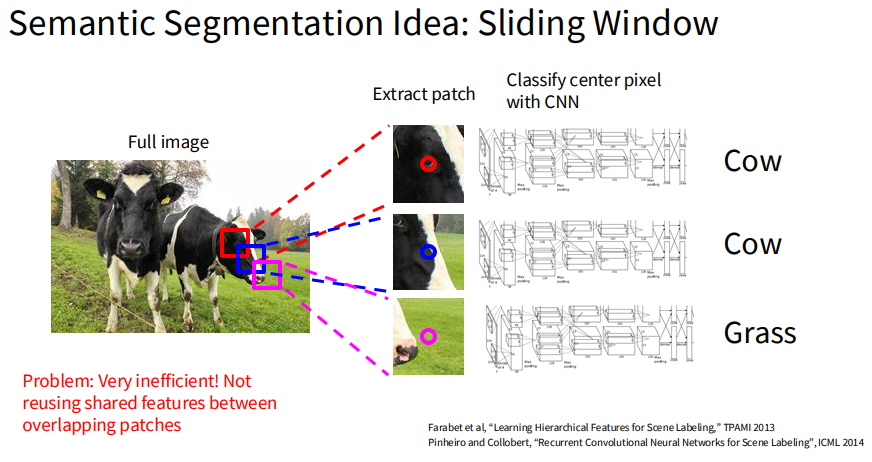
Semantic Segmentation의 가장 단순한 수행 방식은 Sliding Window이다. 일정 크기의 window를 이동시키며 그 안의 context를 이용해 중심 픽셀을 분류한다. 하지만 이 방식은 window 영역이 매번 겹치게 되는데도 겹치는 영역의 feature를 공유하여 재사용하지 않으므로 매우 비효율적이다.
이를 해결하기 위해 전체 이미지를 한 번에 합성곱 레이어에 통과시키는 방식을 생각할 수 있다. 다만 분류 문제와 달리 Semantic Segmentation의 output은 input과 같은 해상도여야 하므로, 해상도를 그대로 유지한 채 깊은 Conv 연산을 쌓으면 연산량과 메모리 요구량이 매우 커진다.
Fully Convolutional Network
이로 인해 제안된 구조가, 모든 레이어를 합성곱 연산으로 구성하면서 네트워크 내부에서 downsampling과 upsampling이 일어나는 Fully Convolutional Network(FCN)이다. 앞부분에서 해상도를 줄여 연산량을 아끼고 넓은 receptive field를 확보한 뒤, 뒷부분에서 다시 원본 해상도로 복원한다.
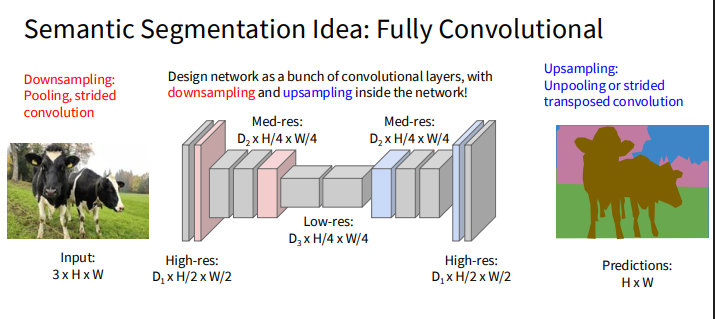
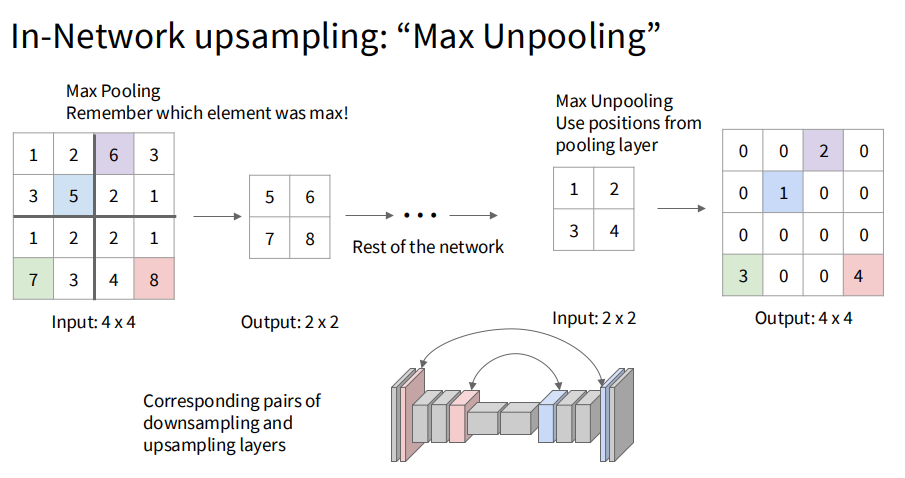
합성곱이 큰 이미지를 작은 특성맵으로 압축했다면, upsampling은 작은 특성맵을 다시 큰 크기로 복원하는 연산을 수행한다.
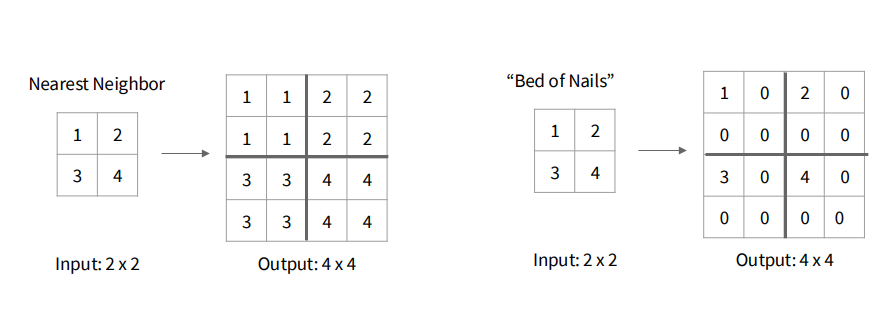
Upsampling에는 다양한 방법이 존재한다. 가장 기본적인 방법으로 Nearest Neighbor, Bed of Nails, Max Unpooling이 소개되며, 이들은 모두 학습 파라미터 없이 정해진 고정된 규칙으로 upsampling을 수행한다.
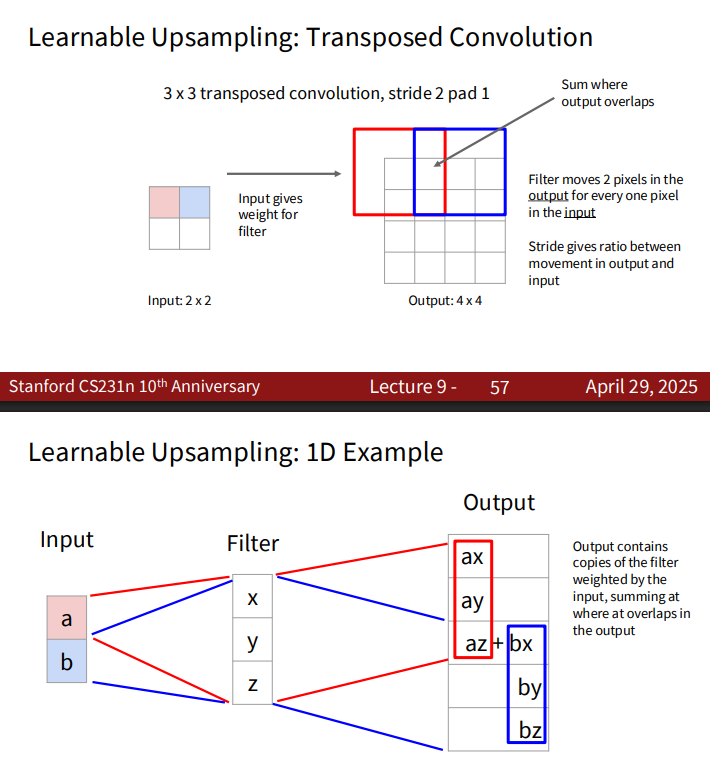
이와 달리 학습 가능한 Upsampling으로 Transposed Convolution이 있다. 일반 합성곱과 동일하게 filter가 학습되는 파라미터이며, stride $> 1$인 경우 출력 해상도가 입력보다 커진다.
U-Net
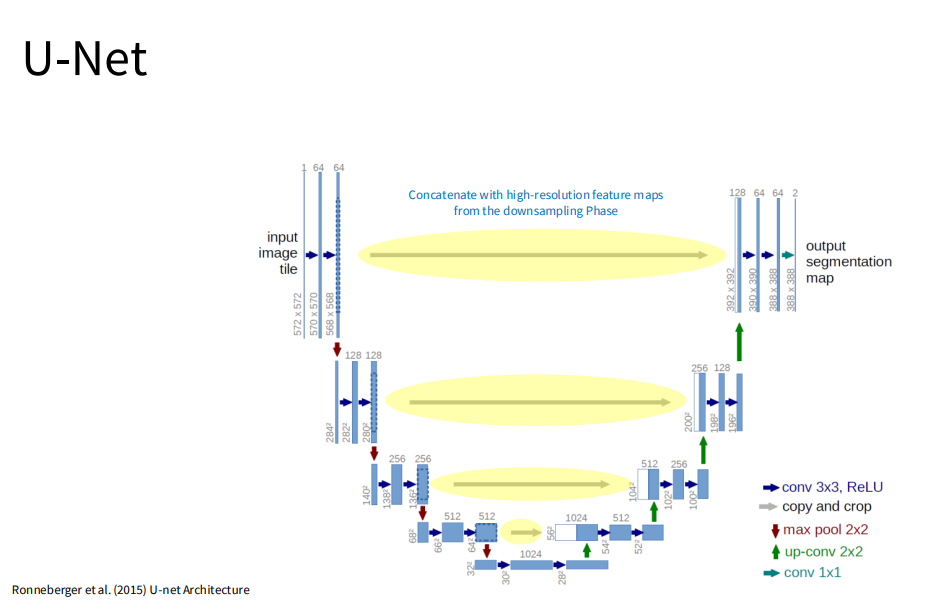
U-Net은 이름처럼 구조가 U자 형태를 띄고 있으며, 왼쪽의 수축 경로(contracting path)와 오른쪽의 확장 경로(expanding path)로 구성된다.
수축 경로에서 합성곱층으로 이미지를 점점 압축하고, 확장 경로에서 upsampling으로 다시 원본 크기로 복원한다는 점은 기존 FCN과 동일하다. U-Net의 핵심 아이디어는 Skip Connection으로, 수축 경로에서 만들어진 중간 특성맵을 따로 저장해두었다가 복원 단계에서 같은 해상도의 특성맵과 결합하여 사용한다.
압축 과정에서 손실되던 세밀한 경계 정보를 복원 단계에서 다시 활용할 수 있게 되므로, 더 정밀한 분할이 가능해진다.
2. Object Detection
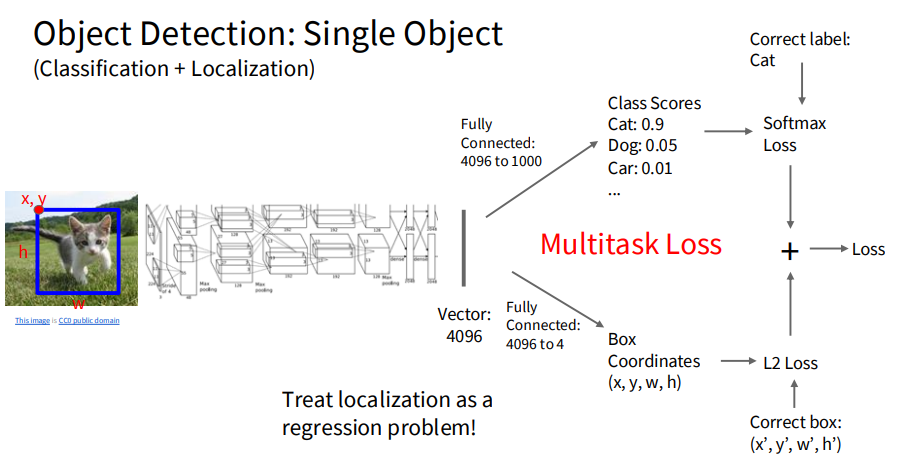
객체 탐지는 말 그대로 사진이나 영상에 있는 객체를 찾아내는 기술이다. 각 객체가 무엇인지 분류하는 문제와 그 객체가 어디에 있는지 위치를 찾아내는 문제를 함께 포함한다.
객체 탐지는 1-stage 방식과 2-stage 방식으로 나뉘는데, 1-stage는 분류와 위치 검출을 한 번에 수행하는 방법이고, 2-stage는 후보 영역을 먼저 뽑고 그 후에 분류를 수행하는 방법이다.
이렇듯 객체 탐지는 클래스 분류와 위치를 찾기 위한 $(x, y, w, h)$ 회귀가 합쳐진 문제이므로, 손실 함수 또한 두 손실의 가중합으로 표현된다.
\[L = L_{\text{cls}} + \lambda L_{\text{loc}}\]여기서 $\lambda$는 두 손실 사이의 균형을 맞추는 하이퍼파라미터이다.
Region Proposal
처음에는 이미지에 객체가 몇 개 있는지 알지 못하므로, CNN 연산을 이미지의 여러 부분에 대해 반복 수행해야 한다. 이때 CNN 연산을 수행할 후보 영역(Region of Interest, RoI)을 먼저 탐색해야 하며, 이러한 후보 영역을 찾는 대표적인 알고리즘이 Selective Search(선택적 탐색)이다.
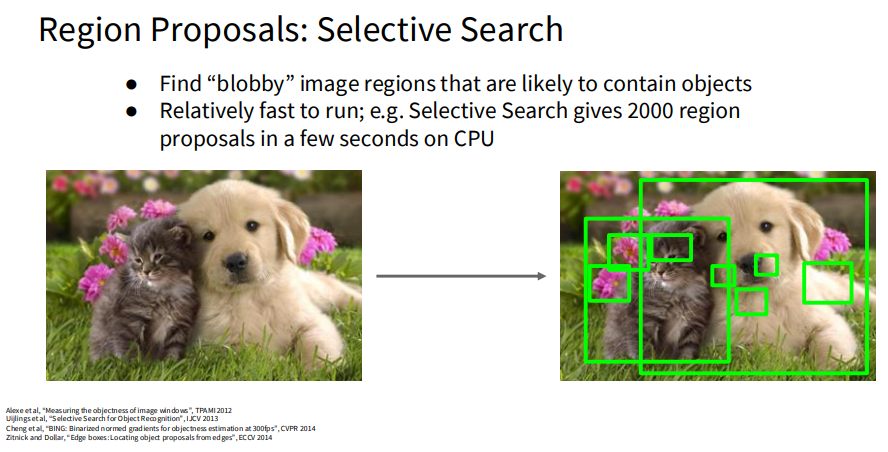
입력으로 들어온 사진을 색상, 질감, 밝기와 같은 기준으로 매우 작은 영역들로 먼저 나눈 뒤, 나누어진 영역들을 색상, 질감, 인접성 등의 기준으로 비슷한 것끼리 병합한다.
이렇게 병합된 영역들을 기반으로 객체가 있을 것으로 판단되는 후보 영역(바운딩 박스)을 얻게 되고, 이 과정을 반복하여 다양한 크기의 후보 영역을 추출한다. (후보 영역의 개수는 하이퍼파라미터로, 아래에서는 2000개가 사용된다.)
R-CNN
R-CNN은 선택적 탐색으로 먼저 후보 영역을 구하고, 그 영역들을 각각 CNN의 입력으로 전달해 객체 탐지를 수행하는 기술이다. 이전의 객체 탐지 기술은 슬라이딩 윈도우 방식으로 이미지의 모든 영역을 검사했는데, R-CNN은 객체가 있을 만한 후보 영역을 먼저 구한 뒤 그것만 CNN에 입력한다는 점이 핵심이다.
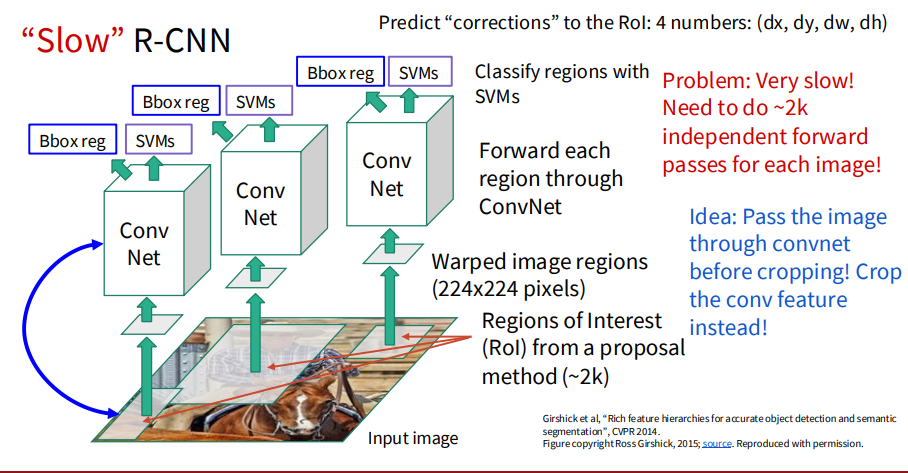
추출한 RoI에 대해 클래스 분류와 Bbox Regression을 적용하여, 해당 영역의 레이블과 함께 바운딩 박스를 어디로 얼마나 이동·확대해야 하는지 조정값을 예측한다.
R-CNN의 단점은 다음과 같다.
- 합성곱층에 후보 영역을 넣기 위해 각 영역을 강제로 리사이즈하는데, 이 과정에서 이미지가 왜곡되어 원본의 형태 정보가 훼손될 수 있다.
- 2000개의 후보 영역을 각각 독립적으로 CNN에 통과시켜야 하므로 연산량이 매우 크다.
Spatial Pyramid Pooling (공간 피라미드 풀링, SPP)
SPP는 이를 해결하기 위해 처리 순서를 바꾼다. 이전과 같이 원본 사진에서 선택적 탐색으로 RoI 좌표 2000개를 저장해두되, CNN에 통과시키는 것은 후보 영역이 아니라 원본 이미지 전체이다. 이러면 특성맵 1개가 생성되는데, 여기에 앞서 구한 RoI 좌표를 대응시킨 뒤 완전연결층에 들어가기 직전에 크기를 통일시켜 분류를 수행한다.
이 방식은 크기 조정을 합성곱층 이전이 아니라 완전연결층 직전에 수행하므로 CNN이 왜곡이 덜한 특성맵을 얻을 수 있고, 2000번이 아니라 딱 1번만 CNN을 통과시키면 되므로 훨씬 빠르고 효율적이다.
Fast R-CNN
SPP의 아이디어로 R-CNN을 개선한 방식이 Fast R-CNN이다. “원본 이미지를 CNN에 한 번만 통과시킨다”는 핵심을 그대로 유지하면서, SPP층을 RoI Pooling이라는 더 단순하고 효율적인 방식으로 교체했다. 또한 분류기로 SVM 대신 softmax를 사용하고 bbox regression까지 하나의 네트워크에서 함께 학습하도록 통합했다.
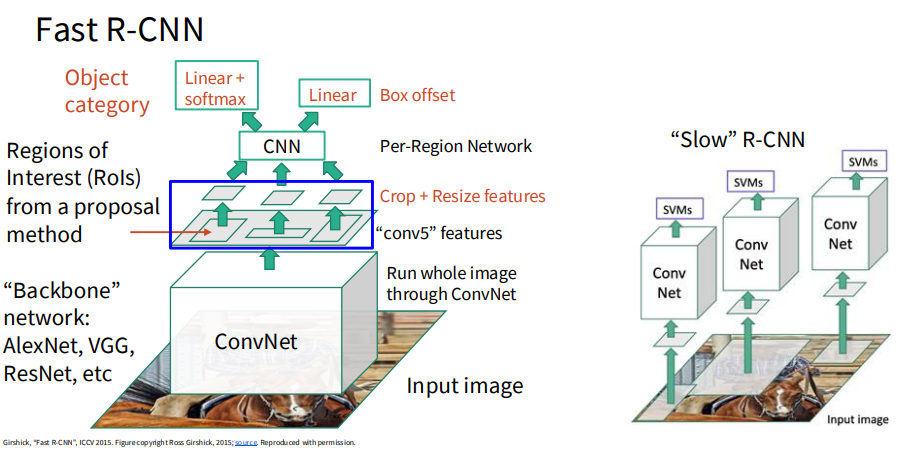
RoI Pooling: 크기가 각각 다른 후보 영역을 풀링할 때, 영역을 목표 출력 크기만큼의 격자로 나눈 뒤 각 칸마다 max pooling을 적용해 결과 크기를 통일시키는 방법.
예시: $8 \times 8$ 특성맵 위의 $7 \times 5$ 크기 RoI를 $2 \times 2$ 형태의 고정된 출력으로 만들고자 하면, 가로 방향은 stride $= 3$, 세로 방향은 stride $= 2$를 적용해 $2 \times 2$ 크기의 결과를 얻을 수 있다.
Fast R-CNN에 와서는 CNN 연산이 더 이상 병목이 아니게 되었고, 신경망 바깥에서 CPU로 돌아가는 선택적 탐색이 전체 추론 시간의 대부분을 차지하는 새로운 병목이 되었다.
Faster R-CNN
Fast R-CNN에서 한 번 더 개선된 방식이다. 지금까지 본 R-CNN, Fast R-CNN은 모두 후보 영역을 추출할 때 선택적 탐색이라는 외부 알고리즘을 신경망 바깥에서 수행했는데, Faster R-CNN은 이것을 신경망 내부의 레이어로 대체한 구조이다.
이로써 CPU 대신 GPU에서 계산이 가능해져 속도가 크게 빨라졌고, 기존에는 후보 영역 추출과 객체 분류가 별개의 과정이어서 따로따로 학습해야 했다면 이제는 두 과정을 하나의 네트워크로 통합해 End-to-End 학습이 가능한 구조가 되었다.
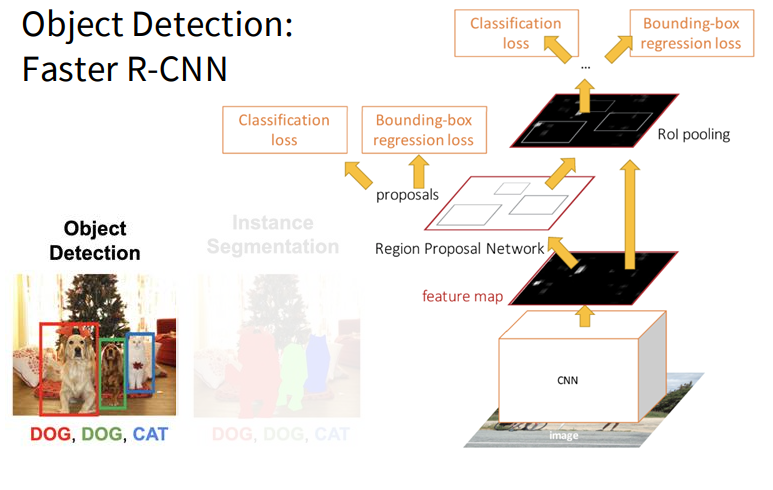
Region Proposal Network (RPN)
Faster R-CNN에서 후보 영역을 추출하는 레이어이다.
RPN은 CNN을 통과해서 얻은 특성맵 위에서 동작한다. 슬라이딩 윈도우 방식으로 특성맵 전체를 탐색하며, 윈도우가 멈춘 위치에서 $N \times N$ 크기의 특성맵 값을 읽어 RPN 내부의 작은 신경망에 입력으로 사용한다.
이때 윈도우 크기가 $N \times N$으로 고정되어 있으면 사진 속 다양한 크기와 비율의 객체를 수용하기 어렵다는 문제가 생긴다.
이 문제를 해결하기 위해 도입한 것이 앵커(anchor)로, 앵커는 각 윈도우 위치를 중심으로 미리 정해둔 다양한 크기와 비율의 기준 박스이다.
원본 논문에서는 크기 3종류와 비율 3종류를 조합해 위치당 총 $3 \times 3 = 9$개의 앵커를 생성했고, 이 9개의 앵커가 특성맵의 모든 위치를 중심으로 생성된다.
따라서 특성맵 크기가 $W \times H$라면 전체 앵커 수는
\[W \times H \times 9\]개가 된다. 이렇게 다양한 크기와 비율의 앵커를 이미지 전체에 배치해서 다양한 크기와 위치의 객체를 더 수월하게 인식할 수 있다.
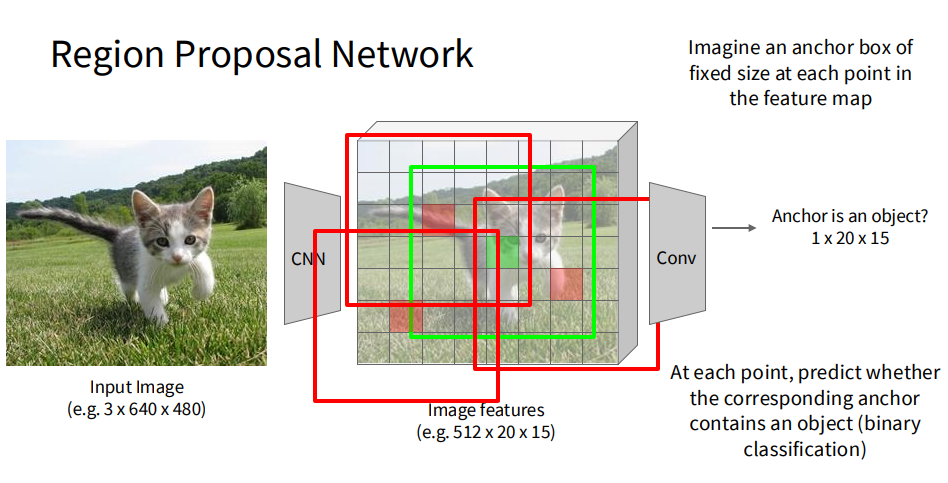
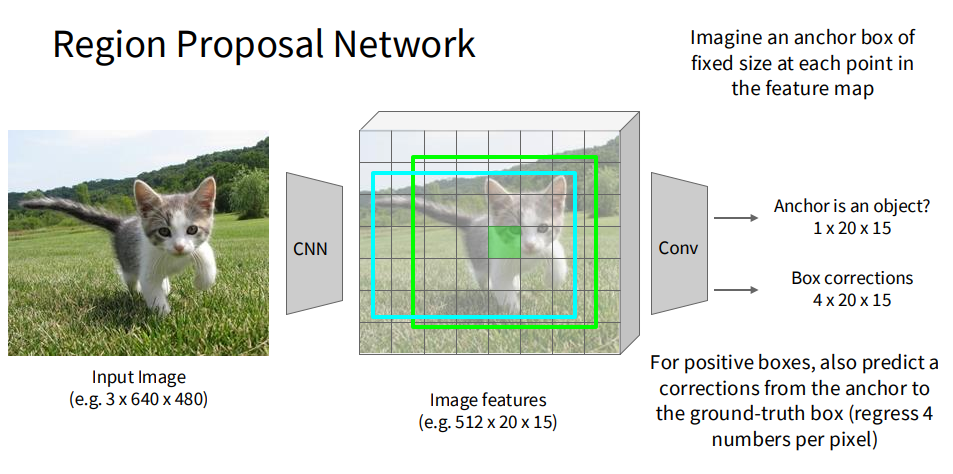
RPN은 각 앵커마다 두 가지를 예측한다.
첫 번째는 해당 앵커 안에 객체가 있는지 없는지를 판단하는 이진 분류이다. 이때 학습 과정에서는 IoU(Intersection over Union)라는 기준을 사용하는데, IoU는 앵커 박스 $A$와 실제 정답 박스 $B$가 얼마나 겹치는지를 $0$에서 $1$ 사이의 값으로 나타낸 것이다.
\[\text{IoU}(A, B) = \frac{|A \cap B|}{|A \cup B|}\]Faster R-CNN 논문에서는 $\text{IoU} \ge 0.7$인 앵커를 positive(객체), $\text{IoU} < 0.3$인 앵커를 negative(배경)로 라벨링하고 negative 앵커는 학습에서 제외한다.
두 번째는 바운딩 박스 회귀이다. 앵커는 규칙에 따라 미리 정해둔 박스이기 때문에 실제 객체의 위치/크기와 정확히 맞지 않는다. 바운딩 박스 회귀는 이 앵커를 실제 객체에 맞도록 미세 조정하는 과정이다. 이때 절대 좌표를 직접 예측하는 것이 아니라, 앵커 $(x_a, y_a, w_a, h_a)$ 대비 상대적인 보정값 $t = (t_x, t_y, t_w, t_h)$를 예측한다.
\[t_x = \frac{x - x_a}{w_a}, \quad t_y = \frac{y - y_a}{h_a}, \quad t_w = \log \frac{w}{w_a}, \quad t_h = \log \frac{h}{h_a}\]중심 좌표는 앵커의 크기로 나누어 정규화하고, 너비·높이는 비율에 로그를 취해 예측한다. 이렇게 하면 객체 크기에 관계없이 예측값의 스케일이 일정하게 유지되어 학습이 안정된다.
이진 분류에서 객체로 판단된 앵커에 한해서만 이 보정을 적용하고, 배경으로 판단된 앵커는 후보 영역이 될 수 없으므로 보정 없이 버려진다. RPN의 전체 손실 함수는 다음과 같다.
\[L(\{p_i\}, \{t_i\}) = \frac{1}{N_{\text{cls}}} \sum_i L_{\text{cls}}(p_i, p_i^{*}) + \lambda \frac{1}{N_{\text{reg}}} \sum_i p_i^{*} L_{\text{reg}}(t_i, t_i^{*})\]여기서 $p_i$는 앵커 $i$가 객체일 예측 확률, $p_i^{\ast}$ 는 정답 라벨($0$ 또는 $1$)이다. 회귀 항에 $p_i^{*}$가 곱해져 있으므로 positive 앵커에서만 회귀 손실이 발생한다.
이렇게 모든 앵커에 대해 예측이 끝나면, 점수가 높은 순으로 정렬하고 NMS(Non-Maximum Suppression)로 중복된 박스를 제거한 뒤 상위 $n$개의 후보 영역을 추출한다. 이후는 Fast R-CNN과 동일하게 RoI Pooling을 거쳐 최종 클래스 분류와 박스 보정이 이루어진다.
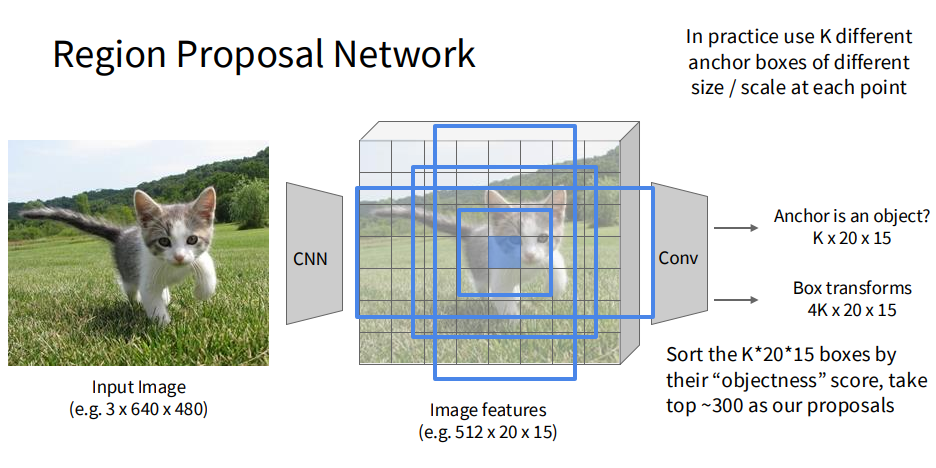
결과적으로 Faster R-CNN은 하나의 네트워크 안에서 RPN의 이진 분류 + 회귀, 최종 다중 클래스 분류 + 회귀로 총 4개의 손실을 함께 학습하게 된다.
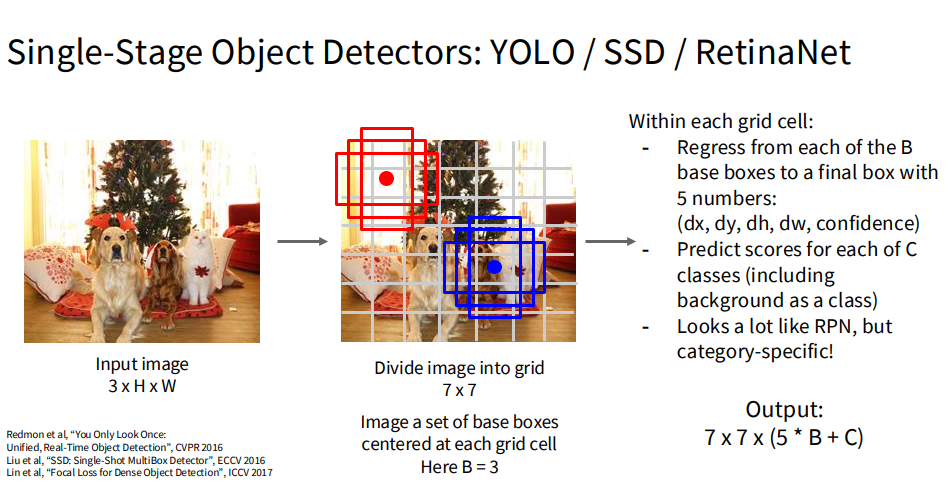
Single-Stage Object Detectors: YOLO / SSD / RetinaNet
분류와 위치 검출을 한 번에 수행하는 1-stage 객체 탐지 기술이다. 별도의 region proposal 단계 없이 특성맵의 각 위치에서 곧바로 클래스와 박스를 예측하므로 훨씬 빠르지만, 일반적으로 정확도에서는 2-stage 방식에 다소 밀린다. 이후 개별 포스트에서 따로 다룰 예정이다.
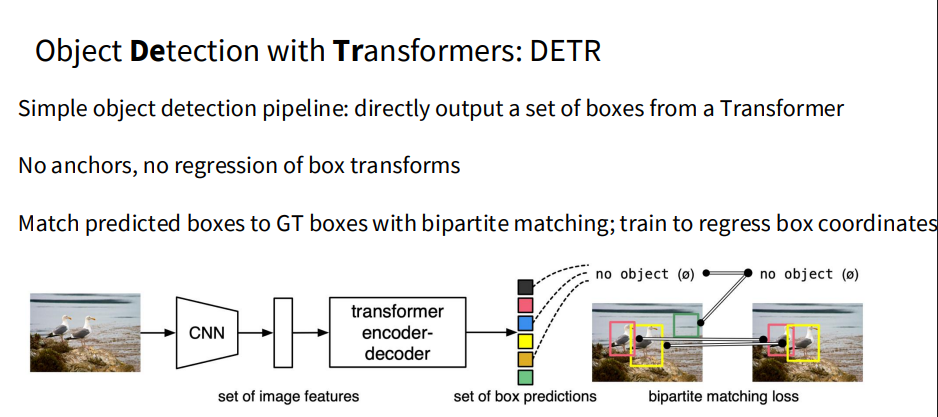
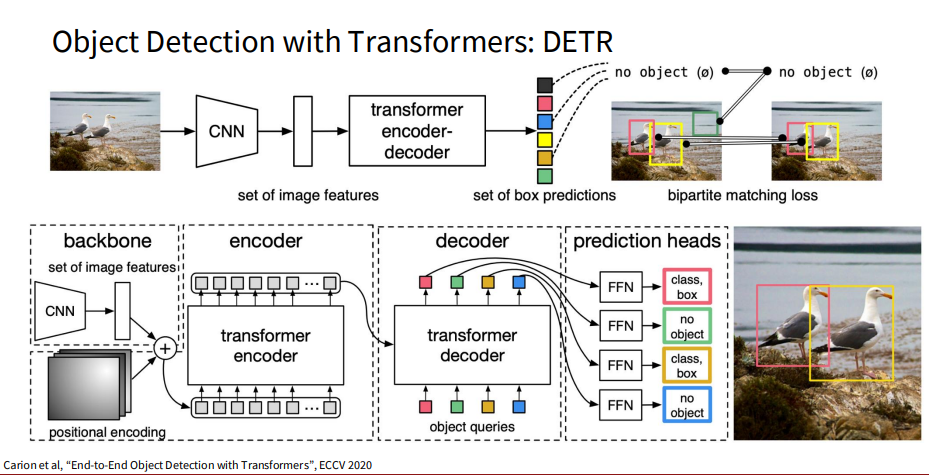
Object Detection with Transformers: DETR
DETR(DEtection TRansformer)은 객체 탐지를 집합 예측(set prediction) 문제로 재정의한 모델이다. 앵커 생성이나 NMS 같은 후처리 과정을 전부 제거한 것이 핵심이다.
- CNN이 이미지에서 특성맵을 추출하고, 위치 정보를 담기 위해 positional encoding을 더한다.
- 이를 Transformer 인코더에 넣어 이미지 전역의 관계를 파악한 표현을 얻는다.
- 디코더에는 학습 가능한 $N$개의 object query를 입력한다. 각 query는 “이미지 어딘가에 있을 객체 하나”를 담당하는 슬롯 역할을 한다.
- 각 query의 출력은 작은 FFN을 거쳐 클래스 하나 + 박스 하나로 변환된다. 객체가 없으면 “no object($\varnothing$)” 클래스를 출력한다.
학습에서는 $N$개의 예측과 실제 정답 박스들 사이를 헝가리안 알고리즘(Hungarian matching)으로 1:1 최적 매칭한 뒤, 매칭된 쌍에 대해서만 분류·박스 손실을 계산한다.
\[\hat{\sigma} = \arg\min_{\sigma \in \mathfrak{S}_N} \sum_{i=1}^{N} \mathcal{L}_{\text{match}}(y_i, \hat{y}_{\sigma(i)})\]이 1:1 매칭 덕분에 같은 객체에 여러 박스가 중복 예측되는 일이 구조적으로 억제되며, 그 결과 NMS가 필요 없어진다. 다만 수렴이 매우 느리고 작은 객체에 대한 성능이 떨어진다는 단점이 있어, 이후 속 연구로 개선된다.
3. Instance Segmentation
픽셀 단위 레이블 분류에 더해, 같은 클래스에 속하더라도 서로 다른 객체를 개별적으로 분리하는 task이다.
Object Detection이 박스 단위로 객체를 구분하고 Semantic Segmentation이 픽셀 단위로 클래스를 나눈다면, Instance Segmentation은 두 성질을 모두 갖는다고 볼 수 있다.
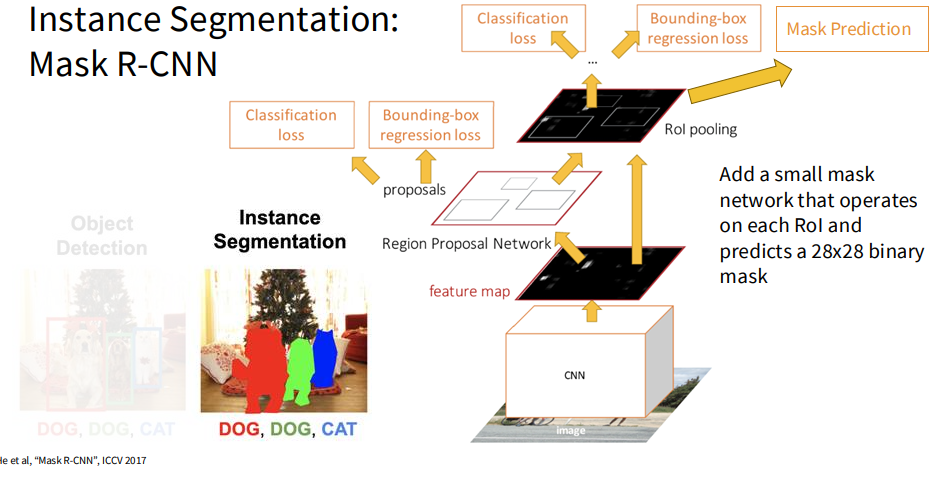
Mask R-CNN
한 줄로 요약하면 Faster R-CNN에 “마스크를 그리는 브랜치” 하나를 덧붙인 것이다.
Faster R-CNN은 각 후보 영역에 대해 두 가지를 예측했다.
- 이건 무슨 클래스인가? (분류)
-
박스를 어디로 옮겨야 하나? (회귀)
Mask R-CNN은 여기에 세 번째 문제를 추가한다. - 이 박스 안에서 어느 픽셀이 객체이고 어느 픽셀이 배경인가?
박스 안을 색칠하는 작업이 하나 더 붙은 것뿐이고, 나머지는 Faster R-CNN 그대로다.
전체 흐름
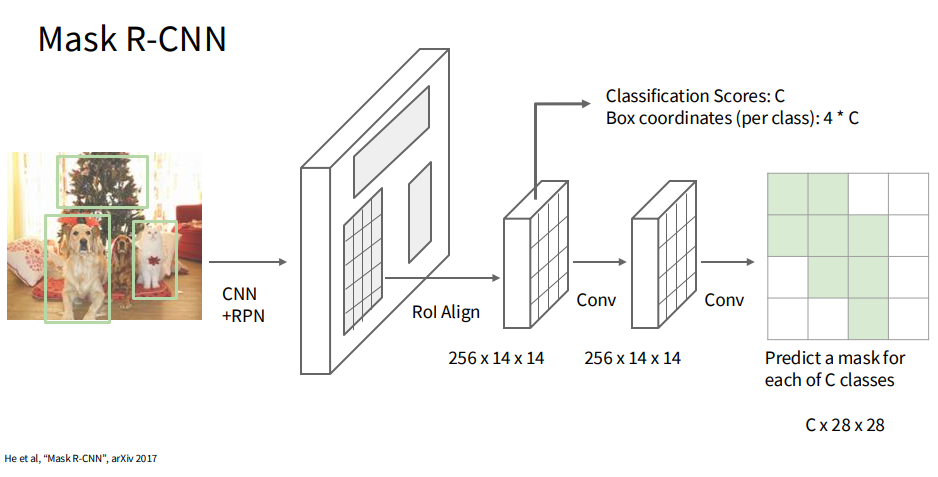
위 그림을 왼쪽부터 따라가면 된다.
1) CNN + RPN
입력 이미지를 백본 CNN에 통과시켜 특성맵을 만들고, RPN이 객체가 있을 만한 후보 영역을 뽑는다. Faster R-CNN과 완전히 동일하다.
2) RoIAlign
후보 영역을 특성맵에서 잘라내 고정 크기로 맞춘다. 그림에서는 채널 $256$, 크기 $14 \times 14$가 된다. Fast R-CNN의 RoI Pooling 자리를 대체한 것으로, 뒤에서 따로 설명한다.
3) 두 갈래로 분기
- 위쪽 (기존 헤드): 클래스 점수 $C$개와, 클래스별 박스 좌표 $4 \times C$개를 예측한다. 좌표가 클래스마다 따로 있는 이유는 “개일 때의 최적 박스”와 “고양이일 때의 최적 박스”가 다를 수 있기 때문이다.
- 아래쪽 (마스크 헤드): $256 \times 14 \times 14$ 특성맵에 Conv를 몇 번 더 적용한 뒤, 마지막에 크기를 두 배로 키워 $C \times 28 \times 28$ 마스크를 출력한다.
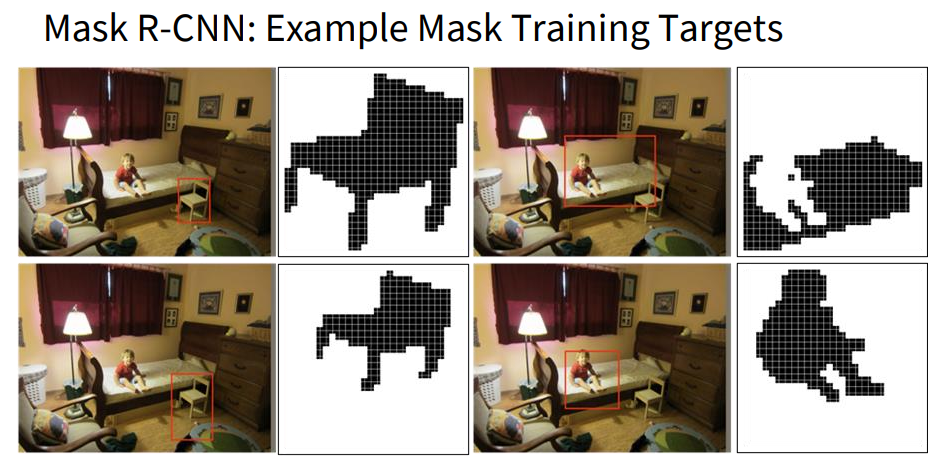
여기서 중요한 건 마스크가 클래스 개수 $C$장만큼 나온다는 점이다. 즉 “개일 경우의 마스크”, “고양이일 경우의 마스크”를 전부 그려놓는다.
왜 마스크를 클래스마다 따로 그릴까?
마스크를 한 장만 그리게 하면 그 브랜치가 “이 픽셀은 객체인가?”와 “무슨 객체인가?”를 동시에 풀어야 한다. 반면 클래스마다 한 장씩 그리게 하면, 각 마스크는 모양(shape)만 신경 쓰면 되고 클래스 판단은 위쪽 분류 헤드에 맡길 수 있다.
그래서 학습할 때도 $C$장 전부가 아니라 정답 클래스에 해당하는 한 장에 대해서만 손실을 계산한다. 나머지 $C-1$장은 그냥 무시된다. 추론할 때도 분류 헤드가 “개”라고 답하면 $C$장 중 개 마스크만 골라 쓴다.
\[L_{\text{mask}} = \text{(정답 클래스 마스크의 픽셀별 이진 분류 손실 평균)}\]각 픽셀은 softmax가 아니라 sigmoid로 0/1을 독립적으로 판단한다. 클래스끼리 경쟁시킬 필요가 없어졌기 때문이다. 논문은 이 분리가 성능 향상에 결정적이라고 보고했다.
RoIAlign: 반올림을 없앤 RoI Pooling
Mask R-CNN의 또 다른 핵심이다. 기존 RoI Pooling에는 반올림이 두 번 들어간다.
특성맵은 원본 이미지보다 해상도가 낮다. 예를 들어 원본 이미지를 $16$배 줄였다면, 원본의 $x = 100$은 특성맵에서 $100 \div 16 = 6.25$번째 칸에 해당한다. 그런데 특성맵에는 소수점 칸이 없으니 RoI Pooling은 이걸 $6$으로 잘라버린다. 그리고 이 영역을 여러 칸으로 나눌 때 또 한 번 반올림한다.
분류에서는 이 정도 오차가 별문제가 아니다. 박스가 조금 밀려도 “개”라는 답은 바뀌지 않는다. 하지만 마스크는 픽셀 단위로 정확히 맞춰야 하는 작업이라 치명적이다. 특성맵에서 한 칸 밀린 것이 원본 이미지에서는 16픽셀이 밀린 것이기 때문이다.
RoIAlign은 이 반올림을 전부 없앤다. $6.25$번째 위치를 그대로 두고, 주변 격자값들로 보간(bilinear interpolation)해서 그 지점의 값을 만들어낸다.
6번 칸과 7번 칸 사이 $0.25$ 지점의 값이 필요하면, 6번과 7번 값을 $3:1$로 섞어서 쓴다는 뜻이다.
RoI Pooling은 칸 안의 격자값 중 최댓값을 골랐지만, RoIAlign은 칸 경계가 소수라서 그럴 수가 없다. 대신 칸을 2×2로 나눠 각 조각의 중심에 점을 4개 찍고, 각 점의 값을 주변 격자로부터 보간해 만든 뒤 평균낸다.
손실 함수
세 가지 답을 하니 손실도 세 가지를 전부 더한다.
\[L = L_{\text{cls}} + L_{\text{box}} + L_{\text{mask}}\]추론 과정
- RPN이 후보 영역을 제안한다.
- 분류·회귀 헤드가 클래스와 보정된 박스를 예측하고, NMS로 겹치는 박스를 정리한다.
- 살아남은 박스에 대해서만 마스크 브랜치를 실행한다. (학습 때와 달리 RPN 제안이 아니라 보정이 끝난 최종 박스를 쓴다.)
- 예측된 클래스의 $28 \times 28$ 마스크를 골라 박스 크기로 확대하고, $0.5$를 기준으로 이진화한다.
확장: Human Pose Estimation
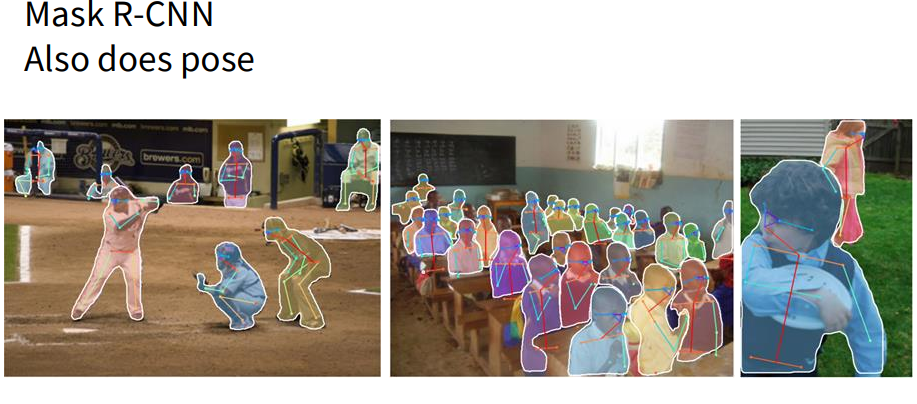
Human Pose Estimation은 사람 사진에서 어깨, 팔꿈치, 손목, 무릎 같은 관절의 위치를 찍어내는 작업이다. 찾아낸 점들을 순서대로 이으면 막대인간 형태의 뼈대가 만들어진다.
Mask R-CNN은 이 작업을 구조를 전혀 바꾸지 않고, 마스크 브랜치가 그리는 대상만 교체해서 수행한다.
핵심 아이디어: 관절 위치를 마스크로 표현한다
보통은 “팔꿈치가 $(x, y)$에 있다”를 좌표 회귀로 풀 것 같지만, Mask R-CNN은 그렇게 하지 않는다. 대신 정답을 격자에서 팔꿈치가 있는 칸만 $1$이고 나머지는 전부 $0$인 그림(one-hot 마스크)으로 만든다. 이렇게 하면 좌표를 맞히는 회귀 문제가 “어느 칸이 정답인지 고르는 분류 문제”로 바뀐다.
그래서 왼쪽 팔꿈치용 한 장, 오른쪽 무릎용 한 장… 이런 식으로 관절마다 한 장씩 총 $K$장을 출력한다. 마스크에서 클래스마다 한 장씩 그렸던 것과 완전히 같은 패턴이고, “클래스” 자리에 “관절”이 들어갔을 뿐이다.
마스크는 픽셀마다 독립적으로 판단하면 되지만, 관절은 정답 위치가 하나뿐이므로 칸들끼리 경쟁시켜야 한다. 그래서 마스크 한 장 안의 $m^2$개 픽셀 전체에 softmax를 적용한다.
| 마스크 | 키포인트 | |
|---|---|---|
| 질문 | 이 픽셀이 객체인가? | 관절이 어느 칸에 있는가? |
| 정답 픽셀 수 | 여러 개 | 정확히 하나 |
| 출력 함수 | 픽셀별 독립 sigmoid | 한 장 전체에 softmax |
| 장 수 | $C$장 (클래스 수) | $K$장 (관절 수) |
추론 과정
각 장에서 값이 가장 높은 칸을 하나씩 고르면 관절 $K$개의 좌표가 나오고, 어깨–팔꿈치–손목처럼 미리 정해진 연결 규칙에 따라 이으면 뼈대가 완성된다. 정확한 위치 예측이 필요한 작업이라 마스크($28 \times 28$)보다 높은 $56 \times 56$ 해상도를 사용한다.
이처럼 Mask R-CNN은 하나의 구조로 detection, instance segmentation, keypoint detection을 모두 처리할 수 있다.
강의 후반부의 Visualization & Understanding 내용은 별도 포스트에서 다룬다.