 hemisus

ResNet - Residual Network
“Deep Residual Learning for Image Recognition” 논문에서 발표된 딥러닝 모델로, 많은 레이어를 가지게 된 깊은 신경망을 효과적으로 학습시키기 위해 Residual Learning이라는 개념을 사용한 모델이다.
논문: Deep Residual Learning for Image Recognition
이후에 등장한 많은 모델들에 영향을 준 아키텍쳐로, 논문을 읽고 직접 구현해보며, 공부한 내용을 정리해보았다.
1. ResNet의 등장 배경
AlexNet, VGGNet과 같은 CNN 기반 모델이 이미지 분류에서 좋은 성능을 내던 시절, 모델의 깊이(number of stacked layers)가 깊어질수록 이미지의 특징을 더 잘 추출하여 더 좋은 성능을 보인다는 것이 확인되었다.
그렇다면 무조건 모델의 레이어를 더 쌓는 것만으로 성능 향상을 이룰 수 있는 것일까? 아래의 그림(Figure 1)은 단순히 모델을 더 깊게 설계한다고 해서 성능 향상은 이루어지지 않고, 오히려 error가 증가하여 성능이 저하된다는 점을 보여준다.
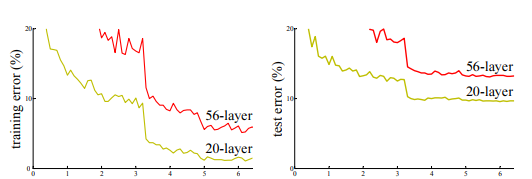
레이어를 더 쌓은 56-layer 모델이 20-layer 모델보다 오히려 training error와 test error 모두 높게 나타났다. 이는 overfitting의 문제가 아니라, 모델이 깊어질수록 optimize하기가 어려워지는 degradation 문제임을 의미한다.
Identity Mapping
이를 위한 기본 아이디어로 Identity Mapping이라는 개념이 등장한다.
얕은 모델이 깊은 모델보다 성능이 더 좋다면, 모델을 더 깊게 만들 때 얕은 모델이 내놓은 결과값을 최대한 유지하도록 레이어를 학습시키는 것이다.
즉 만약 어느 얕은 모델을 통과하여 x라는 결과 값이 있다면, 그 이후의 레이어를 통과한 결과 또한 x와 비슷한 값을 내놓는다면, 괜찮은 성능을 보이는 얕은 모델과 적어도 비슷하거나 더 좋은 성능을 내는 모델이 나올 것이다.
이를 수식을 통해 표현해보면, 레이어의 출력을 H(x)라 할 때 기존에는 H(x)=y, 즉 결과가 참 값이 되도록 학습 시켰다면, H(x)=x 가 되도록 학습을 시키는 것이다.
이때 H(x)는 그 레이어의 연산 f( )를 거친 결과물이므로, 레이어의 함수 f를 거쳤을 때 H(x)=f(x)=x가 되도록 학습시키는 것이다.
이러한 identity mapping개념은 ResNet 이전에도 제시되었으나, 실제로 f(x) = x로 학습시키는 것이 굉장히 어려웠다. 하지만 ResNet에서는 이 문제를 조금 다른 방향에서 접근한다.
2. Residual Learning
앞서 봤듯이, 우리가 원하는 것은 H(x) = x, 즉 레이어를 통과해도 값이 유지되는 identity mapping이다.
ResNet은 H(x)를 f(x) 그대로 사용하는 대신, 입력 x를 직접 더해준 H(x) = f(x) + x 로 재정의한다.
Identity Mapping의 목적에 따라 H(x)=x가 되는 것을 원하므로, 최종적으로 f(x)=H(x)-x=0, 즉 잔차(Residual)가 0이 되도록 학습시키는 것으로 목표가 바뀌었다.
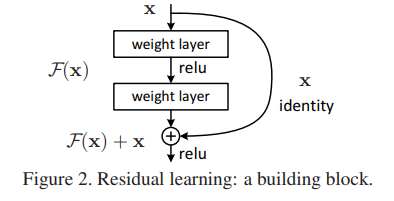
이렇게 구조를 바꿈으로써 생기는 장점은 다음과 같다:
- f(x)=x를 직접 학습하는 것보다 f(x) = 0을 학습하는 것이 훨씬 수월하다.
- 입력이 직접 다음 레이어로 전달되므로, 역전파 과정에서도 gradient가 Shortcut을 통해 직접 전달될 수 있다. 이로 인해 Gradient Vanishing 문제가 완화된다.
첫번째 장점에 대해 자세히 얘기하자면, 기존 방식은 레이어가 아무런 힌트 없이 처음부터 f(x) = x라는 답을 스스로 찾아야 했다. 반면 ResNet은 shortcut을 통해 x를 구조적으로 이미 더해주고 있기 때문에, 레이어는 “x에서 얼마나 더 조정해야 하는가”라는 작은 변화량만 학습하면 된다. 기준점이 주어진 상태에서 미세한 조정만 하면 되니 훨씬 수월한 것이다.
이렇게 하나 이상의 레이어를 건너 뛰어 입력 x를 출력에 더해주는 연결을 Skip Connection 혹은 Shortcut이라고 한다. 논문의 ResNet 기본 구조에서는 weight layer 2개를 건너뛰게 설계되었다. (ResNet-50 이상은 3개로 바뀐다.) 기본적으로 이러한 Skip Connection과정이 생겨도 추가되는 모델의 파라미터가 전혀 없으며, dimension이 달라지는 경우에만 소량의 파라미터가 추가된다. (이후 Shorcut methods내용)
또한 이렇게 Skip Connection과 weight Layer, ReLU활성화 함수가 합쳐진 이 블록을 Residual Block이라고 부른다. ResNet은 이러한 Residual Block이 쌓여서 만들어지는 모델이다.
3. Network Architectures
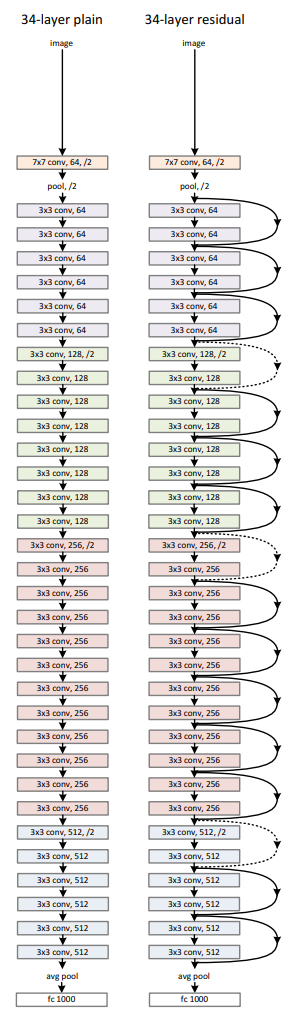
왼쪽은 Skip Connection이 없는 Plain Network, 오른쪽이 Residual Block으로 구성된 ResNet이다.
Skip Connection(Shortcut)의 유무 이외에 다른 설계 원칙은 다음과 같이 동일하다:
-
VGGNet에서 영감을 받은 구조로, 3x3 kernel(filter)을 사용한다.
-
Skip Connection은 input과 output의 형태가 동일해야 하기에, 합성곱 연산 전후 특성맵의 shape과 filter의 갯수가 유지되도록 한다.
-
합성곱 연산에서 stride=2를 통해 특성 맵의 크기가 절반으로 줄어들 경우, 연산량을 일정하게 보존하기 위해 filter의 수 또한 2배로 늘린다.
-
3에서 특성맵의 크기가 줄어들면 skip connection을 그대로 적용할 수 없다. 이를 위해 shape을 맞추는 과정이 동반된다. (점선 화살표 부분) 아래의 내용에서 자세히 설명한다.
Shortcut methods
a) shortcut의 채널 수를 맞추기 위해 zero-padding을 추가하고, feature map 크기를
맞추기 위해 stride=2를 적용하여 더해준다.
기존에 x가 (28×28×64) (64개의 채널)이었다면 출력은 (14×14×128) (128개의 채널) 이어야 하므로, 부족한 64개 채널을 값이 전부 0인 feature map으로 채워서 128개를 맞춰주는 것이다.
이 방법은 추가되는 파라미터가 없다는 장점이 있으나, 0으로 채운 채널은 학습된 정보가 없다는 한계가 존재한다.
b) 1×1 conv(stride=2)를 shortcut에 적용하여 feature map의 크기와 채널 수를 출력과
동일하게 맞춰준 뒤 더해준다.
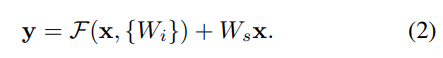
Ws가 바로 정사영(projection)에 해당하는 1×1 conv 레이어이다.
입력 x의 shape이 (28×28×64)이고 출력이 (14×14×128)이라면, 둘을 그대로 더할 수 없으니까 x에 1×1 conv를 stride=2로 적용해서 shape을 (14×14×128)로 맞춰준다.
이 방법은 학습해야하는 파라미터 수가 약간 추가된다. 본 구현과 ImageNet 실험에서는 b) 방법을 사용한다.
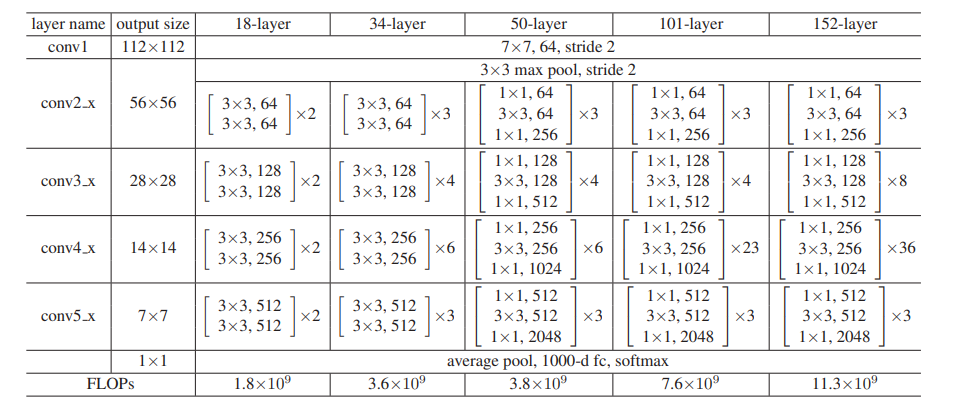
ResNet은 레이어의 깊이에 따라 ResNet-18, 34, 50, 101, 152 등 다양한 종류로 나뉘며, 그 구조는 아래 Table과 같다.
Bottleneck Block
위의 Table을 보면 ResNet 34-layer까지는 한 Residual Block에 3x3 Convolution 레이어가 2개 있는 구조였다면, 50-layer부터는 1x1, 3x3, 1x1 Convolution으로 총 3개의 레이어가 있는 구조인 것을 확인할 수 있다.
같은 구조의 block을 계속해서 쌓을 경우 파라미터의 수가 매우 많아지기 때문에, 연산량과 파라미터 수를 줄이면서도 층을 더 깊게 쌓기 위해 도입된 구조가 Bottleneck 구조이다.
-
1×1 Conv (차원 축소): 입력 레이어의 채널 수를 크게 줄임. (예: 256 → 64)
-
3×3 Conv (특징 추출): 채널 수가 줄어든 상태에서 공간적 특징을 추출.
-
1×1 Conv (차원 복원): 채널 수를 확장하여 Residual Connection과 크기를 맞춤 (예: 64 → 256)
4. PyTorch 구현 코드
PyTorch의 torchvision에 있는 ResNet 구현 코드를 기반으로 작성하였다.
Convolution layer
기본적인 convolution layer를 미리 정의한다.
def conv3x3(in_planes, out_planes, stride=1, groups=1, dilation=1):
    """3x3 convolution with padding"""
    return nn.Conv2d(in_planes, out_planes, kernel_size=3, stride=stride,
                     padding=dilation, groups=groups, bias=False, dilation=dilation)


def conv1x1(in_planes, out_planes, stride=1):
    """1x1 convolution"""
    return nn.Conv2d(in_planes, out_planes, kernel_size=1, stride=stride, bias=False)
BasicBlock
기본적인 Residual Block구조이다. forward()를 보면 F(x) + x가 마지막에 활성화 함수를 통과하는 ResNet v1의 방식이다.
\[H(x) = F(x) + x\] \[y = \mathrm{ReLU}(H(x))\]class BasicBlock(nn.Module):
expansion = 1
def __init__(self, inplanes, planes, stride=1, downsample=None, groups=1,
base_width=64, dilation=1, norm_layer=None):
super(BasicBlock, self).__init__()
if norm_layer is None:
norm_layer = nn.BatchNorm2d
self.conv1 = conv3x3(inplanes, planes, stride)
self.bn1 = norm_layer(planes)
self.relu = nn.ReLU(inplace=True)
self.conv2 = conv3x3(planes, planes)
self.bn2 = norm_layer(planes)
self.downsample = downsample
self.stride = stride
def forward(self, x):
identity = x
out = self.conv1(x)
out = self.bn1(out)
out = self.relu(out)
out = self.conv2(out)
out = self.bn2(out)
if self.downsample is not None:
identity = self.downsample(x)
out += identity
out = self.relu(out)
return out
Bottleneck
해당 원본 코드의 주석을 보면 stride=2의 conv연산을 3x3레이어에서 수행한다고 쓰여있는데, 이 말은 논문에서 첫 1x1 Conv에서 stride=2를 적용해 공간정보를 압축하던 것을 3x3으로 옮겼다는 의미이다.
이 구조가 더 정확성이 높아 개선된 구조이다.
class Bottleneck(nn.Module):
    expansion = 4

    def __init__(self, inplanes, planes, stride=1, downsample=None, groups=1,
                 base_width=64, dilation=1, norm_layer=None):
        super(Bottleneck, self).__init__()
        norm_layer = nn.BatchNorm2d
        width = int(planes * (base_width / 64.)) * groups

        self.conv1 = conv1x1(inplanes, width)
        self.bn1 = norm_layer(width)
        self.conv2 = conv3x3(width, width, stride, groups, dilation)
        self.bn2 = norm_layer(width)
        self.conv3 = conv1x1(width, planes * self.expansion)
        self.bn3 = norm_layer(planes * self.expansion)
        self.relu = nn.ReLU(inplace=True)
        self.downsample = downsample
        self.stride = stride

    def forward(self, x):
        identity = x

        out = self.conv1(x)
        out = self.bn1(out)
        out = self.relu(out)

        out = self.conv2(out)
        out = self.bn2(out)
        out = self.relu(out)

        out = self.conv3(out)
        out = self.bn3(out)

        if self.downsample is not None:
            identity = self.downsample(x)

        out += identity
        out = self.relu(out)

        return out
ResNet
위에서 정의한 BasicBlock 또는 Bottleneck Block을 이용하여 전체 네트워크를 구성하는 클래스이다.
입력 이미지에 대해 초기 Convolution과 MaxPooling을 수행한 후, 4개의 Residual Layer를 통과시켜 특징을 추출한다. 이후 Average Pooling을 통해 공간 정보를 1×1 크기로 압축하고, FCN을 통과하여 최종 분류를 수행한다.
class ResNet(nn.Module):

    def __init__(self, block, layers, num_classes=1000, zero_init_residual=False,
                 groups=1, width_per_group=64, replace_stride_with_dilation=None,
                 norm_layer=None):
        super(ResNet, self).__init__()
        norm_layer = nn.BatchNorm2d
        self._norm_layer = norm_layer
        self.inplanes = 64
        self.dilation = 1
        if replace_stride_with_dilation is None:
            replace_stride_with_dilation = [False, False, False]

        self.groups = groups
        self.base_width = width_per_group
        self.conv1 = nn.Conv2d(3, self.inplanes, kernel_size=7, stride=2, padding=3,
                               bias=False)
        self.bn1 = norm_layer(self.inplanes)
        self.relu = nn.ReLU(inplace=True)
        self.maxpool = nn.MaxPool2d(kernel_size=3, stride=2, padding=1)
        self.layer1 = self._make_layer(block, 64, layers[0])
        self.layer2 = self._make_layer(block, 128, layers[1], stride=2,
                                       dilate=replace_stride_with_dilation[0])
        self.layer3 = self._make_layer(block, 256, layers[2], stride=2,
                                       dilate=replace_stride_with_dilation[1])
        self.layer4 = self._make_layer(block, 512, layers[3], stride=2,
                                       dilate=replace_stride_with_dilation[2])
        self.avgpool = nn.AdaptiveAvgPool2d((1, 1))
        self.fc = nn.Linear(512 * block.expansion, num_classes)

        for m in self.modules():
            if isinstance(m, nn.Conv2d):
                nn.init.kaiming_normal_(m.weight, mode='fan_out', nonlinearity='relu')
            elif isinstance(m, (nn.BatchNorm2d, nn.GroupNorm)):
                nn.init.constant_(m.weight, 1)
                nn.init.constant_(m.bias, 0)

    def _make_layer(self, block, planes, blocks, stride=1, dilate=False):
        norm_layer = self._norm_layer
        downsample = None
        previous_dilation = self.dilation
        if dilate:
            self.dilation *= stride
            stride = 1
        if stride != 1 or self.inplanes != planes * block.expansion:
            downsample = nn.Sequential(
                conv1x1(self.inplanes, planes * block.expansion, stride),
                norm_layer(planes * block.expansion),
            )

        layers = []
        layers.append(block(self.inplanes, planes, stride, downsample, self.groups,
                            self.base_width, previous_dilation, norm_layer))
        self.inplanes = planes * block.expansion
        for _ in range(1, blocks):
            layers.append(block(self.inplanes, planes, groups=self.groups,
                                base_width=self.base_width, dilation=self.dilation,
                                norm_layer=norm_layer))

        return nn.Sequential(*layers)

    def _forward_impl(self, x):
        x = self.conv1(x)
        x = self.bn1(x)
        x = self.relu(x)
        x = self.maxpool(x)

        x = self.layer1(x)
        x = self.layer2(x)
        x = self.layer3(x)
        x = self.layer4(x)

        x = self.avgpool(x)
        x = torch.flatten(x, 1)
        x = self.fc(x)
        return x
self.inplanes
self.inplanes는 현재 Layer의 입력 채널 수를 의미한다. 첫 번째 Convolution의 출력 채널 수가 64이므로 초기값은 64로 설정된다.
이후 _make_layer()에서 첫 번째 Block이 생성된 후
self.inplanes = planes * block.expansion
을 통해 다음 Layer의 입력 채널 수로 갱신된다.
예를 들어 Bottleneck의 경우 expansion = 4 이므로 다음과 같이 채널 수가 증가한다.
64 → 256
128 → 512
256 → 1024
512 → 2048
_make_layer()
self.layer1 = self._make_layer(block, 64, layers[0])
self.layer2 = self._make_layer(block, 128, layers[1], stride=2)
self.layer3 = self._make_layer(block, 256, layers[2], stride=2)
self.layer4 = self._make_layer(block, 512, layers[3], stride=2)
이 함수는 여러 개의 Residual Block을 묶어 하나의 Layer를 생성한다. 예를 들어 ResNet50에서는
layers = [3, 4, 6, 3]
이 전달되므로 아래와 같이 레이어가 생성된다.
Layer1 : Bottleneck 3개
Layer2 : Bottleneck 4개
Layer3 : Bottleneck 6개
Layer4 : Bottleneck 3개
ResNet50의 특성맵 변화
| Stage | Output Shape |
|---|---|
| Input | 3 × 224 × 224 |
| Conv1 | 64 × 112 × 112 |
| MaxPool | 64 × 56 × 56 |
| Layer1 | 256 × 56 × 56 |
| Layer2 | 512 × 28 × 28 |
| Layer3 | 1024 × 14 × 14 |
| Layer4 | 2048 × 7 × 7 |
| AvgPool | 2048 × 1 × 1 |
| FC | 1000 |
정리
ResNet은 Skip Connection을 통해 Residual Learning을 수행해 깊은 신경망에서도 안정적인 학습이 가능하도록 만든 모델이다. Identity Mapping을 직접 학습하는 대신 Residual을 학습하도록 설계하여 Degradation 문제를 해결했으며, 이후 다양한 후속 연구의 기반이 되었다.