 hemisus

논문 정보
- 제목: An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale
- arXiv: 2010.11929
Abstract
트랜스포머(Transformer) 아키텍처는 자연어처리(NLP) 분야에서 사실상 표준으로 자리잡았지만, 컴퓨터 비전(CV) 분야에서의 적용은 아직 제한적이다. (논문 시점 기준) 기존 연구들은 CNN과 attention을 함께 사용하거나 CNN의 일부 구성 요소만 attention으로 대체하는 정도였고, 전체적인 CNN 구조 자체는 그대로 유지하는 경우가 많았다.
본 논문은 이러한 CNN에 대한 의존이 반드시 필요한 것은 아니며, 이미지 패치(patch) 시퀀스에 순수한 트랜스포머를 직접 적용하는 것만으로도 이미지 분류 태스크에서 매우 좋은 성능을 얻을 수 있음을 보인다. 대량의 데이터로 사전학습(pre-training)한 뒤 ImageNet, CIFAR-100, VTAB 등 이미지 인식 벤치마크로 전이(transfer)했을 때, Vision Transformer(ViT)는 기존 SOTA CNN 대비 적은 연산 자원으로도 대등하거나 더 뛰어난 성능을 달성했다.
1. Introduction
NLP에서의 트랜스포머 확장 성공에 영감을 받아, 본 논문은 최소한의 구조 변경만으로 표준 트랜스포머를 이미지에 직접 적용한다. 이를 위해 이미지를 여러 개의 패치(patch)로 나누고, 이 패치들을 선형 임베딩(linear embedding)한 시퀀스를 트랜스포머의 입력으로 사용한다. 즉, 이미지 패치를 NLP의 토큰(단어)과 동일한 방식으로 취급하는 것이다. 모델은 지도학습(supervised) 방식의 이미지 분류로 학습된다.
ImageNet과 같은 중간 규모 데이터셋으로 강한 정규화(regularization) 없이 학습할 경우, ViT는 비슷한 크기의 ResNet보다 살짝 낮은 아쉬운 정확도를 보인다. 이는 어느 정도 예상 가능한 결과인데, 트랜스포머는 CNN이 태생적으로 갖고 있는 귀납적 편향(inductive bias) - 이동 등변성(translation equivariance)과 지역성(locality)을 갖고 있지 않기 때문에, 데이터 양이 충분하지 않으면 일반화 성능이 떨어지는 것으로 보인다.
그러나 더 큰 규모의 데이터셋(1,400만~3억 장)으로 학습하면 더 좋은 성능을 보여줬다.
Inductive Bias(귀납적 편향)
귀납적 편향이란, 모델이 학습 데이터에서 보지 못한 입력에 대해 일반화할 때 사용하는 ‘모델 구조에 미리 내장된 가정 또는 제약’을 말한다. CNN은 이미지에 특화된 두 가지 강한 귀납적 편향을 갖는다.
-
지역성(Locality): convolution 연산은 작은 커널(예: 3x3)로 이미지의 국소 영역만 보고 특징을 뽑는다. “의미 있는 패턴(엣지, 질감)은 가까운 픽셀들 사이에서 나온다”는 가정이 구조적으로 내장되어 있다.
-
이동 등변성(Translation Equivariance): 동일한 필터가 이미지 전체를 슬라이딩하며 적용되므로, 객체의 위치가 이동해도 그에 대응해 특징맵도 같은 방식으로 이동한다.
덕분에 CNN은 비교적 적은 데이터로도 이미지의 공간 구조를 잘 학습한다.
반면 ViT의 self-attention은 원칙적으로 모든 패치가 서로 전역적(global)으로 상호작용하고, 위치 정보도 학습 가능한 position embedding으로만 부여될 뿐 CNN처럼 구조적으로 강제되지 않는다. “가까운 패치끼리 더 관련 있다”거나 “패턴은 위치가 바뀌어도 동일하게 인식돼야 한다”는 가정을 모델이 미리 갖고 있지 않으므로, 트랜스포머는 이런 공간적 관계를 데이터로부터 처음부터 스스로 학습해야 한다.
2. Method
2.1. Vision Transformer (ViT)
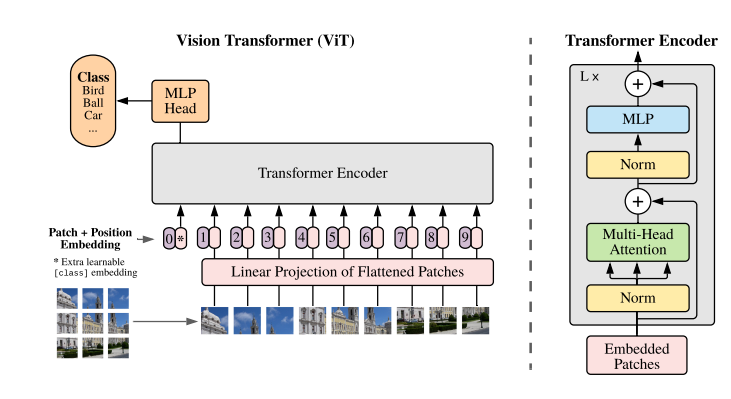
트랜스포머는 원래 1차원 토큰 임베딩 시퀀스를 입력으로 받는다. 이미지(2D 데이터)를 트랜스포머에 넣기 위해, ViT는 이미지를 여러 개의 고정 크기의 패치로 나눈 뒤 각 패치를 1차원 벡터처럼 취급한다.
- 원본 이미지: $\mathbf{x} \in \mathbb{R}^{H \times W \times C}$
- $H, W$: 이미지의 세로/가로 해상도
- $C$: 채널 수 (RGB면 3)
이를 flatten된 2D 패치들의 시퀀스로 reshape:
\[\mathbf{x}_p \in \mathbb{R}^{N \times (P^2 \cdot C)}\]- $(P, P)$: 패치 하나의 해상도 (예: 16×16)
- $N = HW / P^2$: 패치 개수 –> 이 값이 곧 트랜스포머의 시퀀스 길이(sequence length) 가 된다. (이미지가 $P \times P$ 크기의 “단어” $N$개로 쪼개지는 것)
- 패치 하나당 차원은 $P^2 \cdot C$ (패치를 펼쳐서 1차원 벡터로 만든 크기)
예를 들어 224×224×3 이미지를 16×16 패치로 나누면, $N = (224/16)^2 = 196$개의 패치가 생기고 패치 하나의 차원은 $16 \times 16 \times 3 = 768$이 된다.
Patch Embedding (Eq. 1)
트랜스포머는 모든 레이어에서 고정된 잠재 벡터 크기 $D$ 를 사용한다. 따라서 각 패치($P^2 \cdot C$ 차원)를 학습 가능한 선형 변환 $E$를 통해 $D$ 차원으로 매핑한다.
\[\mathbf{z}_0 = [\mathbf{x}_{\text{class}}; \; \mathbf{x}_p^1 \mathbf{E}; \; \mathbf{x}_p^2 \mathbf{E}; \; \cdots; \; \mathbf{x}_p^N \mathbf{E}] + \mathbf{E}_{pos} \tag{1}\] \[\mathbf{E} \in \mathbb{R}^{(P^2 \cdot C) \times D}, \qquad \mathbf{E}_{pos} \in \mathbb{R}^{(N+1) \times D}\]- $\mathbf{x}_p^i \mathbf{E}$: $i$번째 패치를 $D$차원으로 투영한 것. Patch embedding이라 부른다.
- $\mathbf{x}_{\text{class}}$: 맨 앞에 붙이는 학습 가능한 class 토큰 (아래에서 설명)
- $\mathbf{E}_{pos}$: 각 위치(패치)에 더해지는 position embedding. 시퀀스 길이가 $N+1$인 이유는 class 토큰까지 포함하기 때문.
- 결과적으로 $\mathbf{z}_0 \in \mathbb{R}^{(N+1) \times D}$ - 이 텐서가 트랜스포머 인코더의 입력이 된다.
Position Embedding
$\mathbf{E}_{pos}$는 D차원 벡터 하나가 아니라, $(N+1)$개의 행(row)을 가진 학습 가능한 룩업 테이블(lookup table) 이다. 행 하나하나가 각각 D차원 벡터이고, 몇 번째 위치인지(0번=class 토큰, 1번=첫 패치, 2번=두 번째 패치…)에 따라 해당 행이 선택되어 그 위치의 patch embedding에 더해진다.
\[\mathbf{z}_0^i = \mathbf{x}_p^i \mathbf{E} + \mathbf{E}_{pos}^{(i)}, \qquad i = 0, 1, \ldots, N\]여기서 \(\mathbf{E}_{pos}^{(i)} \in \mathbb{R}^D\) 는 $\mathbf{E}_{pos}$ 행렬의 $i$ 번째 행이다. 즉 패치 196개짜리 시퀀스(class 토큰 포함 197개)라면, 서로 다른 197개의 D차원 벡터가 각각 학습되는 것이지, 모든 위치에 동일한 벡터가 더해지는 게 아니다.
기본 트랜스포머는 사인/코사인 함수로 만든 고정된(fixed) position encoding을 사용했다면, ViT는 이 값들을 랜덤 초기화 후 역전파로 학습시키는 것이다.
논문의 “1D”라는 표현은 벡터의 차원이 1차원이라는 뜻이 아니라, 패치들을 (row, col) 같은 2차원 좌표가 아닌 순서(1차원 인덱스, raster order)로만 구분한다는 뜻이다. 즉 14x14로 배열된 패치라도 위치를 2차원으로 인코딩하지 않고 1번, 2번, …, 196번처럼 일렬로 펴서 각각 독립적인 벡터를 학습시킨다.(2D-aware PE를 해도 큰 성능향상을 발견하지 못함. Appendix D.4)
여기까지 기억해야할 점은 patch embedding($\mathbf{E}$)과 position embedding($\mathbf{E}_{pos}$) 모두 완전히 학습되는 파라미터라는 것이다. 초기화 시점에는 위치 정보가 전혀 없고, 2D 공간 관계는 학습을 통해 처음부터 습득해야 한다.
Transformer Encoder (Eq. 2, 3, 4)
인코더는 Multi-head Self-Attention(MSA) 블록과 MLP 블록이 번갈아 쌓인 구조다. 각 블록 앞에는 LayerNorm(LN)이, 각 블록 뒤에는 residual connection이 적용된다.
\[\mathbf{z}'_\ell = \text{MSA}(\text{LN}(\mathbf{z}_{\ell-1})) + \mathbf{z}_{\ell-1}, \qquad \ell = 1 \ldots L \tag{2}\] \[\mathbf{z}_\ell = \text{MLP}(\text{LN}(\mathbf{z}'_\ell)) + \mathbf{z}'_\ell, \qquad \ell = 1 \ldots L \tag{3}\] \[\mathbf{y} = \text{LN}(\mathbf{z}_L^0) \tag{4}\]- $L$: 인코더 레이어(블록) 개수
- \(\mathbf{z}_{\ell-1}, \mathbf{z}_\ell \in \mathbb{R}^{(N+1) \times D}\) - 레이어를 통과해도 shape은 그대로 유지된다.
- MLP는 GELU 비선형성을 사용하는 2개의 완전연결층으로 구성 (보통 중간에 차원을 확장했다가 다시 $D$로 축소, 예: $D \to 4D \to D$)
- 식 (4)에서 $\mathbf{z}_L^0$은 마지막 레이어 출력 시퀀스의 0번째 벡터, 즉 class 토큰 위치의 출력만 뽑아낸 것이다. 여기에 최종 LayerNorm을 적용한 것이 이미지 전체를 표현하는 벡터 $\mathbf{y}$가 된다.
[class] token
BERT의 [CLS] 토큰과 동일한 아이디어다. 패치 임베딩 시퀀스 $N$개만 있으면 “이미지 전체를 대표하는 하나의 벡터”가 없다. 그래서 학습 가능한 벡터 \(\mathbf{x}_{\text{class}}\)를 시퀀스 맨 앞에 인위적으로 추가한다 (\(\mathbf{z}_0^0 = \mathbf{x}_{\text{class}}\)).
- 이 토큰도 다른 패치 토큰들과 동일하게 self-attention에 참여한다. 즉 모든 레이어에서 다른 패치들의 정보를 attention을 통해 수집한다.
- $L$개의 레이어를 다 통과하고 나면, 이 위치의 최종 출력 $\mathbf{z}_L^0$이 이미지 전체의 표현(representation) $\mathbf{y}$으로 사용된다 (식 4).
- 분류를 할 때는 이 $\mathbf{y}$에 classification head를 붙인다:
- 사전학습(pre-training) 시: hidden layer 1개짜리 MLP (tanh 활성함수)
- 미세조정(fine-tuning) 시: 단순한 linear layer 1개
요약
| 단계 | 연산 | Shape |
|---|---|---|
| 원본 이미지 | — | $H \times W \times C$ |
| 패치로 분할 | reshape | $N \times (P^2 \cdot C)$ |
| Patch embedding | $\mathbf{x}_p \mathbf{E}$ | $N \times D$ |
| class 토큰 추가 | concat | $(N+1) \times D$ |
| Position embedding 추가 | $+ \mathbf{E}_{pos}$ | $(N+1) \times D$ |
| 인코더 통과 ($L$회 반복) | MSA + MLP | $(N+1) \times D$ (shape 불변) |
| 최종 표현 추출 | $\mathbf{z}_L^0$ 선택 + LN | $1 \times D$ |
| 분류 | MLP / Linear head | $1 \times K$ (K = 클래스 수) |
2.2. Fine-tuning and Higher Resolution
ViT는 일반적으로 대규모 데이터셋으로 사전학습(pre-training) 한 뒤, 이보다 작은 다운스트림 태스크로 미세조정(fine-tuning) 하는 2단계 방식을 따른다.
Classification Head 교체
- 사전학습 때 class 토큰 뒤에 붙어있던 예측 head(hidden layer 1개짜리 MLP)를 제거한다.
- 대신 0으로 초기화된 $D \times K$ 크기의 feedforward(linear) layer를 새로 붙인다.
- $D$: hidden size (패치 임베딩 차원)
- $K$: 다운스트림 태스크의 클래스 개수 (예: 사전학습은 ImageNet-21k의 21,000개 클래스였지만, 미세조정 대상이 CIFAR-10이면 $K=10$)
- 0으로 초기화하는 이유는, 학습 초반에 head의 출력이 무작위로 요동치지 않고 사전학습된 표현($\mathbf{y} = \text{LN}(\mathbf{z}_L^0)$)을 안정적으로 활용하며 서서히 적응하도록 하기 위함이다. (?)
더 높은 해상도로 파인튜닝
선행 연구(Touvron et al., 2019; Kolesnikov et al., 2020)에 따르면, 사전학습보다 더 높은 해상도의 이미지로 파인튜닝하면 성능이 향상되는 경우가 많다 (예: 224×224로 사전학습 후 384×384 또는 512×512로 파인튜닝).
이때 패치 크기 $P$는 그대로 유지한다. 해상도 $H, W$가 커지는데 $P$가 고정이면:
\(N = \frac{HW}{P^2}\)
값이 커진다. 즉 트랜스포머의 유효 시퀀스 길이 $N$이 사전학습 때보다 늘어난다. (?)
문제: 사전학습된 Position Embedding이 더 이상 맞지 않음
ViT는 구조적으로 임의의 시퀀스 길이를 처리할 수 있다(메모리가 허용되는 한). Self-attention의 가중치 파라미터($\mathbf{U}_{qkv}$ 등)는 시퀀스 길이 $N$에 의존하는 shape을 갖지 않기 때문이다.
다만 position embedding $\mathbf{E}_{pos} \in \mathbb{R}^{(N+1)\times D}$는 사전학습 때의 시퀀스 길이에 맞춰 학습된 룩업 테이블이다. 파인튜닝에서 시퀀스 길이가 늘어나면 이 테이블의 행 개수가 부족해지고, 설령 억지로 맞춘다 해도 그 의미(어느 위치를 표현하는지)가 더 이상 유효하지 않다.
해결책: Position Embedding의 2D 보간(Interpolation)
이를 해결하기 위해, 사전학습된 position embedding들을 원본 이미지에서의 위치(2D 좌표, row/col)를 기준으로 2D 보간하여 늘어난 시퀀스 길이에 맞는 새로운 position embedding 집합을 만들어낸다.
- 예: 기존에 14×14 (196개)로 학습된 position embedding을, 24×24 (576개)로 보간해서 늘리는 방식.
- 이는 사전학습에서 학습된 “위치 간 유사도 패턴”(가까운 패치일수록 비슷한 embedding을 갖는 경향, Appendix D.4/Figure 7)을 최대한 보존하면서 크기만 확장하는 방법이다.
핵심 포인트: 유일하게 수동 주입되는 귀납적 편향
이 해상도 조정과 패치 추출(patch extraction)이, ViT에 이미지의 2D 구조에 대한 귀납적 편향(inductive bias)이 수동으로 주입되는 유일한 지점이다.
ViT는 CNN과 달리 2D 공간 구조에 대한 가정을 모델 구조 자체에 내장하지 않고, 원칙적으로 모든 공간 관계를 데이터로부터 학습하도록 설계되었다. 그런데 예외적으로 딱 두 곳에서만 사람이 “이건 2차원 이미지다”라는 사전 지식을 명시적으로 반영한다.
- 패치 추출 (초기 시점): 이미지를 1차원으로 늘어놓지 않고 애초에 $P \times P$ 정사각형 패치로 잘라내는 것 자체가 “이미지는 2D 격자 구조를 갖는다”는 가정을 반영한 것.
- Position embedding의 2D 보간 (미세조정 시점): 새로운 위치의 embedding 값을 채울 때, 단순히 1차원 순서로 나열하는 게 아니라 원본 이미지의 2D 좌표 관계를 기준으로 보간.
이 두 지점을 제외하면, self-attention 연산이나 position embedding 학습 등 나머지 모든 부분은 2D 구조에 대한 어떠한 가정도 없이 순수하게 데이터로부터 학습된다.