 hemisus

Dictionary
key-element 쌍의 집합을 저장하는 자료구조. 동일한 key를 가진 항목이 여러 개 허용됨.
| 메서드 | 설명 |
|---|---|
find(k) |
key k를 가진 항목의 iterator 반환. 없으면 end 반환 |
put(k, o) |
(k, o) 삽입 후 iterator 반환 |
erase(k) |
key k를 가진 항목 제거 |
size(), empty() |
크기 확인 |
Dictionary 구현 방식 비교
Log File (Unsorted list 기반)
임의 순서로 항목을 저장하는 비정렬 시퀀스.
| 연산 | 복잡도 | 이유 |
|---|---|---|
put |
O(1) | 맨 앞/뒤에 그냥 삽입 |
find |
O(n) | 전체 탐색 필요 |
erase |
O(n) | 전체 탐색 후 제거 |
적합한 경우: 삽입이 압도적으로 많고 탐색/삭제가 드문 경우 (e.g. 로그인 기록)
Search Table (Sorted array 기반)
key 순서로 정렬된 배열.
| 연산 | 복잡도 | 이유 |
|---|---|---|
find |
O(log n) | Binary Search 사용 |
put |
O(n) | 삽입 위치 뒤 원소들을 shift |
erase |
O(n) | 제거 후 원소들을 shift |
적합한 경우: 탐색이 압도적으로 많고 삽입/삭제가 드문 경우 (e.g. 신용카드 인증)
Binary Search
정렬된 배열 기반으로 구현할 경우 이진 탐색을 통해 find(k)를 O(log n)에 수행.
Algorithm BinarySearch(int[] S, k, l, h):
  if l > h:
    return null          // 탐색 실패
  m ← (l + h) / 2
  if S[m].key() = k:
    return S[m]          // 탐색 성공
  else if k < S[m].key():
    return BinarySearch(S, k, l, m-1)   // 왼쪽 절반
  else:
    return BinarySearch(S, k, m+1, h)   // 오른쪽 절반
- 매 단계마다 탐색 범위가 절반으로 줄어들며, $l = m = h$ 가 되면 종료
Hash Table
Hash Function
key를 정수 범위 [0, N-1]로 매핑하는 함수를 해쉬 함수라고 한다.
h(x) = x mod N(정수 key 예시)- h(x)의 결과를 hash value라 부름
- item (k, o)를 index
i = h(k)에 저장 - Hash Function은 보통 2단계로 구성됨
h(x) = h2(h1(x))
| 단계 | 함수 | 역할 |
|---|---|---|
| Hash code | h1: keys → integers | key를 정수로 변환 |
| Compression | h2: integers → [0, N-1] | 정수를 테이블 인덱스로 압축 |
Compression Function 종류
Division:
h2(y) = y mod N
- N은 소수(prime)로 선택 → key 패턴에 관계없이 균등 분산 보장
MAD (Multiply, Add and Divide):
h2(y) = (ay + b) mod N
- a, b는 음이 아닌 정수, 단
a mod N ≠ 0(아니면 모든 key가 b로 매핑됨)
Collision (충돌)
서로 다른 key가 같은 인덱스로 매핑되는 경우가 발생한다. 이때 다양한 방법으로 이를 처리하는 것이 요구됨.
Separate Chaining
각 셀에 linked list를 연결해 충돌 항목들을 저장.
테이블[i] → [entry1] → [entry2] → ...
구현은 간단하나 테이블 외부에 추가 메모리 필요
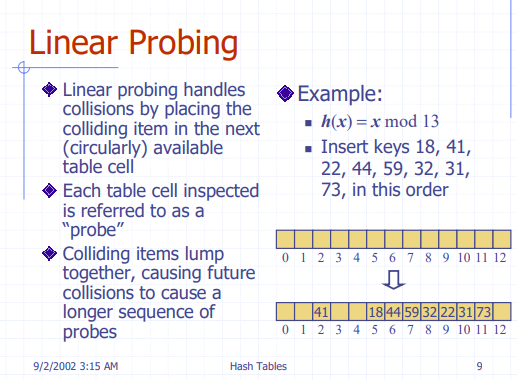
Linear Probing (Open Addressing)
충돌 시 테이블의 다음 빈 셀을 순환하며 탐색한다.
탐색 위치: (h(k) + j) mod N (j = 0, 1, 2, ...)
find(k) 알고리즘:
Algorithm find(k):
  i ← h(k)
  p ← 0
  repeat:
    c ← A[i]
    if c = ∅ → return null       // 빈 셀 → 탐색 실패
    if c.key() = k → return c    // 탐색 성공

    i ← (i + 1) mod N
    p ← p + 1
  until p = N
  return null
삭제 처리: AVAILABLE 레이블 사용
단순히 셀을 비우면 find가 중간에 끊겨 이후 항목을 찾지 못할 수도 있다.
→ 삭제 시 셀을 AVAILABLE로 표시.
find: AVAILABLE은 건너뛰고 계속 탐색(탐색 루프가 중단되지 않음)put: AVAILABLE 또는 빈 셀에 삽입
단점: 충돌 항목들이 뭉쳐서 클러스터를 형성 → 연쇄 충돌 발생 가능
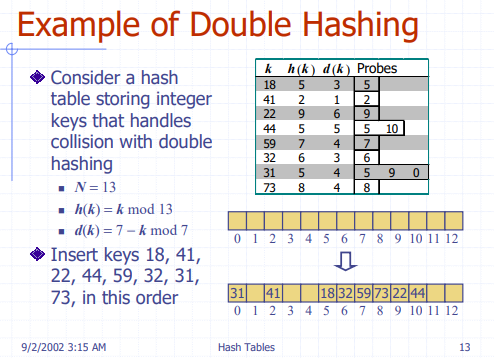
Double Hashing
두 번째 해시 함수 d(k)로 step size를 결정.
탐색 위치: (h(k) + j * d(k)) mod N (j = 0, 1, 2, ...)
h(k)  → 시작 위치
d(k)  → 건너뛸 간격 (step size)
두 함수 모두 원래 key k를 직접 입력으로 받음.
일반적인 d(k) 공식:
d(k) = q - (k mod q)
- d(k) ≠ 0 (0이면 무한루프)
- q는 N보다 작은 소수
- d(k)의 범위: 1 ~ q (0이 절대 안 나옴)
Hash Table 성능
| 항목 | 값 |
|---|---|
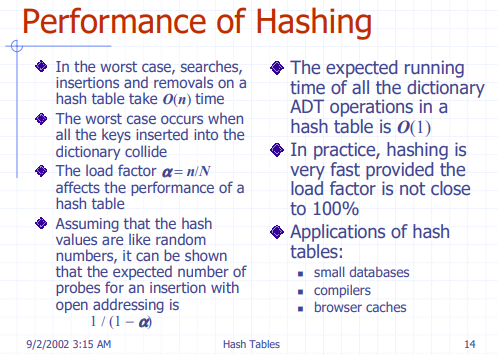
| 최악 복잡도 | O(n): 모든 key가 같은 셀로 충돌 |
| 기대 복잡도 | O(1): load factor가 낮을 때 |
Load Factor: α = n / N (저장된 항목 수 / 테이블 크기)
Open Addressing에서 삽입 시 기대 probe 횟수:
1 / (1 - α)
→ α가 1에 가까울수록 성능 급격히 저하. α를 낮게 유지하는 것이 중요.
소수(Prime)를 쓰는 이유
| 대상 | 소수 사용 이유 |
|---|---|
| N (테이블 크기) | 모든 셀 탐색 보장 + key 균등 분산 |
| q (d(k)의 mod) | step size 다양성 보장 (d(k) 범위 = 1~q) |
| 조건 | q < N |
구현 방식 최종 비교
| 구현 | find |
put |
erase |
적합한 상황 |
|---|---|---|---|---|
| Log File (unsorted) | O(n) | O(1) | O(n) | 삽입 위주 |
| Search Table (sorted) | O(log n) | O(n) | O(n) | 탐색 위주 |
| Hash Table | O(1) 기대 | O(1) 기대 | O(1) 기대 | 일반적인 경우 |