hemisus

원본 영상 및 자료
해당 영상에서는 “A Neural Probabilistic Language Model”(링크) 논문에서의 MLP를 이용하여 Character단위의 Trigram 모델을 구현한다.
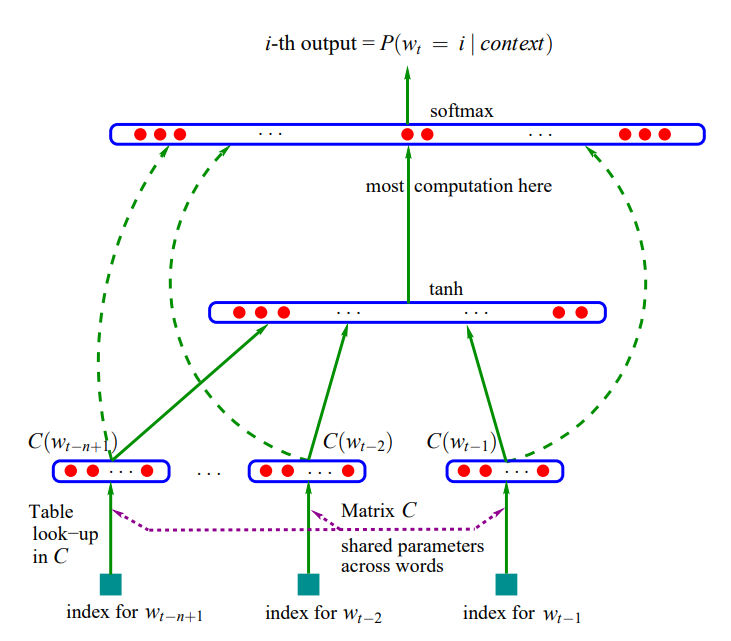
위의 사진과 비슷한 구조의 MLP를 구현할 것이며, 논문에서는 가까운 단어 3개를 인풋으로 사용하지만 영상에서는 글자를 단위로 구현하며, 각 글자에 대한 임베딩을 concat하여 input으로 사용한다.
1. 데이터 로드 및 Vocabulary 구축
words = open('names.txt', 'r').read().splitlines()
chars = sorted(list(set(''.join(words))))
stoi = {s:i+1 for i,s in enumerate(chars)}
stoi['.'] = 0
itos = {i:s for s,i in stoi.items()}
''.join(words): words에 있는 모든 단어를 공백 없이 하나의 긴 문자열로 합친다.- set(…): 문자열을 set 자료형으로 만들어 중복된 character를 모두 제거
- list(…) & sorted(…): 순서가 없는 set을 다시 리스트로 변환, a부터 z까지 오름차순으로 정렬한다.
이후 '.'을 0번 인덱스에 할당하고 stoi, itos를 생성.
2. 데이터셋 구축 (Sliding Window)
block_size = 3 # context length
X, Y = [], []
for w in words:
  context = [0] * block_size
  for ch in w + '.':
    ix = stoi[ch]
    X.append(context)
    Y.append(ix)
    context = context[1:] + [ix] # crop and append

X = torch.tensor(X)
Y = torch.tensor(Y)
각 단어 w에 대해, 처음 context는 모두 block_size만큼 . 이 반복된 형태를 가진다.
X에는 context를 할당하고, Y에는 현재 위치의 글자 인덱스를 할당한다. 이후 context = context[1:] + [ix]를 통해 맨 앞 글자는 잘라내고, 현재 [ix]를 추가하여 window를 한 칸씩 옆으로 이동시킨다.
3. Embedding Lookup Table
각 글자를 모델에 넣기 위해 인덱스에 해당하는 글자를 벡터로 변환하는 임베딩이 필요하다. 영상에서는 처음에 글자들을 모두 2차원의 벡터 공간에 담는다.
C = torch.randn((27, 2))
emb = C[X]
emb.shape  # torch.Size([228146, 3, 2])
C는 글자들의 임베딩 공간이다. 알파벳 26개 + 점(.) 1개로 27개의 글자 각각의 2차원 벡터 표현을 랜덤으로 선언한 것이다.
X는 2번 과정에서 만든 텐서이다. 각 샘플에서의 context가 담겨있으므로 [데이터개수, 3]의 shape을 가진다. ([0, 0, 5], [0, 5, 13]…)
여기서 emb = C[X]를 하게 되면, X 안에 적힌 숫자들을 행 번호로 간주하여 C에서 그 행들을 그대로 복사해 새 차원을 만들어 추가한다.
예를 들어 X 안에 [0, 5, 13]이 들어있다면 C의 0번째, 5번째, 13번째 행을 가져와 마지막 차원에 추가한다. 인덱스 하나가 들어있던 자리가 2차원 벡터로 바뀐 것이다.
최종적으로 emb의 형태는 [데이터개수, 3, 2]가 되며, 이러한 방식은 적은 연산량으로 효과적으로 범주형 변수를 벡터로 변환하는 유용한 인덱싱 방식이다.
4. 모델 구조 및 Loss (Cross Entropy)
W1 = torch.randn((6, 100))
b1 = torch.randn(100)
h = torch.tanh(emb.view(-1, 6) @ W1 + b1)
W2 = torch.randn((100, 27))
b2 = torch.randn(27)
logits = h @ W2 + b2
emb.view(-1, 6)을 통해 3차원 형태였던 임베딩을 2차원(글자 3개 $\times$ 2차원 = 6)으로 바꾼 뒤, Linear Layer 두 개와 tanh 활성화 함수를 통과시킨다. logits의 shape은 [데이터개수, 27]로, 각각의 sample에서 다음 character의 확률을 예측해내야 한다. 이를 위해 softmax를 사용한다.
counts = logits.exp()
prob = counts / counts.sum(1, keepdims=True)
이후 모델의 예측 확률(prob)과 실제 정답(Y) 간의 오차를 구하기 위해 Cross Entropy를 사용한다.
loss = -prob[torch.arange({데이터 개수}), Y].log().mean()
torch.arange({데이터 개수})를 통해 행 번호를 지정하고, Y를 통해 열 번호를 지정하여 정답 확률을 가져온다. 그 후 로그를 씌워 평균을 낸 후 음수를 취한다. (Negative Log Likelihood, NLL)
위 방식은 수학적으로는 완벽하지만, 파이썬 코드상으로는 치명적인 약점이 있다. 만약 logits에 100, 1000처럼 큰 값이 들어갈 경우, logits.exp()를 계산하는 과정에서 값이 무한대(inf)로 폭발하여 정상적인 계산이 불가능해진다(NaN 발생).
따라서 실제 Softmax 연산을 구현할 때는 수치적 안정성을 위해 배열 내 최댓값(max)을 모든 값에서 빼주는 방식으로 해결한다. 지수 함수의 특성 상 분모와 분자에 동일한 값을 곱해 상쇄시키는 원리다.
\[p_i = \frac{e^{x_i}}{\sum_{j} e^{x_j}} = \frac{e^{x_i} \cdot e^{-M}}{\sum_{j} (e^{x_j} \cdot e^{-M})} = \frac{e^{x_i - M}}{\sum_{j} e^{x_j - M}} \quad (\text{단, } M = \max(x))\]또한, 파이토치에서 제공하는 내장 함수인 F.cross_entropy를 사용하면 이 모든 과정을 한 번에 처리할 수 있다. 안정성 처리가 된 Softmax 연산이 포함되어 있는 손실함수이다(Softmax + Log + NLLLoss).
logits = h @ W2 + b2
loss = F.cross_entropy(logits, Ytr[ix])
5. 최적의 학습률 찾기
lre = torch.linspace(-3, 0, 1000)
lrs = 10**lre

# 학습 루프 내부
...
  lr = lrs[i]
  for p in parameters:
    p.data += -lr * p.grad
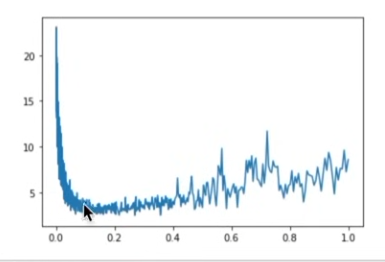
학습 루프를 돌면서 학습률을 작은 값($10^{-3}$)부터 큰 값($10^0$)까지 서서히 증가시키며 Loss의 변화를 추적하는 기법이다.
미니배치가 매번 바뀌기 때문에 Loss가 위아래로 흔들리는 노이즈는 분명 발생한다. 하지만 학습률이 변하면서 Loss에 미치는 영향력이 훨씬 커서, 그래프를 그려보면 Loss가 가장 가파르게 떨어지는 구간이 눈에 띄게 나타난다. 그 가파른 구간의 학습률(영상에서는 0.1 부근)을 최적의 초기 학습률로 채택한다.