 hemisus

원본 영상 및 자료
해당 영상에서는 모델의 학습과정에서 생길 수 있는 Activation/Gradient관련 문제점과, 원활한 학습을 위해 이를 어떻게 해결하는지 소개한다.
1. 이전 내용
이전 영상에서의 MLP코드 위에서 진행된다. block_size는 3으로 동일하고, 글자들의 임베딩 공간 C는 [27, 10]의 shape으로 각 character는 10차원의 공간에서 표현된다.
또한 MLP의 첫 hidden차원이 200으로 확장되었다.
block_size = 3
n_embd = 10 # the dimensionality of the character embedding vectors
n_hidden = 200 # the number of neurons in the hidden layer of the MLP

g = torch.Generator().manual_seed(2147483647) # for reproducibility
C  = torch.randn((vocab_size, n_embd),            generator=g)
W1 = torch.randn((n_embd * block_size, n_hidden), generator=g)
b1 = torch.randn(n_hidden,                        generator=g)
W2 = torch.randn((n_hidden, vocab_size),          generator=g)
b2 = torch.randn(vocab_size,                      generator=g)

parameters = [C, W1, W2, b1, b2]

for p in parameters:
  p.requires_grad = True
Xb는 각 샘플에서의 context가 담겨있어 [batch_size, 3]의 shape을 가진다. ([0, 0, 5], [0, 5, 13]…)
이를 C[Xb]로 임베딩하면 Xb 안의 숫자들을 행 번호로 간주하여 C에서 그 행들을 그대로 복사해 새 차원을 만들어 추가한다.
최종적으로 emb의 형태는 [batch_size, 3, 10]가 되며, embcat에서 context의 임베딩을 concat하여 [batch_size, 30]이 된다.
for i in range(max_steps):
  # minibatch construct
  ix = torch.randint(0, Xtr.shape[0], (batch_size,), generator=g)
  Xb, Yb = Xtr[ix], Ytr[ix] # batch X,Y

  # forward pass
  emb = C[Xb] # embed the characters into vectors
  embcat = emb.view(emb.shape[0], -1) # concatenate the vectors
2. Initialization
logits
현재 코드를 기반으로 학습을 시키며 loss를 출력해보면 다음과 같다.
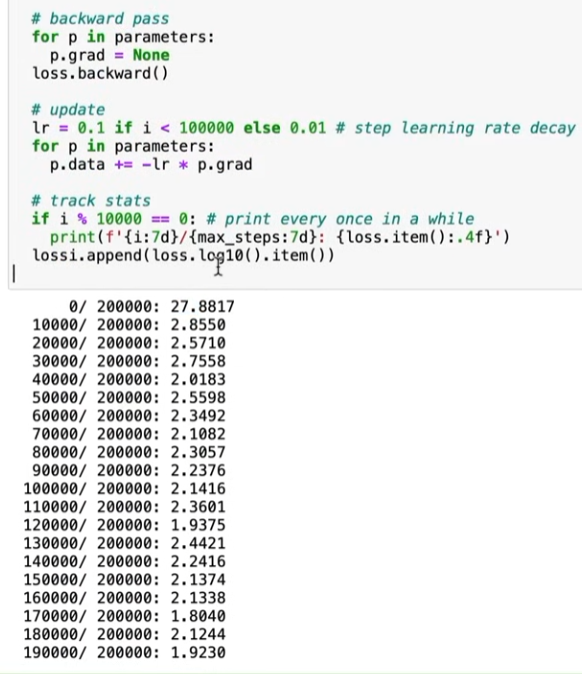
loss가 학습하며 정상적으로 줄어들고는 있으나, 맨 처음 loss를 보면 27 근처로 굉장히 높은 수치이다.
우리가 사용한 손실함수는 loss = F.cross_entropy(logits, Yb) 이다. batch 크기를 $B$, 정답 character를 $y_i$라 하면
즉 logits를 softmax로 확률분포로 바꾼 뒤, 정답 character에 할당된 확률에 $-\log$를 취해 평균낸 값이다.
학습 초기의 상태에는, 어떤 input이 들어오든 모든 character에 대해 동등한 확률을 가지는 것이 자연스럽다. 총 27개의 character가 있으니 초기에는 어떤 character든 1/27 확률로 예측하는 상태여야 한다는 것이다.
이 경우의 loss는
\[-\log\frac{1}{27} = \log 27 \approx 3.2958\]이 되어야 한다. 하지만 실제 초기 loss는 27 근처이고, 이는 모델이 시작부터 엉뚱한 character에 강한 확신(fake confidence)을 가지고 있다는 뜻이다.
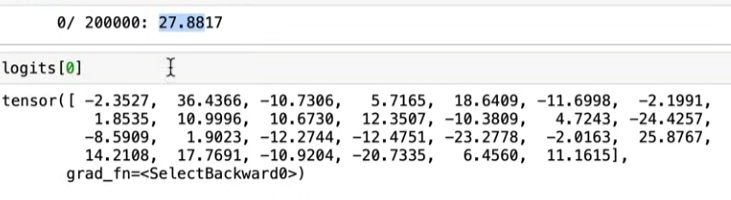
softmax는 입력 전체에 상수를 더해도 결과가 변하지 않으므로, uniform distribution을 만들려면 logits의 각 행이 “전부 0”일 필요는 없고 “전부 같은 값”이기만 하면 된다. 하지만 랜덤 초기화로 값들이 정확히 같아지도록 만들 수는 없으므로, 대신 logits 전체를 0에 가깝게 눌러서 값들 간의 차이를 작게 만드는 방식을 택한다.
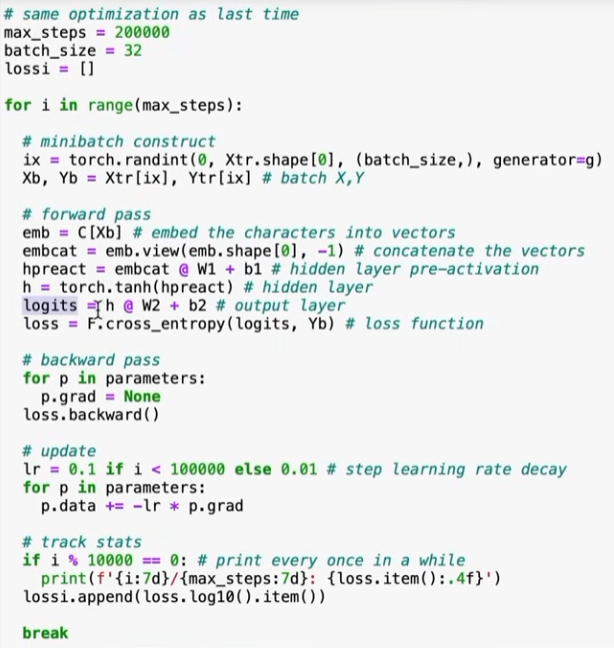
logits = h @ W2 + b2 이다. 0에 가까운 값으로 초기화를 해야하므로 randn으로 초기화된 bias(b2)를 0으로 초기화하고, W2 또한 scaling을 통해 작은 값으로 만들어 해결할 수 있다.
W2 = torch.randn((n_hidden, vocab_size),  generator=g) * 0.01
b2 = torch.randn(vocab_size,              generator=g) * 0
여기서 W2를 정확히 0으로 만들지 않고 0.01을 곱해 아주 작은 값만 남겨두는데, 완전한 대칭 상태를 만들지 않기 위해 약간의 entropy를 남겨두는 것이다.
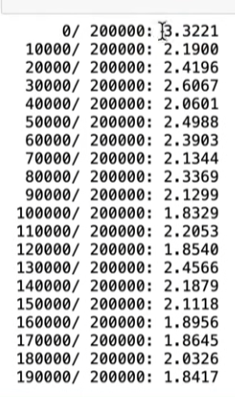
그 결과 초기 loss가 3.3221로 떨어졌으며, 최종 train/val loss도 함께 떨어졌다. 즉 초기의 부자연스러운 값을 되돌리는 데 학습 cycle이 낭비되지 않고, 처음부터 실제 문제를 optimize하는 데 학습 cycle이 사용된 것이다.
hidden state
logits의 초기값은 안정화가 되었는데, logits를 구성하는 h에 대해서도 살펴볼 필요가 있다. 현재 초기 h의 분포를 확인하면 아래와 같다.
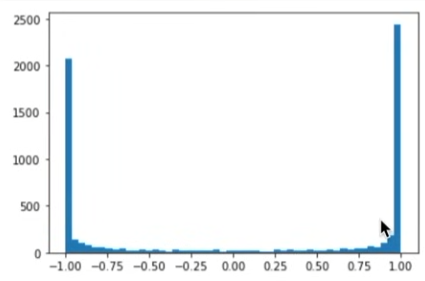
대부분의 값이 -1 또는 1에 분포해있다. 현재 forward pass코드를 보면
# forward pass
  emb = C[Xb] # embed the characters into vectors
  embcat = emb.view(emb.shape[0], -1) # concatenate the vectors
  hpreact = embcat @ W1 + b1 # hidden layer pre-activation
  h = torch.tanh(hpreact) # hidden layer
  logits = h @ W2 + b2 # output layer
  loss = F.cross_entropy(logits, Yb) # loss function
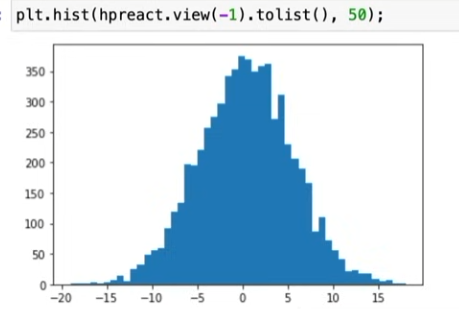
h는 tanh의 출력 결과인데, -1과 1에 몰려있다는 것은 입력인 hpreact가 과하게 양쪽 끝으로 퍼져 있어 tanh가 saturation 되었다는 뜻이다. hpreact의 분포를 확인해보면 대략 -15 ~ 15 범위에 퍼져 있는 것을 확인할 수 있다.
이것이 학습에 문제가 되는 이유는 backward pass에 있다. tanh의 국소 미분은
\[\frac{\partial}{\partial x}\tanh(x) = 1 - \tanh(x)^2\]이므로, 출력값 $t = \tanh(x)$가 $\pm 1$에 가까울수록 $1 - t^2$가 0에 가까워진다.
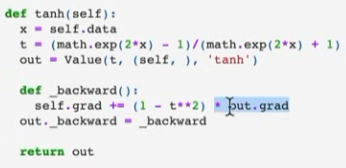
위의 코드처럼 tanh의 값이 1이나 -1에 가까울수록 out.grad의 값과 상관없이 gradient를 0에 가깝게 만들어버린다. 즉 tanh가 gradient를 죽여버려서, 그 앞단에 연결된 W1, b1, C 등의 파라미터들이 제대로 된 역전파를 받지 못한다.
더 나아가, 특정 뉴런이 모든 batch 샘플에 대해 saturation 상태라면 그 뉴런은 어떤 입력에도 gradient를 흘려보내지 못하는 dead neuron이 된다. 이 경우 해당 뉴런은 학습 내내 갱신되지 않는다.
이를 해결하기 위해 hpreact 또한 0 주변의 값으로 초기화되도록 해야 한다. 이를 위해 이전과 같이 W1, b1을 scaling하여 완화할 수 있다.
W1 = torch.randn((n_embd * block_size, n_hidden), generator=g) * 0.2
b1 = torch.randn(n_hidden,                        generator=g) * 0.01
다만 이 0.2라는 값은 분포를 눈으로 확인하며 찾은 임의의 수치이다. 이 scaling 값을 정하는데 비교적 공식화된 방법이 존재한다.
Kaiming He Initialization
아래의 코드처럼, 정규분포 $N(0,1)$을 따르는 x와 w가 있을 때, y = x @ w 라면 y에서 평균은 0 근처로 유지가 되지만, 표준편차가 커진다.
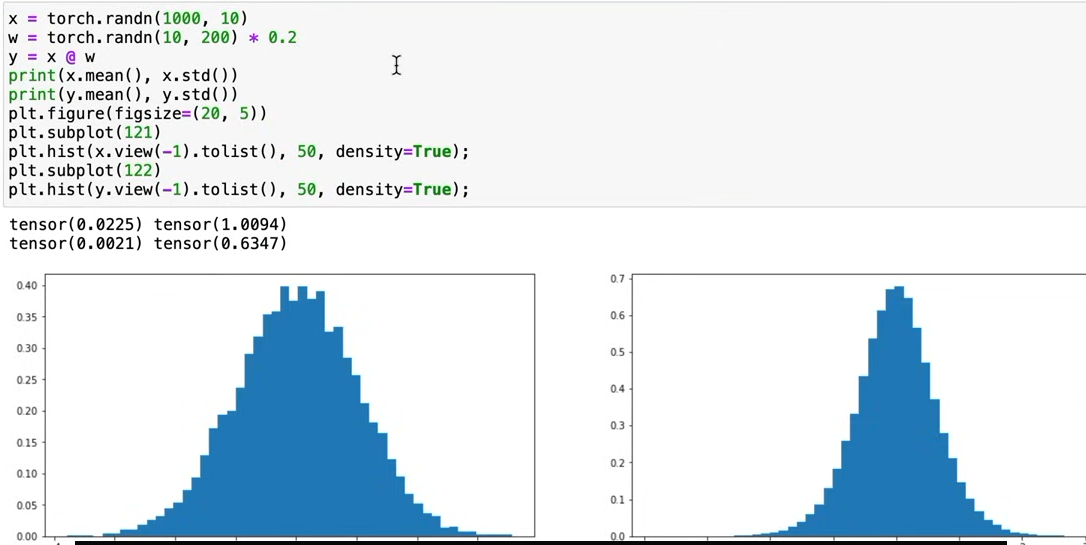
이는 matmul이 fan_in개의 항을 더하는 연산이기 때문이다. 출력의 한 원소는
\[y_j = \sum_{i=1}^{n_{in}} x_i w_{ij}\]이다. 일반적으로 합의 분산은 각 항의 분산에 공분산 항이 더해지지만, 가중치 $w_{ij}$들이 서로 독립이고 평균이 0이므로 서로 다른 항 사이의 공분산이 0이 되어 분산이 단순히 더해진다.
\[\mathrm{Cov}(x_i w_{ij},\, x_k w_{kj}) = \mathbb{E}[x_i x_k]\cdot\mathbb{E}[w_{ij}w_{kj}] = 0 \quad (i \neq k)\]각 항의 분산은 $x$와 $w$가 독립이므로 $\mathbb{E}[x^2]\,\mathbb{E}[w^2]$이고, 둘 다 평균이 0이면 이는 $\mathrm{Var}(x)\mathrm{Var}(w)$와 같다. 따라서
\[\mathrm{Var}(y_j) = n_{in}\cdot \mathrm{Var}(x)\cdot \mathrm{Var}(w)\]가 된다. 즉 표준편차는 $\sqrt{n_{in}}$배만큼 커진다.
w에 scaling을 적용할 때, 1보다 큰 값을 곱하면 표준편차가 더 커지고, 1보다 작은 값을 곱하면 줄어든다. 표준편차를 1 근처로 유지하려면 커진 만큼을 그대로 되돌리면 되므로, 곱해야 할 값은
\[\frac{1}{\sqrt{n_{in}}}\]이다. 여기서 fan_in이란 w의 input 차원, 즉 하나의 출력 뉴런이 받아들이는 입력의 개수를 말한다.
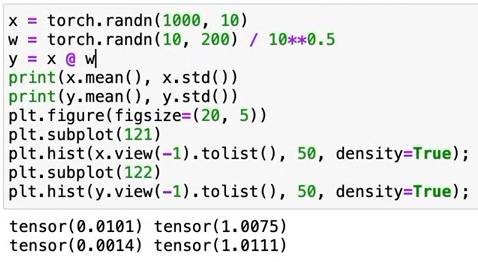
지금 예제는 bias도 없고 비선형층도 없는 단순한 linear layer여서 간단히 해결했으나, 실제 network는 더 복잡한 구조를 가지고 있을 것이고, 이러한 경우에도 결과값의 분포가 잘 유지되도록 W를 초기화해야 한다.
특히 비선형 함수가 들어오면, 예를 들어 tanh는 입력을 (-1, 1) 범위로 압축하는 함수이므로, 층을 통과할 때마다 분포가 조금씩 줄어든다. 앞서 구한 $1/\sqrt{n_{in}}$만 적용하면 층이 깊어질수록 activation이 0으로 수축해 사라지게 된다. 따라서 이 압축량을 상쇄해줄 보정 계수가 추가로 필요하고, 이를 gain이라 부른다.
이를 정리한 것이 Kaiming He Initialization이다. 원 논문은 ReLU 계열을 다룬 Delving Deep into Rectifiers (He et al., 2015)이며, 가중치의 표준편차를 다음과 같이 정한다.
\[\text{std} = \frac{\text{gain}}{\sqrt{n_{in}}}\]PyTorch에서는 torch.nn.init.kaiming_normal_로 제공되고, gain 값은 torch.nn.init.calculate_gain(nonlinearity)로 확인할 수 있다.
| nonlinearity | gain |
|---|---|
| Linear / Identity, Conv{1,2,3}D | $1$ |
| Sigmoid | $1$ |
| Tanh | $5/3 \approx 1.667$ |
| ReLU | $\sqrt{2} \approx 1.414$ |
| Leaky ReLU | $\sqrt{2 / (1 + \text{negative_slope}^2)}$ |
| SELU | $3/4$ |
압축이 강한 함수일수록 gain이 커지는 것을 볼 수 있다. ReLU는 입력의 음수 절반을 통째로 0으로 만들어 분산을 대략 절반으로 줄이므로, 이를 되돌리기 위해 $\sqrt{2}$를 곱한다. tanh 역시 squashing 함수이므로 1보다 큰 $5/3$이 필요하고, 반대로 Linear는 아무것도 압축하지 않으므로 gain이 1이다.
kaiming_normal_에는mode인자로fan_in과fan_out을 선택할 수 있다.fan_in은 forward pass에서 activation의 분산을 보존하고,fan_out은 backward pass에서 gradient의 분산을 보존한다. 논문에서는 둘 중 어느 쪽을 써도 무방하다고 언급하며, PyTorch의 기본값은fan_in이다.
우리의 코드에서는 tanh가 사용되었으므로 다음과 같이 scaling을 적용할 수 있다. fan_in은 embcat의 차원인 n_embd * block_size = 30이다.
W1 = torch.randn((n_embd * block_size, n_hidden), generator=g) * (5/3)/((n_embd * block_size)**0.5)
b1 = torch.randn(n_hidden,                        generator=g) * 0.01
앞서 실험적으로 찾았던 0.2 대신, 이제는 $\frac{5/3}{\sqrt{30}} \approx 0.304$라는 값을 원리에 근거해 얻게 되었다.
기존에는 이러한 initialization 과정이 매우 중요했으나, 오늘날에는 residual connection, normalization layer, 그리고 RMSProp/Adam과 같은 현대적인 optimizer 덕분에 안정성이 많이 확보되어 initialization에 매우 정확한 값을 요구하지는 않는 편이다.
3. BatchNorm
앞서 hpreact의 분포가 적당한 범위에 놓이도록 초기화 시점에 W를 scaling했다. 하지만 이는 어디까지나 간접적인 방법이고, 층이 깊어질수록 이런 계산을 매번 하는 것은 까다롭다.
hpreact가 적절한 분포를 갖기를 원한다면, 초기화를 통해 우회하지 말고 그냥 직접 정규화해버리는 것이 BatchNorm의 시작점이다.
원리
수식은 다음과 같다. 각 미니배치마다 hpreact의 평균과 분산을 구해 이를 바탕으로 정규화한 뒤, scale and shift 과정을 거치는 것이다.
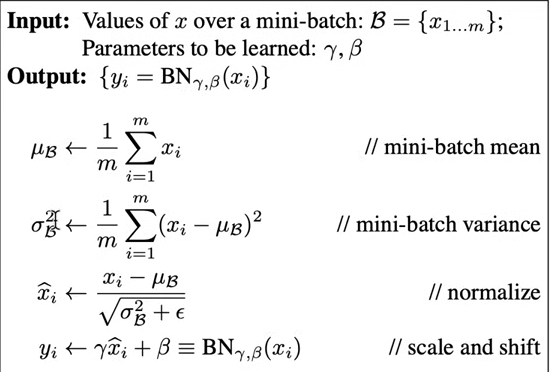
normalize의 epsilon은 분산이 0이 되어 0으로 나누는 경우를 방지하기 위해 추가된 아주 작은 값(PyTorch 기본값
1e-5)이다.
평균과 분산을 batch 차원(dim=0)에 대해 구한다. 200개의 hidden 뉴런 각각에 대해, batch 안의 32개 샘플이 만든 값들의 통계를 계산하여, 결과적으로 평균과 분산은 [1, n_hidden] shape이 된다.
코드로 보면 다음과 같다.
bngain = torch.ones((1, n_hidden))
bnbias = torch.zeros((1, n_hidden))
parameters = [C, W1, W2, b2, bngain, bnbias]
hpreact = bngain * (hpreact - hpreact.mean(0, keepdim=True)) / hpreact.std(0, keepdim=True) + bnbias
정규화만 하면 hpreact는 항상 평균 0, 표준편차 1로 고정되어 버린다. 이는 초기에는 바람직하지만, 학습이 진행되면서 tanh를 saturate시키는 편이 좋다고 판단하더라도 그럴 자유가 없어진다. 그래서 학습 가능한 파라미터 $\gamma$(bngain), $\beta$(bnbias)를 두어 분포를 다시 조정할 수 있게 한다. 학습 초기에는 gain = 1, bias = 0인 상태에서 출발하고, 이후 backprop을 통해 적절한 값으로 조정된다.
이러한 normalization은 보통 linear 혹은 convolution 연산 직후, 비선형성이 추가되는 activation layer 이전에 적용하여 activation의 입력값이 안정되도록 한다. (resnet구조 참고)
문제점
배치 내 샘플들이 서로 얽힌다. 원래 신경망은 하나의 입력에 대해 하나의 출력을 내는 함수여야 하는데, BatchNorm을 넣는 순간 어떤 샘플의 hidden activation이 같은 배치에 우연히 함께 뽑힌 다른 샘플들에 의해 달라진다. 동일한 입력이라도 어떤 batch에 속하느냐에 따라 결과가 바뀌는 상태가 되는 것이다.
그런데 이 버그처럼 보이는 성질이 실제로는 도움이 될 수도 있다. 매 batch마다 평균/분산이 조금씩 다르므로 activation에 일종의 noise가 주입되고, 이것이 data augmentation과 유사한 regularization 효과를 내어 overfitting을 억제한다고 한다.
이 애매한 특징으로 인해 LayerNorm, GroupNorm, InstanceNorm 등이 등장했다.
추론 단계
학습 시에는 batch 통계를 쓰면 되지만, 실제 서비스에서는 샘플 하나만 들어오는 경우가 대부분이다. 샘플이 하나뿐이면 평균과 분산을 구할 수 없다. 따라서 학습이 끝난 뒤 사용할 고정된 평균/표준편차가 필요하다.
가장 단순한 방법은 학습이 끝난 후 전체 training set을 한 번 통과시켜 통계를 계산해두는 것이다.
with torch.no_grad():
  emb = C[Xtr]
  embcat = emb.view(emb.shape[0], -1)
  hpreact = embcat @ W1
  bnmean = hpreact.mean(0, keepdim=True)
  bnstd = hpreact.std(0, keepdim=True)
하지만 학습 후 별도의 단계를 두는 것은 번거롭다. 그래서 실제 구현에서는 학습 도중에 exponential moving average(EMA)로 통계를 함께 추정해 둔다.
bnmean_running = torch.zeros((1, n_hidden))
bnstd_running = torch.ones((1, n_hidden))

# 학습 루프 안에서
bnmeani = hpreact.mean(0, keepdim=True)
bnstdi = hpreact.std(0, keepdim=True)
hpreact = bngain * (hpreact - bnmeani) / bnstdi + bnbias
with torch.no_grad():
  bnmean_running = 0.999 * bnmean_running + 0.001 * bnmeani
  bnstd_running = 0.999 * bnstd_running + 0.001 * bnstdi
bnmeani, bnstdi는 이전과 동일하게 배치 내에서의 mean과 std역할을 하고, running값에 매번 일정 비율로 현재 mean과 std값을 누적시킨다.
즉 running 값들은 gradient descent로 학습되는 파라미터가 아니라 따로 갱신하는 값이다. 계산 후 실제 값과 비교해보면 running 추정치가 거의 일치하는 것을 확인할 수 있다.
momentum(위 코드의 0.001, PyTorch 기본값은 0.1)은 batch 크기와 함께 고려해야 한다. batch가 작아 배치별 통계가 요동칠수록 momentum을 작게 두어야 안정된다.
PyTorch BatchNorm의 momentum은 새 관측값 쪽 계수이다: running = (1 - momentum) * running + momentum * new
앞 레이어의 bias가 무의미해진다
hpreact = embcat @ W1 + b1에서 b1은 모든 샘플에 동일한 상수를 더한다. 그런데 BatchNorm은 곧바로 배치 평균을 빼버리므로, 그 상수는 평균에도 똑같이 반영되어 상쇄된다. b1은 결과에 아무 영향을 주지 못하면서 gradient만 낭비하게 된다.
실질적인 bias 역할은 bnbias($\beta$)가 대신하므로, BatchNorm 앞의 linear layer에서는 bias를 아예 제거하는 것이 맞다. (PyTorch에서도 BatchNorm 앞의 nn.Linear나 nn.Conv2d에는 관례적으로 bias=False를 준다.)
hpreact = embcat @ W1 # b1 제거
4. Diagnostics
gain값에 따른 network의 activation/grdient의 변화
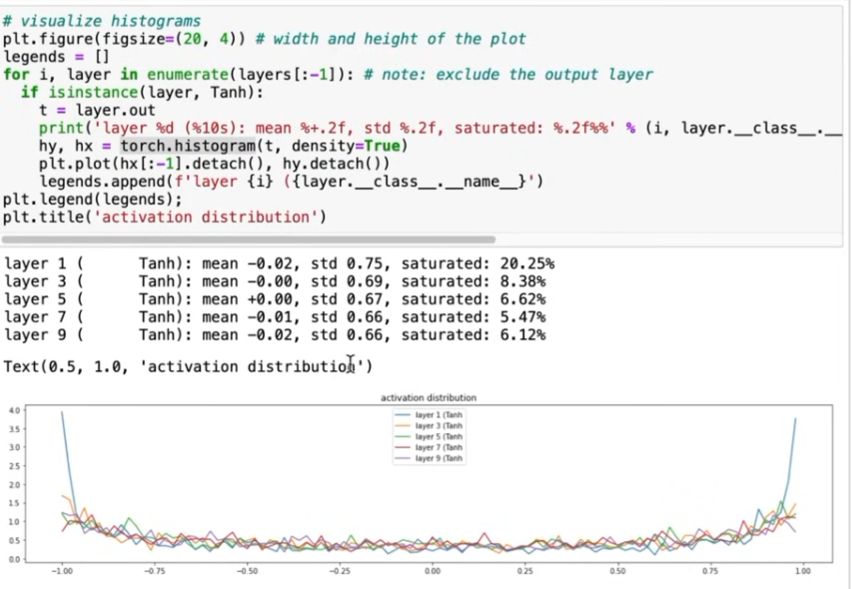
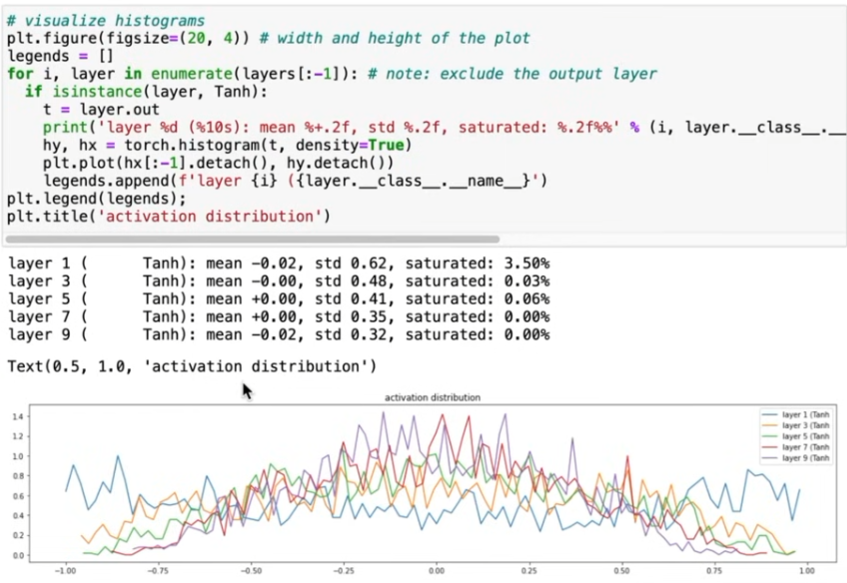
linear - tanh의 반복이 5번 쌓인 네트워크에서, 적절한 gain(5/3)을 유지하니 activation의 분포가 안정되고, 1을 사용하였더니 점점 std가 줄어든다. 이는 gradient에서도 마찬가지이다.
data ratio
지금까지는 activation과 gradient의 분포를 봤는데, 학습이 적절한 속도로 진행되고 있는지는 이것만으로 알기 어렵다. gradient의 절대적인 크기는 그 자체로 의미가 없기 때문이다. 파라미터 값이 크다면 큰 gradient도 상대적으로는 미미한 변화이고, 반대로 파라미터가 작다면 작은 gradient도 큰 변화를 일으킬 수 있다.
따라서 봐야 할 것은 한 스텝의 업데이트량이 파라미터 자체의 크기 대비 얼마나 되는가이다.
\[\text{ratio} = \frac{\text{std}(\text{lr} \cdot \nabla_p)}{\text{std}(p)}\]분자는 이번 스텝에서 실제로 파라미터가 변화하는 양이고, 분모는 파라미터 자체의 스케일이다. 텐서 전체의 대표적인 크기를 재기 위해 std를 사용한다.
학습 루프에서 다음과 같이 기록해둔다.
ud = []

# 학습 루프 안, update 직후
with torch.no_grad():
  ud.append([((lr*p.grad).std() / p.data.std()).log10().item() for p in parameters])
log10을 취하는 이유는 값의 범위가 매우 넓기 때문이다. 이렇게 하면 비율 $10^{-3}$이 $-3$으로 표현된다.
plt.figure(figsize=(20, 4))
legends = []
for i, p in enumerate(parameters):
  if p.ndim == 2:
    plt.plot([ud[j][i] for j in range(len(ud))])
    legends.append('param %d' % i)
plt.plot([0, len(ud)], [-3, -3], 'k') # 기준선
plt.legend(legends);
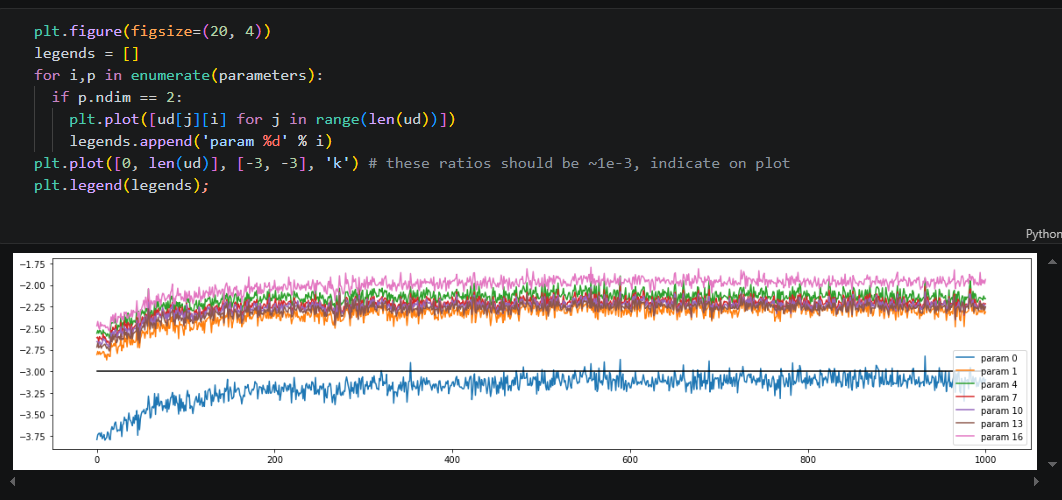
여기서 p.ndim == 2 조건으로 weight matrix만 그리는데, bias나 bngain 같은 1차원 파라미터는 개수가 많아 그래프가 지저분해지기 때문이다.
경험적으로 이 비율은 $10^{-3}$, 즉 로그 스케일에서 $-3$ 근처가 적절하다고 알려져 있다. 한 스텝마다 파라미터가 자기 크기의 약 0.1%씩 변한다는 뜻이다.
- $-3$보다 한참 위 ($-2$, $-1$ 등): 한 번의 업데이트가 파라미터를 너무 크게 변화시킴. learning rate를 낮춰야 한다.
- $-3$보다 한참 아래 ($-4$, $-5$ 등): 파라미터가 사실상 거의 갱신되지 않고 있다. 이 파라미터는 학습되고 있지 않은 것에 가까우므로 learning rate를 높여야 한다.
학습 초반 스텝은 값이 크게 요동치므로, 안정화된 구간을 기준으로 판단해야 한다.
BatchNorm을 되살리면
앞선 코드에 BatchNorm을 다시 되살린다. 각 Linear 뒤에 BatchNorm1d를 붙인다.
layers = [
  Linear(n_embd * block_size, n_hidden, bias=False), BatchNorm1d(n_hidden), Tanh(),
  Linear(           n_hidden, n_hidden, bias=False), BatchNorm1d(n_hidden), Tanh(),
  Linear(           n_hidden, n_hidden, bias=False), BatchNorm1d(n_hidden), Tanh(),
  Linear(           n_hidden, n_hidden, bias=False), BatchNorm1d(n_hidden), Tanh(),
  Linear(           n_hidden, n_hidden, bias=False), BatchNorm1d(n_hidden), Tanh(),
  Linear(           n_hidden, vocab_size, bias=False), BatchNorm1d(vocab_size),
]

with torch.no_grad():
  # last layer: make less confident
  layers[-1].gamma *= 0.1
  # all other layers: apply gain
  for layer in layers[:-1]:
    if isinstance(layer, Linear):
      layer.weight *= 1.0   # 5/3이 아니라 1.0
- gain이
5/3에서1.0으로 바뀌었다. 즉 Kaiming의 tanh gain을 적용하지 않았다. - 마지막 layer를 눌러 초기 confidence를 낮추는 작업이
weight *= 0.1에서gamma *= 0.1로 바뀌었다. BatchNorm이 앞선 Linear의 weight 스케일을 무시하므로, 출력 스케일을 조절하려면 BatchNorm의 gain을 건드려야 한다. - 모든 Linear가
bias=False가 되었다. 앞서 본 대로 BatchNorm 뒤에서는 bias가 상쇄되기 때문이다.
이 상태로 activation 통계를 찍어보면 다음과 같다.
layer 2  (Tanh): mean -0.00, std 0.63, saturated: 2.78%
layer 5  (Tanh): mean +0.00, std 0.64, saturated: 2.56%
layer 8  (Tanh): mean -0.00, std 0.65, saturated: 2.25%
layer 11 (Tanh): mean +0.00, std 0.65, saturated: 1.69%
layer 14 (Tanh): mean +0.00, std 0.65, saturated: 1.88%
gain을 적용하지 않았음에도 층이 깊어져도 std가 0.63~0.65로 유지되고, saturation도 2% 안팎에서 안정적이다. BatchNorm 없이 gain=1.0으로 두었을 때 층마다 activation이 수축해가던 것과 대조적이다.
이는 우연이 아니라 수학적으로 보장되는 성질이다. Linear의 가중치 $W$를 임의의 상수 $a$배 했다고 하자. 그러면 pre-activation도 $a$배가 된다.
\[\text{hpreact} \rightarrow a \cdot \text{hpreact}\]그런데 BatchNorm은 이 값의 배치 평균과 표준편차를 구해 나눈다. 평균도 $a\mu$, 표준편차도 $a\sigma$가 되므로
\[\frac{a x - a\mu}{a\sigma} = \frac{x - \mu}{\sigma}\]로 $a$가 정확히 소거된다. 즉 BatchNorm 앞에 있는 Linear layer의 weight 스케일은 forward pass 결과에 아무런 영향을 주지 못한다. 앞서 계산했던 gain과 $1/\sqrt{n_{in}}$은, BatchNorm이 붙는 순간 출력 분포에 관해서는 무의미해지는 것이다.
이것이 BatchNorm이 널리 쓰이게 된 가장 큰 실용적 이유다. 층이 수십, 수백 개로 깊어지면 각 층의 분포를 초기화만으로 맞추는 것은 사실상 불가능한데, BatchNorm은 그 부담을 통째로 없애준다. 초기화가 다소 어긋나 있어도 네트워크는 여전히 학습된다.
그래도 완전히 무관한 것은 아니다 (보충 설명)
영상 내용 외에 추가로 정리.
BatchNorm을 하나의 함수 $f$로 보먄, 앞서 확인한 스케일 불변성은 다음과 같이 쓸 수 있다.
\[f(az) = f(z) \qquad (a > 0)\]양변을 $z$로 미분한다. 좌변은 연쇄법칙에 의해 안쪽 미분 $a$가 곱해지므로
\[a \cdot f'(az) = f'(z) \quad\Longrightarrow\quad f'(az) = \frac{1}{a} f'(z)\]forward는 그대로인데 미분값은 $1/a$배로 줄어든다.
서로 다른 두 개의 신경망이 있다고 하자.
- 네트워크 A: 가중치가 $W$
- 네트워크 B: 가중치가 $W’ = aW$ ($W$의 모든 원소에 똑같은 숫자 $a$를 곱한 것 (예: $a=2$면 전부 2배))
두 네트워크는 가중치 숫자가 다르다. 그런데도 BatchNorm을 통과하면 출력이 같다는 것이 앞서 확인한 내용이었다.
그러면 “출력이 같으니 학습도 똑같이 되는가?” 답은 “아니다”.
역전파의 출발점은 같다
역전파는 출력 쪽에서 시작해 입력 쪽으로 거슬러 올라간다.
... → z = Wx → BatchNorm → y → 손실 L
                            ↑
                     여기서 역전파 시작
$L$은 $y$와 정답만으로 계산된다. 그런데 A와 B는 $y$가 완전히 똑같으므로
- 손실 $L$도 똑같다
- 그 손실을 $y$로 미분한 값 $\partial L / \partial y$도 똑같다
$\partial L/\partial y$는 “출력을 어느 방향으로 얼마나 밀어야 손실이 줄어드는가”를 나타내는 신호다. 두 네트워크가 완전히 같은 출력을 냈으니, 받는 신호도 똑같다.
차이는 이 신호가 BatchNorm을 거슬러 통과하는 순간부터 생긴다.
BatchNorm을 통과하면 $1/a$배가 된다
이제 그 신호를 $y$에서 $z$로 옮겨야 한다. 연쇄법칙에 따라
\[\underbrace{\frac{\partial L}{\partial z}}_{\text{구하려는 것}} = \underbrace{\frac{\partial L}{\partial y}}_{\text{A, B 동일}} \times \underbrace{\frac{\partial y}{\partial z}}_{\text{여기서 차이}}\]앞항은 방금 봤듯이 같다. 그러니 $\partial y / \partial z$, 즉 BatchNorm 자체의 미분값만 비교하면 된다.
$\partial y/\partial z$가 뜻하는 것은 “BatchNorm에 들어간 값을 변화시키면 출력이 얼마나 변하는가”이다.
| A | B ($a=2$) | |
|---|---|---|
| $z$의 표준편차 | 1 | 2 |
| BN이 나누는 값 | 1 | 2 |
| $z$가 $0.1$ 변화 | 출력이 $0.1/1 = 0.1$ 변함 | 출력이 $0.1/2 = 0.05$ 변함 |
B는 z를 같은 크기를 변화시켜도 출력이 절반밖에 안 움직인다. BatchNorm이 나누는 표준편차가 2배로 커졌기 때문이다.
“입력 변화에 덜 반응한다”가 곧 “미분값이 작다”이다. 그래서 $\partial y/\partial z$가 $1/a$배가 되고, 결과적으로
\[\frac{\partial L}{\partial z'} = \frac{1}{a}\cdot\frac{\partial L}{\partial z}\]가 된다.
$W$를 크게 잡을수록 뒤에서 오는 학습 신호가 앞으로 전달될 때 더 많이 감쇄된다.
$z = Wx$이므로 $W$에 대한 gradient는
\[\frac{\partial L}{\partial W} = x^\top \frac{\partial L}{\partial z}\]인데, 여기서 $x$는 A와 B가 완전히 같은 입력을 쓴다. 그러니 앞에서 $1/a$배가 된 것이 그대로 유지된다.
\[\frac{\partial L}{\partial W'} = \frac{1}{a}\cdot\frac{\partial L}{\partial W}\]가중치는 $a$배 크고, gradient는 $1/a$배 작다. 이 둘이 합쳐져 결국 학습이 $1/a^2$만큼 느려진다.
실효 learning rate는 $1/a^2$배가 된다
앞 절의 data ratio를 다시 가져오자.
\[\text{ratio} = \frac{\|\,\text{lr}\cdot \nabla_W\,\|}{\|W\|}\]$W$를 $a$배 했을 때 분자와 분모가 각각 어떻게 변하는지 보면:
| 스케일 | 변화 | |
|---|---|---|
| 분모 (파라미터 크기) | $|aW| = a|W|$ | $a$배 증가 |
| 분자 (업데이트 크기) | $\text{lr}\cdot\frac{1}{a}|\nabla_W|$ | $1/a$배 감소 |
두 효과가 같은 방향으로 겹치기 때문에 $1/a$가 아니라 $1/a^2$이다. 초기화 스케일을 2배로 잡으면 그 layer는 실효적으로 learning rate가 1/4로 줄어든 채 학습되는 셈이고, 4배로 잡으면 1/16이 된다. forward 출력은 완전히 동일한데도 말이다.
직접 확인해보기
import torch

torch.manual_seed(0)
x = torch.randn(32, 30)
W = torch.randn(30, 100) / 30**0.5
target = torch.randn(32, 100)
bn = torch.nn.BatchNorm1d(100, affine=False)

def run(scale):
    Wa = (scale * W).clone().requires_grad_(True)
    y = bn(x @ Wa)
    loss = 0.5 * ((y - target)**2).sum()
    loss.backward()
    return y.detach(), Wa.grad.norm().item(), Wa.detach().norm().item()

y0, g0, w0 = run(1.0)
for a in [0.25, 4.0, 16.0]:
    y, g, w = run(a)
    print(f"a={a:5.2f}  forward 최대오차={(y-y0).abs().max():.2e}"
          f"  |grad|비={g/g0:8.4f} (1/a={1/a:.4f})"
          f"  ratio비={(g/w)/(g0/w0):9.5f} (1/a²={1/a**2:.5f})")
a= 0.25  forward 최대오차=5.6e-04  |grad|비=  3.9996 (1/a=4.0000)  ratio비= 15.99830 (1/a²=16.00000)
a= 4.00  forward 최대오차=3.5e-05  |grad|비=  0.2500 (1/a=0.2500)  ratio비=  0.06250 (1/a²=0.06250)
a=16.00  forward 최대오차=3.7e-05  |grad|비=  0.0625 (1/a=0.0625)  ratio비=  0.00391 (1/a²=0.00391)
forward 출력은 (오차 $10^{-4}$ 이하로) 완전히 동일한데, gradient 크기는 정확히 $1/a$, update:data ratio는 정확히 $1/a^2$로 변한다.
forward 오차가 정확히 0이 아닌 것은 분모의 $\epsilon$ 때문이다. $\sqrt{a^2\sigma^2 + \epsilon}$는 $a\sqrt{\sigma^2+\epsilon}$와 완전히 같지 않아서, $\epsilon$이 스케일 불변성을 아주 미세하게 깨뜨린다.
정리
- BatchNorm은 forward 출력에 대해서만 초기화 스케일을 완전히 지워준다.
- 스케일에 따라 학습 속도에 대해서는 실효 learning rate를 $1/a^2$ 비율로 변함.
- BatchNorm은 W의 안정화된 분포를 만들어주지만, 각 layer가 올바른 속도로 학습되는지는 data ratio로 확인해야 한다.