 hemisus

참고한/사용된 자료
Krish Naik의 ‘Complete Data Science,Machine Learning,DL,NLP Bootcamp’ 강의 내용을 참고하여 작성한 글입니다.
1. AdaBoost 소개
AdaBoost(Adaptive Boosting)는 Ensemble 기법 중 Boosting 계열에 속하는 알고리즘이다. 성능이 약한 여러 개의 Weak Learner를 순차적으로 학습시켜, 이들을 결합해 하나의 Strong Learner를 만들어내는 것이 핵심 아이디어다.
Random Forest와 같은 Bagging 계열 알고리즘이 여러 모델을 독립적으로 학습시킨 뒤 다수결(또는 평균)로 결과를 결정하는 것과 달리, AdaBoost는 Weak Learner를 순차적으로 학습시키면서 이전 모델이 잘못 예측한 데이터에 가중치를 부여해 다음 모델이 이를 보완하도록 만든다. 즉, 각 모델이 독립적이지 않고 이전 모델의 결과에 종속적으로 학습된다는 점이 가장 큰 차이다.
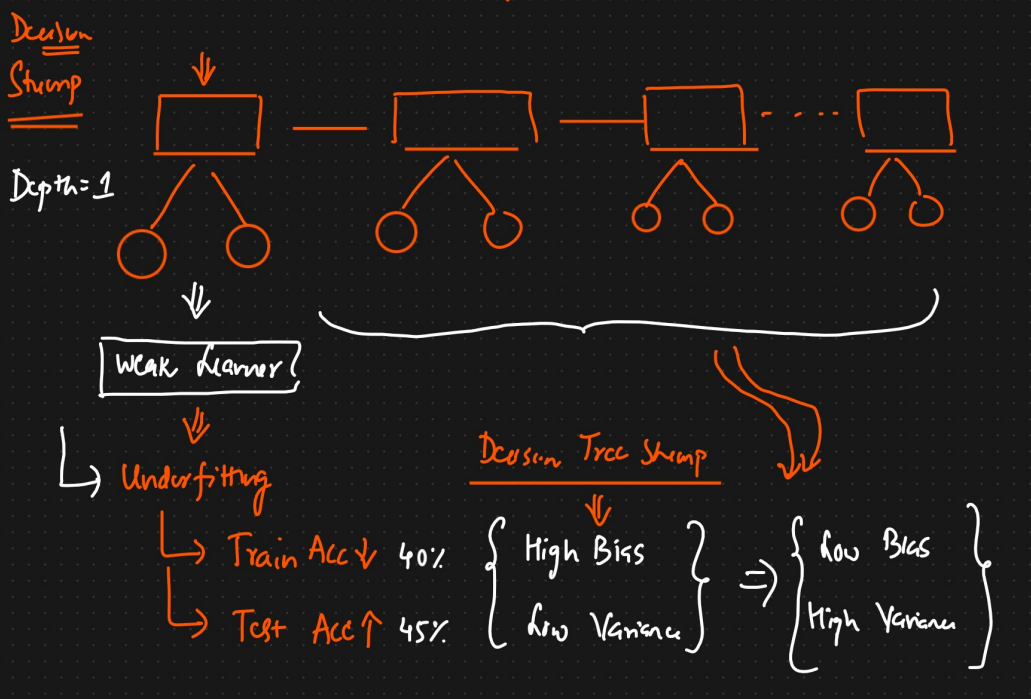
Bias-Variance 관점에서 보는 AdaBoost
“High Bias, Low Variance 상태에서 Low Bias, High Variance 상태로 이동한다”는 분산이 커지는게 언뜻 성능 저하처럼 보일 수 있지만, 실제로는 그렇지 않다.
모델의 일반화 오차는 대략 다음과 같이 분해할 수 있다.
\[전체 오차 ≈ Bias² + Variance + 줄일 수 없는 노이즈\]우리가 궁극적으로 줄여야 하는 것은 분산 그 자체가 아니라 이 오차의 합이라는 점이 핵심이다.
- Weak Learner 1개: 단순한 모델은 데이터를 충분히 학습하지 못해 Bias가 크다. 대신 모델 구조가 단순해서 학습 데이터가 조금 바뀌어도 예측이 크게 흔들리지 않으므로 Variance는 작다.
- AdaBoost의 결합 과정: Weak Learner를 순차적으로 이어 붙여 이전 모델이 틀린 부분에 가중치를 부여해 학습하기 때문에, 모델 전체의 표현력(capacity)이 커지고 Bias가 줄어든다. 다만 표현력이 커진 만큼 학습 데이터의 패턴에 더 민감해지므로 Variance는 다소 증가한다.
표현력(capacity)이란?
모델이 표현할 수 있는 함수/결정 경계(decision boundary)가 얼마나 복잡한가를 뜻한다. Weak Learner 1개는 단순한 경계만 그릴 수 있다면, 이런 Weak Learner를 여러 개 결합하면 각 경계들이 겹쳐지면서 훨씬 복잡한 결정 경계를 만들 수 있게 된다. 즉 Weak Learner를 더할수록 앙상블 전체의 표현력이 커지는 것이다.
이때 Bias가 줄어드는 폭이 Variance가 늘어나는 폭보다 훨씬 크기 때문에, 전체 오차는 오히려 감소하고 앙상블의 예측 성능은 개별 Weak Learner보다 좋아진다. 따라서 “Low Bias, High Variance”라는 표현은 Weak Learner 하나와 비교했을 때 상대적으로 그렇다는 의미이지, Variance가 안좋은 수준까지 높아진다는 뜻은 아니다.
물론 Weak Learner 개수를 무한정 늘린다고 성능이 계속 좋아지는 것은 아니다. 어느 시점부터는 Bias는 거의 줄어들지 않고 Variance만 커지는 구간이 나타나는데, 이것이 바로 과적합(Overfitting)으로 이어진다. 그래서 실전에서는 반복 횟수를 적절히 제한하거나, Learning Rate를 통해 각 Weak Learner의 기여도를 낮추는 방식으로 Variance 증가를 통제한다.
Random Forest와의 비교
| 구분 | Random Forest (Bagging) | AdaBoost (Boosting) |
|---|---|---|
| 학습 방식 | 독립적 · 병렬 학습 | 순차적 학습 |
| 결과 결합 방식 | 다수결 / 평균 | 가중 합 |
| 개별 모델 특성 | Low Bias, High Variance (깊은 트리) | High Bias, Low Variance (Weak Learner) |
| 앙상블의 목적 | Variance 감소 | Bias 감소 |
두 알고리즘 모두 “적당한 Bias + 적당한 Variance”를 만들기 위한 알고리즘이며, Random Forest는 이미 Variance가 큰 모델들을 평균 내어 Variance를 낮추는 전략이고, AdaBoost는 Bias가 큰 모델들을 순차적으로 보완해 Bias를 낮추는 전략이다.
2. AdaBoost 설계
Weak Learner: Decision Stump
일반적으로 Boosting 계열 앙상블 모델에서 Weak Learner로는 Decision Tree가 많이 사용되며, AdaBoost에서는 그중 가장 단순한 형태인 깊이가 1인 Decision Tree를 사용한다. 이를 Decision Stump라고 부른다.
깊이가 1이라는 것은 Root Node에서 딱 한 번의 분기만 일어난 형태이다. 즉 전체 Feature 중 단 하나의 Feature와 하나의 기준값(threshold)만으로 데이터를 두 그룹(Yes/No)으로 나누는, 가장 얕은 형태의 분류기다. 그만큼 단독으로는 예측 성능이 낮지만(High Bias), 계산이 빠르고 특정 데이터에 과하게 민감하게 반응하지 않는다는(Low Variance) 장점이 있다. 앞서 살펴본 것처럼 AdaBoost는 이런 Decision Stump를 여러 개 순차적으로 쌓아 올려 Bias를 낮춰가는 구조다.
최종 예측 수식
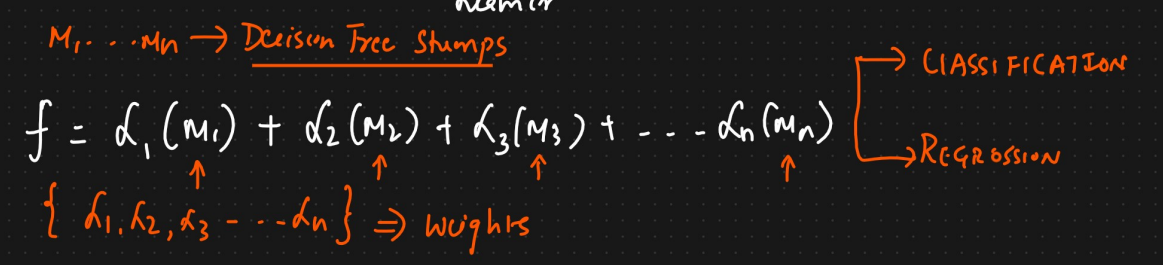
최종 분류 결과 F(x)는 각 Weak Learner의 예측값에 가중치를 곱해 더한 형태로 표현된다.
\[F(x) = α₁ · m₁(x) + α₂ · m₂(x) + ... + αₙ · mₙ(x)\]- $mₜ(x)$: t번째 Weak Learner(Decision Stump)가 입력 x에 대해 내놓은 예측값. 이진 분류 문제에서는 보통 +1 또는 -1의 값을 갖는다.
- $αₜ$: t번째 Weak Learner의 가중치(Performance of Stump). 해당 Stump가 학습 데이터를 얼마나 잘 맞췄는지에 따라 결정되며, 오차율이 낮을수록(=잘 맞출수록) 값이 커지고, 오차율이 높을수록 최종 예측에 미치는 영향력은 작아진다.
즉 모든 Stump가 동등한 영향력을 행사하는 것이 아닌, 더 잘 맞춘 Stump가 더 큰 영향을 가진다는 것이 AdaBoost 결합 방식의 핵심이다.
3. AdaBoost 작동 과정
Decision Stump 생성
Decision Stump를 만들기 위해 기준이될 Feature를 무작위로 고르는 것이 아니라, 모든 Feature와 가능한 모든 분기 기준(threshold)을 탐색하여 가중 오차(weighted error, Total Error)가 가장 작은 조합을 선택한다. 완전 탐색에 가까운 방식이다.
먼저 데이터의 각각의 샘플은 가중치를 가지고 있다. 맨 처음에는 모든 샘플의 가중치가 동일하게 $w_i = 1/N$로 설정되며, 이후에도 전체 가중치의 합이 항상 1이 되도록 정규화가 유지된다.
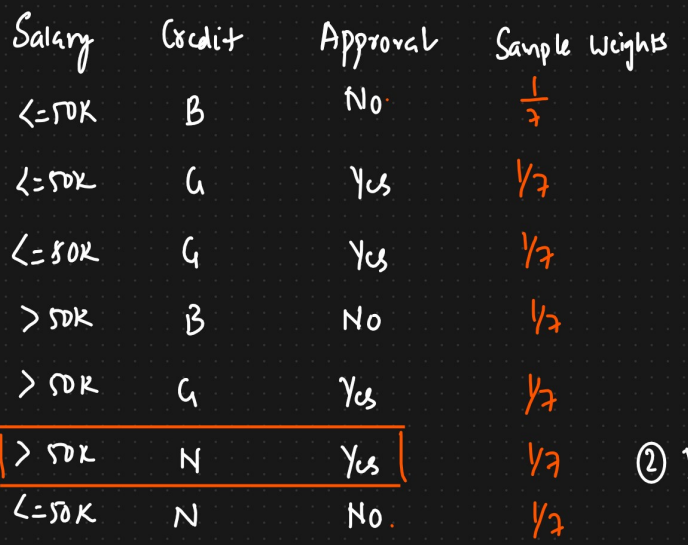
이후 아래의 과정을 통해 매 반복마다 Decision Stump를 생성한다.
- 모든 Feature를 하나씩 후보로 검토한다.
- 각 Feature에 대해 데이터를 정렬한 뒤, 가능한 분기 기준(threshold) 후보를 만든다. 보통 정렬된 값들 사이의 중간점(midpoint)을 후보로 삼는다.
- 각 (Feature, threshold) 조합마다 그 기준으로 데이터를 Yes/No 두 그룹으로 나눴을 때의 Weighted Error를 계산한다.
- 모든 (Feature, threshold) 조합 중 가중 오차가 가장 낮은 조합을 최종 Stump로 선택한다.
Total Error(Weighted Error)는 일반적으로 다음과 같이 정의된다.
\[\text{Total Error} = \frac{\displaystyle\sum_{i \,:\, \hat{y}_i \neq y_i} w_i}{\displaystyle\sum_{i=1}^{N} w_i}\]AdaBoost에서는 매 반복마다 샘플 가중치의 총합이 1이 되도록 정규화하기 때문에, 분모가 항상 1이 되어 다음과 같이 단순화된다.
\[\text{Total Error} = \sum_{i \,:\, \hat{y}_i \neq y_i} w_i\]- $w_i$ : $i$번째 샘플의 가중치
- $\hat{y}_i \neq y_i$ : 예측값과 실제값이 다른, 즉 오분류된 샘플
- $N$ : 전체 샘플 개수
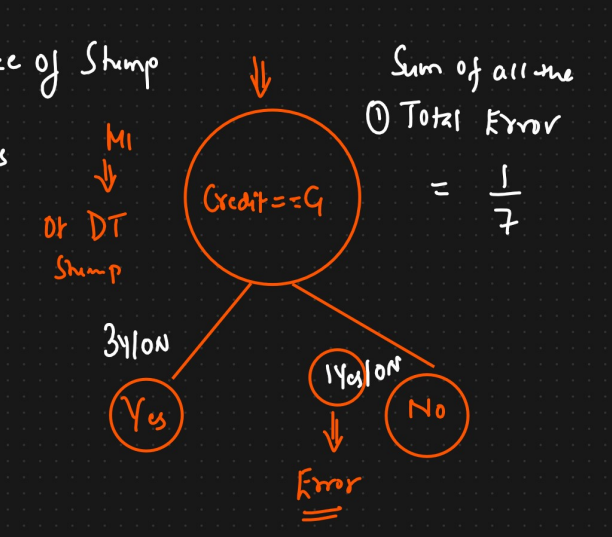
강의자료에서는 샘플 1개가 오분류 되어 $1/7$이 Total Error가 되었다.
선택 로직 자체는 매 반복마다 동일하지만, 맨처음에는 모든 샘플의 가중치가 동일($w_i = 1/N$)하다는 점에서 첫 번째 Stump는 전체 데이터셋 기준으로 가장 잘 나누는 Feature와 threshold를 찾는 과정이다.
두 번째 반복부터는 이전 라운드에서 틀린 샘플의 가중치가 커진 상태이기 때문에, 같은 탐색 과정을 거치더라도 틀렸던 샘플들을 더 잘 맞추는 방향으로 다른 Feature/threshold가 선택될 가능성이 높아진다.
Performance of Decision Stump
Total Error는 위에서처럼 (Feature, threshold) 조합의 Stump를 선택하는 기준임과 동시에 Performance of Stump($\alpha$)를 계산하는데 필요한 값이다.
Performance of Stump($\alpha$)는 다음과 같이 구한다:
\[\alpha = \frac{1}{2} \ln\left(\frac{1 - \text{Total Error}}{\text{Total Error}}\right)\]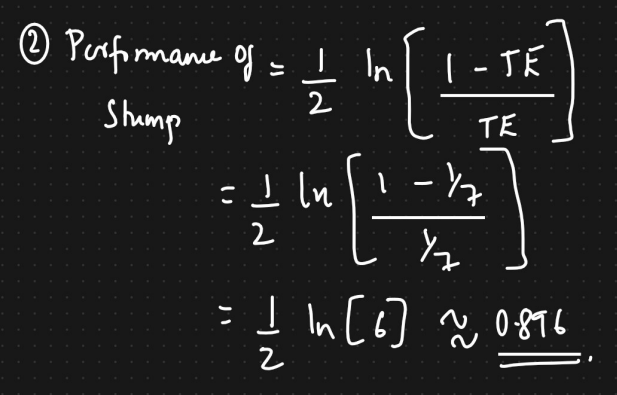
Updating Weights
이제 각 샘플의 분류 결과에 따라 정분류된 샘플의 가중치는 줄이고, 오분류된 샘플의 가중치는 증가시킨다.
샘플 $i$의 새 가중치는 다음과 같이 계산한다. (분류 기준 설명)
\[w_i \leftarrow w_i \cdot e^{-\alpha \, y_i \, h(x_i)}\]여기서 $y_i$는 실제 레이블, $h(x_i)$는 이번 Stump의 예측값으로 둘 다 $+1$ 또는 $-1$ 값을 갖는다. 이 식은 정분류/오분류 여부에 따라 아래처럼 두 가지 경우로 나뉜다.
\[w_i \leftarrow \begin{cases} w_i \cdot e^{-\alpha} & (\text{정분류된 경우}) \\ w_i \cdot e^{\alpha} & (\text{오분류된 경우}) \end{cases}\]$\alpha > 0$인 일반적인 상황을 기준으로 보면, 정분류된 샘플은 $e^{-\alpha} < 1$이 곱해져 가중치가 줄어들고, 오분류된 샘플은 $e^{\alpha} > 1$이 곱해져 가중치가 커진다. 이렇게 갱신된 가중치는 전체 합으로 나누어 다시 총합이 1이 되도록 정규화한다.
\[w_i \leftarrow \frac{w_i}{\displaystyle\sum_{j=1}^{N} w_j}\]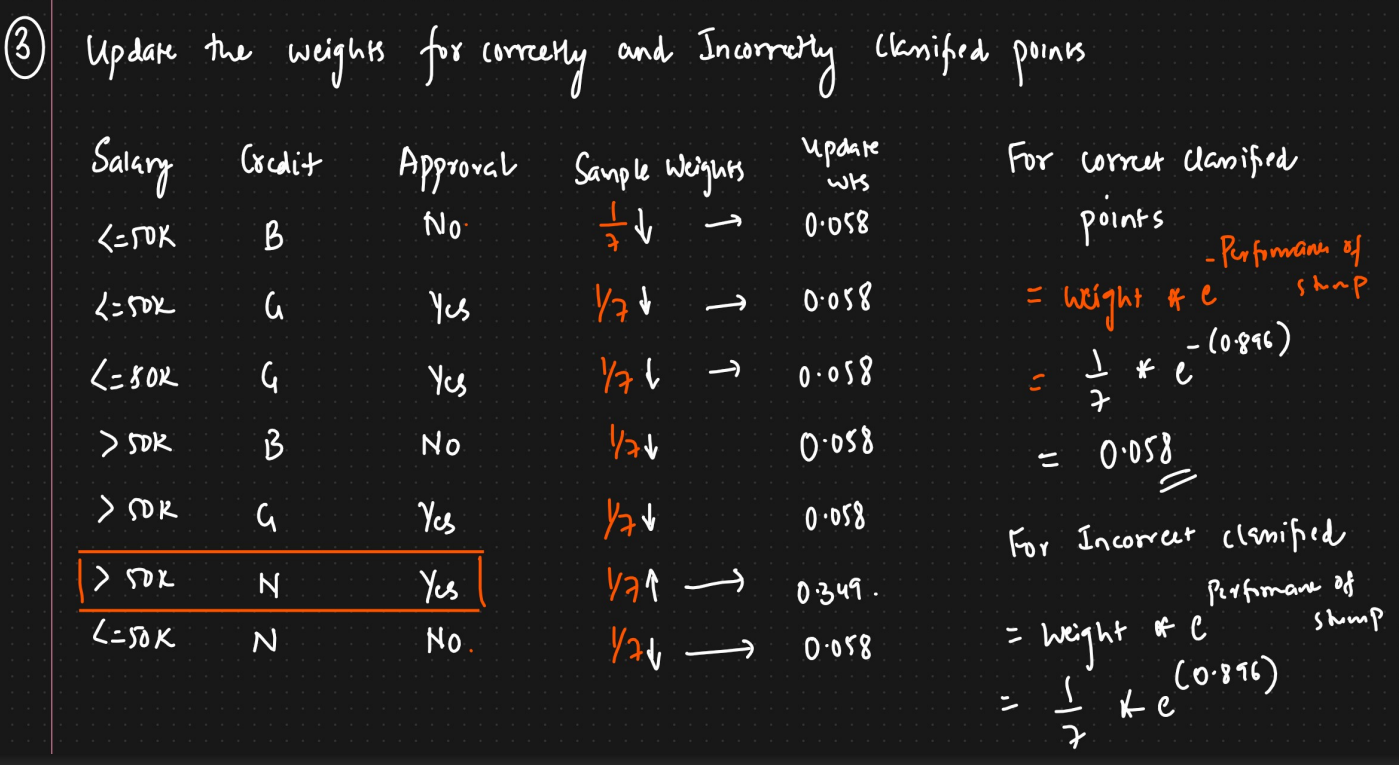
Boosting by Reweighting
다음 Weak Learner에게 데이터를 전달할 때, 데이터셋 자체는 그대로 두고 각 샘플의 가중치를 계속 누적해서 업데이트하는 방식이다.
다음 Weak Learner는 이 가중치를 직접 반영한 가중 손실(weighted Gini, weighted error 등)을 계산해 위 과정을 반복한다. 가중치는 매 반복마다 리셋되지 않고, 이전 값 위에 이어서 갱신되는 방식이다.
Boosting by Resampling
강의자료에서 설명하는 방식으로, 가중치를 확률분포로 변환한 뒤(누적합으로 Bins를 만들고) 그 분포를 따라 N개의 샘플을 복원추출(bootstrap)한다.
이렇게 하면 가중치가 큰(=Error가 컸던) 샘플일수록 뽑힐 확률이 높아지고, 실제로 다음 데이터셋에 여러 번 중복돼서 포함된다. 그 결과 다음 Weak Learner는 이전에 틀렸던 샘플들을 자연스럽게 더 많이 마주치며 학습하게 된다.
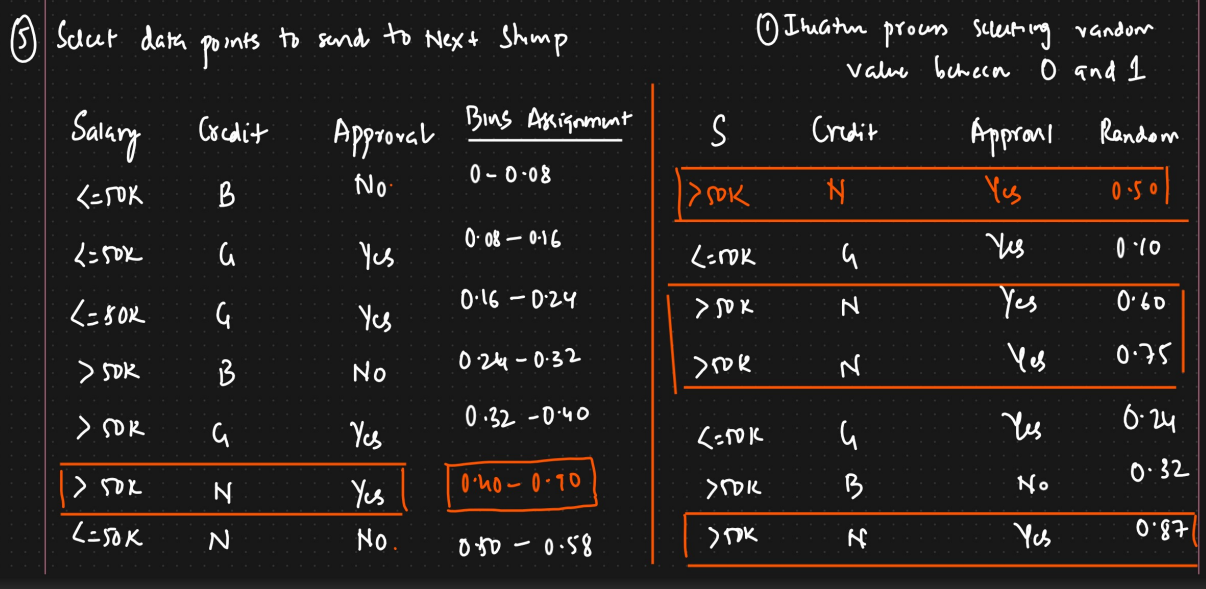
새로 뽑힌 데이터셋 안에서는 중요한 샘플일수록 이미 여러 번 중복되어 들어가 있으므로, 가중치로 별도의 중요도를 표시할 필요가 없다. 그래서 다음 learner는 이 새 데이터셋을 대상으로 모든 샘플이 다시 균등한 가중치($w_i = 1/N$)에서 시작한다.
두 방식은 같은 목표를 다르게 구현한 것이다. “가중치가 큰 샘플에게 다음 라운드에서 더 큰 영향력을 준다”는 목표는 동일하지만, Reweighting은 가중치를 숫자로 직접 전달하는 방식이고 Resampling은 그 가중치만큼 샘플을 물리적으로 복제해서 전달하는 방식이다. 표본 크기가 충분히 크다면 기댓값 관점에서 두 방식은 동등한 효과를 낸다. 다만 Resampling은 복원추출 과정에서 추가적인 무작위성(sampling noise)이 개입되어, 운이 나쁘면 중요한 샘플이 이번 라운드에 하나도 뽑히지 않을 수도 있다. 이 때문에 scikit-learn 등 실제 구현체 다수는 Resampling 대신 Reweighting(가중 손실 기반 분기)을 사용한다.
Final Prediction
이후의 학습 과정은 지금까지의 과정(Decision Stump 생성 → Performance 계산 → Weight Update → 다음 데이터셋 구성)을 정해진 반복 횟수 $T$만큼 반복하는 것이다. 매 반복마다 새로 구성된 데이터셋을 받은 Weak Learner는 다시 균등한 가중치로 시작해 같은 과정을 되풀이한다.
이렇게 $T$개의 Decision Stump $m_1, m_2, \dots, m_T$와 각각의 Performance $\alpha_1, \alpha_2, \dots, \alpha_T$가 모두 구해지면, 앞서 다룬 최종 예측 수식에 따라 이들을 가중합한 뒤 부호(sign)를 취해 최종 클래스를 결정한다.
\[F(x) = \text{sign}\left(\sum_{t=1}^{T} \alpha_t \, m_t(x)\right)\]※ 이 방식은 이진 분류 기준이며, 다중 클래스 분류의 경우 다른 방식의 확장이 필요하다