 hemisus

참고한/사용된 자료
1. Decision Tree
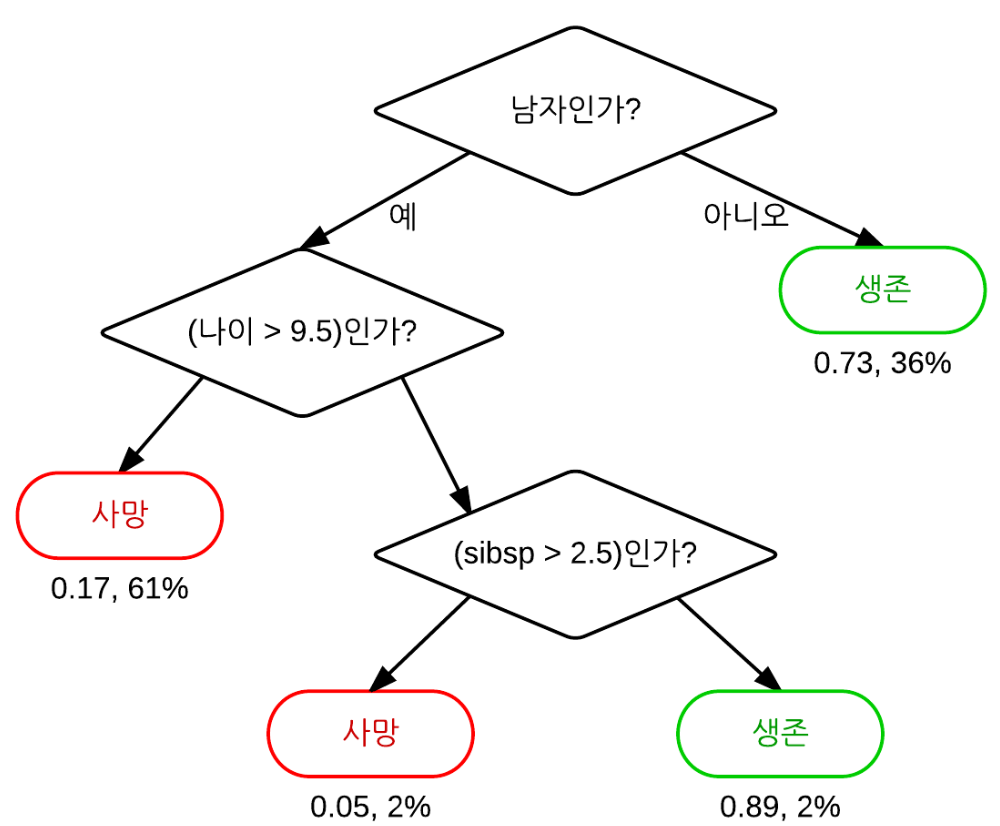
Decision Tree는 Tree 구조를 활용해 데이터의 Entropy와 불순도(Impurity)가 최소화되는 방향으로 분기하며 분류 혹은 회귀를 수행하는 지도학습 알고리즘이다.
여러 레이블, 혹은 여러 분포의 값이 섞여있는 데이터에서 시작하여 트리의 leaf node에 도달하면 최대한 어떤 범주의 데이터들로만 구성되도록 데이터를 나누는 것이다.
불순도(Impurity)
불순도란 어떤 데이터 집합에 서로 다른 범주(Class)의 데이터가 얼마나 섞여 있는지를 나타내는 수치이다. 수치가 높을수록 여러 범주의 데이터가 섞여 있는 상태이고, 반대로 수치가 0에 가까울수록 하나의 범주로만 깔끔하게 구성된 순수한 상태(Pure)를 의미한다.
의사결정나무는 자식 노드로 분기할 때 이 불순도를 최대한 줄여나가는 방향으로 기준을 설정한다. 불순도를 측정하는 대표적인 지표로 엔트로피(Entropy)와 지니 불순도(Gini Impurity)가 있다.
Entropy
어떤 노드 $S$에 대한 엔트로피는 다음과 같은 수식으로 계산한다.
\[Entropy(S) = - \sum_{i=1}^{c} p_i \log_2(p_i)\]-
$c$ : 데이터의 범주(Class) 개수
-
$p_i$ : 해당 노드에서 $i$번째 범주가 차지하는 비율 (확률)
엔트로피는 0~1 사이의 값을 가지며 데이터가 50:50 비율일때 최댓값을 가진다.
지니 불순도(Gini Impurity)
지니 불순도는 데이터 집합에서 하나의 데이터를 뽑아 무작위로 레이블을 예측할 때, 잘못 분류될 확률을 의미한다.
-
임의로 뽑은 데이터가 실제 $i$번째 범주일 확률 = $p_i$
-
내가 그 데이터를 $i$번째 범주라고 무작위로 예측할 확률 = $p_i$
-
그렇다면 이 예측이 적중(맞을) 확률 = $p_i \times p_i = p_i^2$
-
모든 범주에 대해 예측이 전체적으로 맞을 확률 = $\sum_{i=1}^{c} p_i^2$
우리가 원하는 건 ‘순수한 정도’가 아니라 ‘불순한 정도(틀릴 확률)’이므로, 전체 확률인 1에서 맞을 확률을 뺀다.
\[Gini(S) = 1 - \sum_{i=1}^{c} p_i^2\]엔트로피와 마찬가지로 데이터의 순도가 높을수록 0에 가까워지며, 50:50 비율일때 최댓값 0.5를 가진다.
Information Gain
정보 획득량(Information Gain)은 어떤 특징을 기준으로 데이터를 분할했을 때, 분할 전후로 불순도가 얼마나 감소했는가를 나타내는 지표이다. 불순도의 감소 수준을 나타내므로 Information Gain이 높을수록 좋은 분할이라는 것을 알 수 있다.
⇒ 결정 트리 알고리즘은 정보 획득을 최대화하는 방향으로 학습이 진행
엔트로피를 사용하여 설명하면, 정보 획득량은 부모 노드의 엔트로피에서 자식 노드들의 엔트로피 가중 평균을 뺀 값으로 계산한다.
\[IG(S, A) = Entropy(S) - \sum_{v \in Values(A)} \frac{|S_v|}{|S|} Entropy(S_v)\]- $S$ : 분할하기 전 부모 노드의 전체 데이터 집합
- $A$ : 데이터를 분할하는 기준 (속성)
- $S_v$ : 속성 $A$의 조건에 따라 분할된 자식 노드의 데이터 집합
- $|S|$ : 부모 노드의 전체 데이터 개수
- $|S_v|$ : 자식 노드의 데이터 개수
가지치기(Pruning)
트리의 분할이 너무 많아진다면 과적합이 발생할 수 있다. 트리의 최대 깊이, Leaf Node의 개수, 한 노드의 최소 데이터 수를 제한하여 적절한 크기의 트리가 만들어지도록 한다.
- 사전 가지치기 (Pre-Pruning): 트리가 생성될때부터 최대 깊이, 최소 데이터 수 제한 등으로 성장을 미리 멈춤. (데이터셋의 크기가 클때 사용하여 시간소요를 줄임)
- 사후 가지치기 (Post-Pruning): 트리를 완전히 성장시킨 후, 성능 향상에 크기 기여하지 않는 가지들을 제거하여 단순화. (시간 소요와 비용이 크기 때문에 적은 데이터셋을 다룰때 사용)
2. Ensemble, Bagging, Boosting
Ensemble
Ensemble(앙상블)은 머신러닝에서 여러 개의 개별 모델을 결합하여 하나의 더 강력한 모델을 만드는 기법이다. 단일 모델이 아닌 여러 모델의 예측을 결합하여 성능을 높이는 방식이며, 약한 모델(weak learner) 여러 개를 조합하면 더 강력한 모델(strong learner)이 될 수 있다는 것을 보여준다.
대표적인 앙상블 기법으로 배깅(Bagging)과 부스팅(Boosting)이 있다.
Bagging
Bagging(Bootstrap Aggregating) 은 여러 모델을 ‘병렬’로 학습시키는 기법이다.
- Bootstrap (데이터 분할): 원본 데이터셋에서 복원 추출(중복 허용)을 통해 랜덤하게 여러 개의 서브 데이터셋을 생성한다.
- 각각의 데이터셋으로 동일한 알고리즘의 모델을 여러개 독립적으로 학습시킨다.
- Aggregating (결과 종합): 각 모델의 예측 결과를 종합하여 최종 예측값을 결정.
결과적으로 모델의 분산을 줄이고 일반화 성능을 높이는 효과가 생긴다. 비유하자면 학생들이 혼자 시험을 풀고, 이후 다수결로 정답을 고르는 것이다. 각자 틀리는 문제는 다를 수 있지만, 함께 하면 정답률이 올라간다.
Boosting
배깅이 병렬의 성질을 가졌다면, 부스팅은 여러 모델을 ‘직렬(순차적)’로 연결하여 학습하는 기법이다.
- 첫 번째 모델이 전체 데이터를 학습하고 예측을 수행.
- 이때 예측이 틀린 데이터에 더 큰 가중치를 부여한다.
- 두 번째 모델은 앞선 모델이 틀린 데이터에 더 집중하여 학습을 진행.
- 이 과정을 순차적으로 반복하며 이전 모델의 약점을 계속해서 보완해 나간다.
앞선 모델의 실수를 다음 모델이 고쳐나가는 방식이므로 모델의 편향(Bias)을 줄이고 예측 정확도를 극대화하는 데 매우 효과적이다. 단, 순차적으로 학습해야 하므로 속도가 상대적으로 느리고 과적합에 빠질 위험이 있다.
3. Random Forest
Random Forest는 여러 개의 Decision Tree를 Bagging기법으로 학습시키는 모델이다. 또한 개별 트리들이 서로 너무 비슷해져 앙상블의 효과가 떨어지는 것을 막기 위해 ‘데이터’와 ‘특징(Feature)’에 대해 무작위성을 부여한다.
- 데이터 무작위성 (Bootstrap Sample): 원본 데이터셋에서 복원 추출을 통해 여러 개의 서브 데이터셋을 무작위로 만든다. (Row 단위의 무작위 추출)
- 특징 무작위성 (Feature Subset): 트리가 분기할 때, 모든 특징을 고려하는 것이 아니라 일부 특징만 무작위로 선택하여 그중에서 최적의 기준을 찾는다. (Column 단위의 무작위 추출)
만약 압도적으로 중요한 특징이 있다면, 모든 트리가 그 특징 위주로만 분기하여 똑같이 생긴 나무들만 만들어질 것이다. -> 특징 선택에 제한을 두면 다양하고 독립적인 형태의 트리들이 생성될 수 있다.
랜덤 포레스트의 학습과 예측은 다음과 같은 단계로 진행된다.
- 데이터를 여러 개의 데이터셋으로 분할(Bootstrap)한다.
- 각각의 데이터셋을 이용해 트리를 만든다. 이때 분기할 때마다 전체 특징(Feature) 중 일부를 무작위로 골라(Subset), 그 안에서 불순도를 가장 많이 줄이는 기준으로 분기한다.
- 1번과 2번의 과정을 반복하여, 서로 조금씩 다른 형태로 훈련된 여러개의 의사결정트리를 만든다.
- 각 트리는 Bootstrap 데이터와 선택된 Subset으로 의사결정트리를 만든다.
- 결과 집계 (Aggregation): 새로운 데이터가 들어오면 모든 트리가 각자 예측을 수행한다. 분류 문제라면 가장 많이 나온 결과를 다수결로 선택하고, 회귀 문제라면 모든 트리의 예측값을 평균(Mean) 내어 최종 예측값을 결정한다.
장점: 단일 의사결정나무의 치명적인 단점인 과적합 문제를 효과적으로 해결하며, 노이즈 데이터에 강하고 예측 성능이 매우 뛰어나다.
단점: 수많은 트리가 복합적으로 작용하므로, 의사결정나무처럼 “왜 이런 결과가 나왔는지” 직관적으로 해석하기가 어렵다.