 hemisus

참고한/사용된 자료
Krish Naik의 ‘Complete Data Science,Machine Learning,DL,NLP Bootcamp’ 강의 내용을 참고하여 작성한 글입니다.
Gradient Boosting 소개
Gradient Boosting은 Ensemble 기법 중 Boosting 계열에 속하는 알고리즘이다. AdaBoost와 마찬가지로 여러 개의 Weak Learner를 순차적으로 학습시켜 하나의 Strong Learner를 만들어내지만, 순차적으로 보완하는 대상이 다르다. AdaBoost가 샘플의 가중치를 조정해가며 이전에 틀렸던 샘플에 더 집중하는 방식이라면, Gradient Boosting은 이전 모델이 설명하지 못한 잔차(residual)를 다음 Weak Learner가 직접 학습하도록 하는 방식으로 작동한다.
기본 아이디어
먼저 아주 단순한 초기 예측값(예: 전체 타겟값의 평균)으로 모델을 시작한다. 첫 Weak Learner는 모든 입력 $X$에 대해 타겟값의 평균을 항상 내놓는다.
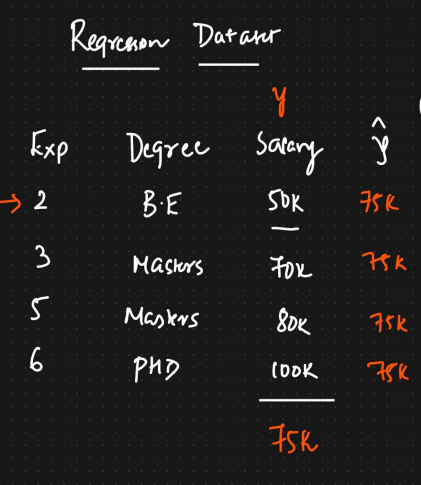
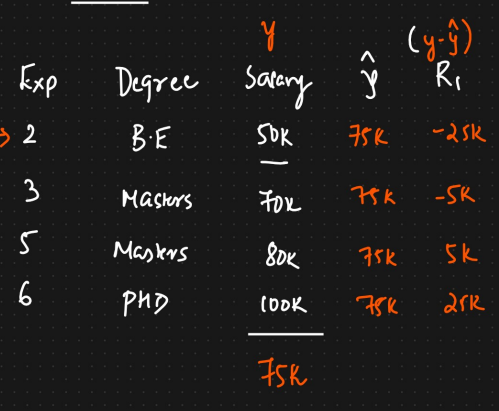
이 초기 예측값과 실제값의 차이, 즉 잔차 $R_1$을 계산한다. 다음 Weak Learner는 원래의 타겟값이 아닌 이 잔차를 예측하도록 학습된다.
새로 학습된 Weak Learner의 예측값(잔차)을 기존 예측값 $\hat{y}$에 더해 전체 예측을 업데이트한다. 이때 예측한 값을 그대로 더하는 것이 아니라, Learning Rate $\alpha$를 곱하여 더한다.
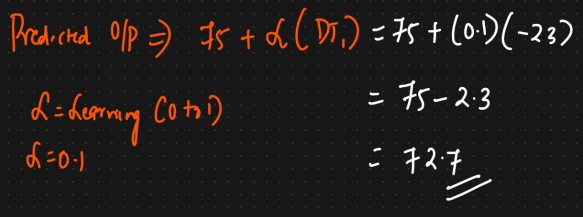
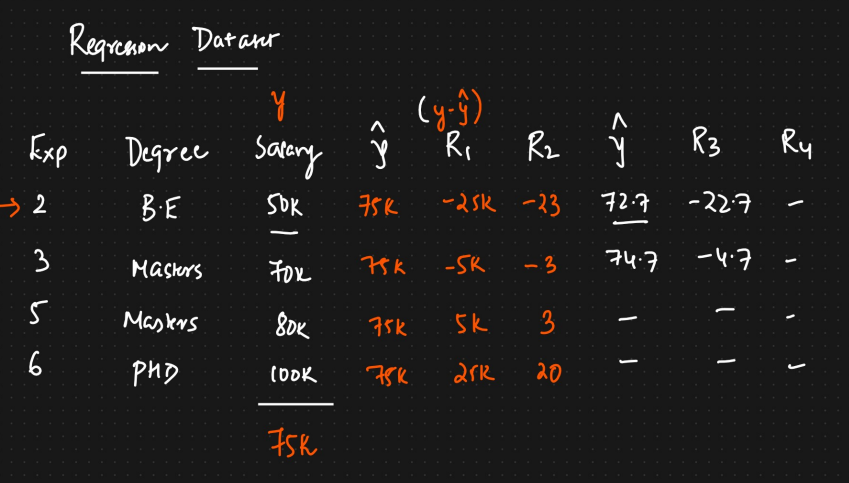
이 과정을 정해진 횟수만큼 반복하면서, 매 라운드마다 잔차를 조금씩 줄여나가는 방식이다.
즉 각 Weak Learner는 “정답이 무엇인가”를 직접 맞히는 것이 아니라, “지금까지의 모델이 아직 설명하지 못한 오차가 무엇인가”를 맞히는 역할을 한다. 라운드가 거듭될수록 잔차는 점점 작아지고, 전체 모델의 최종 예측값은 실제값에 점점 가까워진다.
\[F(x) = \sum_{t=1}^{T} \alpha_t \, h_t(x)\]- $h_t(x)$ : $t$번째 Weak Learner의 예측값
- $\alpha_t$ : $t$번째 Weak Learner의 가중치(Learning Rate)
- $T$ : 전체 반복(Weak Learner) 횟수
왜 ‘Gradient’라는 이름이 붙었는가
일반적인 경사하강법(Gradient Descent)은 파라미터 $\theta$를 손실 함수의 그래디언트 반대 방향으로 조금씩 이동시키며 손실을 줄여나가는 방법이다.
\[\theta \leftarrow \theta - \eta \cdot \frac{\partial L}{\partial \theta}\]Gradient Boosting은 이와 같은 아이디어를 가중치가 아니라 예측값 $\hat{y}$ 자체에 적용한 것이다. 회귀 문제에서 자주 쓰는 손실 함수인 제곱오차(Squared Error)를 예로 들어보자.
\[L(y, \hat{y}) = \frac{1}{2}(y - \hat{y})^2\]이 손실 함수를 예측값 $\hat{y}$에 대해 미분하면 다음과 같다.
\[\frac{\partial L}{\partial \hat{y}} = -(y - \hat{y})\]여기에 음수를 붙인 negative gradient는,
\[-\frac{\partial L}{\partial \hat{y}} = y - \hat{y} = \text{잔차}\]즉 잔차 자체가 손실 함수의 negative gradient와 정확히 같다. 그래서 앞서 살펴본 “다음 Weak Learner가 잔차를 학습해서 예측값에 더한다”는 과정은, 사실 “예측값 $\hat{y}$를 손실이 줄어드는 방향(negative gradient 방향)으로 한 걸음 이동시킨다”는 것과 동일한 의미다.
\[\hat{y} \leftarrow \hat{y} + \alpha \cdot \left(-\frac{\partial L}{\partial \hat{y}}\right)\]여기서 앞서 등장했던 Learning Rate $\alpha$는, 일반적인 경사하강법의 학습률과 정확히 같은 역할을 한다. 즉 Gradient Boosting이라는 이름은 “예측값을 파라미터처럼 취급하고, 손실 함수의 그래디언트를 따라 조금씩 개선한다”는 학습 방식 자체를 그대로 표현한 이름이다.
이렇게 손실 함수의 관점에서 바라보면, 손실 함수를 제곱오차가 아닌 다른 함수(예: 분류 문제의 로그 손실)로 바꾸는 것만으로 같은 프레임워크를 회귀, 분류 등 다양한 문제에 적용할 수 있다.
실제로 AdaBoost는 지수 손실 함수를 최소화하는 특수한 경우로 볼 수 있고, Gradient Boosting은 이를 임의의 손실 함수로 일반화한 프레임워크라고 볼 수 있다. (AdaBoost는 Gradient Boosting의 한 특수 사례로 해석할 수 있다.)