 hemisus

참고한/사용된 자료
Krish Naik의 ‘Complete Data Science,Machine Learning,DL,NLP Bootcamp’ 강의 내용을 참고하여 작성한 글입니다.
XGBoost
XGBoost(Extreme Gradient Boosting)는 Gradient Boosting을 기반으로, 여기에 정규화(Regularization)와 효율적인 분기 탐색 방식을 더해 성능과 속도를 개선한 알고리즘이다. Gradient Boosting과 마찬가지로 여러 개의 Weak Learner(Tree)를 순차적으로 학습시켜 이전 모델의 잔차를 보완해나가는 큰 틀은 동일하지만, 트리를 어떤 기준으로 분기할지, 그리고 각 리프(Leaf)의 예측값을 어떻게 정할지를 정의하는 방식이 조금 다르다.
학습 과정 (Regressor 기준)
먼저, 모든 샘플에 대해 동일한 초기 예측값에서 시작한다. Gradient Boosting과 마찬가지로 첫 Base Model은 보통 예측 레이블의 평균값을 출력하며, 그 후 실제값과 초기 예측값(평균)의 차이인 잔차 $R_1$를 계산한다.
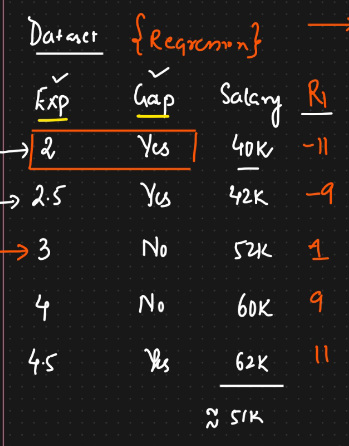
다음으로 의사결정 트리를 생성하는데, 원래의 타겟값이 아닌 이 잔차를 예측하도록 학습된다. 모든 데이터 $(X, R_1)$를 가진 하나의 Root Node에서 시작해, 가능한 모든 (Feature, threshold) 조합에서 데이터를 둘로 나눴을 때의 Gain을 계산한다.
Gain을 계산하기 위해서 Similarity Score를 계산해야 한다. Similarity Score는 한 노드 안에 모인 잔차($R_1$)들이 얼마나 “일관된 방향을 가리키는지”를 나타내는 지표다. 잔차들이 서로 비슷한 방향(부호와 크기)을 가질수록 값이 커진다.
\[\text{Similarity Score} = \frac{\left(\displaystyle\sum_{i=1}^{n} r_i\right)^2}{n + \lambda}\]- $r_i$ : 해당 노드에 속한 $i$번째 샘플의 잔차
- $n$ : 해당 노드에 속한 샘플 수
- $\lambda$ : 정규화(Regularization) 파라미터
Gain은 하나의 노드를 둘(Left/Right)로 나눴을 때, 그 분기가 얼마나 좋은 선택인지를 나타내는 지표다. 분기 전(Root)보다 분기 후(Left + Right)의 Similarity 합이 클수록 좋은 분기다.
\[\text{Gain} = \text{Similarity}_{\text{Left}} + \text{Similarity}_{\text{Right}} - \text{Similarity}_{\text{Root}}\]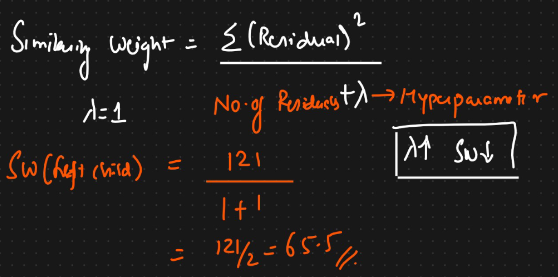
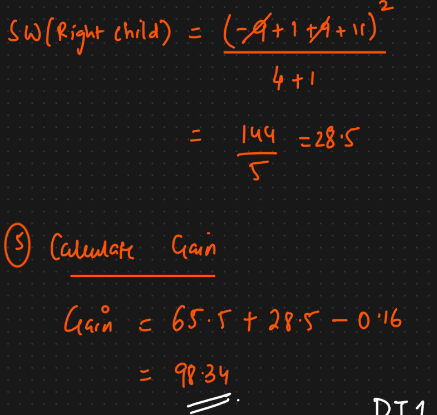
이렇게 각 (Feature, threshold) 조합에 대해 구한 트리에서 Gain이 가장 큰 조합으로 트리를 분기한다. 이 과정을 트리가 정해진 깊이(max_depth)에 도달하거나 더 이상 나눌 데이터가 없을 때까지 반복한다. 트리가 완성되면, 이렇게 만들어진 분기들 중 불필요한 것을 가지치기한다.
※ 만약 가장 좋은 Gain조차 정해둔 임계값 $\gamma$보다 작다면(즉 $\text{Gain} - \gamma < 0$), 그 분기는 가지치기한다. $\gamma$는 트리가 너무 잘게 쪼개지는 것을 막는 Hyperparameter로, 트리를 최대 깊이까지 모두 성장시킨 뒤 가지치기(post-pruning)를 적용한다.
트리가 생성되었으면 각 리프(Leaf)의 출력값을 계산한다. 데이터가 들어오면 기준에 따라 leaf node에 도달하게 되고, 도달한 노드에 속한 잔차들을 바탕으로 그 리프의 최종 출력값을 계산한다. 회귀의 경우 아래 식처럼 정규화 항이 포함된 평균값을 사용한다.
\[\text{Output Value} = \frac{\displaystyle\sum_{i=1}^{n} r_i}{n + \lambda}\]이렇게 구한 트리의 예측값에 Learning Rate $\alpha$를 곱하여 반영한다.
\[\hat{y} \leftarrow \hat{y} + \alpha \cdot (\text{Output Value})\]이렇게 갱신된 예측값을 기준으로 잔차를 다시 계산하고, 같은 과정을 반복해 다음 트리를 학습시킨다. 이 과정을 정해진 트리 개수만큼 반복하며 모델 전체를 학습시킨다.
※ Similarity Score, Output value 수식 모두 분모에 $\lambda$가 들어있다. $\lambda$가 커질수록 두 값 모두 작아지는데, 이는 노드에 속한 샘플 수($n$)가 적거나 잔차 합이 우연히 크게 나온 경우(이상치의 영향 등)에 모델이 과도하게 확신을 갖지 않도록 억제하는 효과를 낸다.
XGBoost Classifier
log-odds
Classifier의 차이를 이해하려면 먼저 log-odds 개념을 짚고 넘어가야 한다. log-odds는 확률 $p$를 아래처럼 변환한 값이다.
\[\text{log-odds} = \log\left(\frac{p}{1-p}\right)\]확률 $p$는 항상 $[0, 1]$ 사이 값이어야 하지만, log-odds는 $-\infty$부터 $+\infty$까지 자유로운 실수값을 가진다. Boosting은 여러 트리의 출력값을 계속 더해나가는 방식인데, 만약 이 덧셈을 확률 공간에서 그대로 하면 값이 금방 [0, 1]에서 벗어나 확률로서의 의미가 깨진다. 그래서 트리의 출력을 확률이 아닌 log-odds 공간에서 자유롭게 더하고, 확률이 필요한 순간에만 sigmoid 함수로 변환한다.
\[p = \frac{1}{1 + e^{-\text{log-odds}}}\]예를 들어 $p=0.5$일 때 log-odds는 정확히 0이고, $p$가 1에 가까워질수록 log-odds는 $+\infty$로, 0에 가까워질수록 $-\infty$로 발산한다.
Classifier의 차이점
Classifier의 전체 흐름(잔차 계산 → 분기 → Output Value 계산 → 예측값 업데이트)은 Regressor와 동일하지만, 다루는 값의 형태와 일부 수식이 달라진다.
- 초기 예측값: 회귀에서는 보통 평균값에서 출발하지만, 분류에서는 확률 0.5, 즉 log-odds값 0에서 출발한다.
- 잔차: 실제 클래스($y_i \in {0, 1}$)와 예측 확률 $p_i$의 차이로 정의된다.
- Similarity Score / Output Value의 분모: 회귀에서는 단순히 샘플 개수 $n$을 사용했지만, 분류에서는 각 샘플의 $p_i(1-p_i)$ 값을 모두 더한 값으로 바뀐다. 이는 로지스틱 손실 함수를 사용하기 때문에 나타나는 차이로, 예측 확률이 0.5에 가까워 불확실한 샘플일수록 이 값이 커진다.
- 예측값 업데이트와 확률 변환: Output Value는 확률이 아니라 log-odds 공간에 더해진다. 즉 log-odds를 업데이트한 뒤, 이를 다시 시그모이드 함수로 변환해야 확률값을 얻을 수 있다.
정리하면, Regressor와 Classifier의 차이는 결국 “분모에 어떤 값을 쓰는가”와 “결과값을 어느 공간(실수값 vs log-odds)에서 다루는가” 두 가지로 요약할 수 있다. 트리를 분기하고 Gain을 비교해 가장 좋은 구조를 찾는 핵심 로직 자체는 두 경우 모두 동일하다.