 hemisus

논문 정보
- 제목: Revisiting Deep Learning Models for Tabular Data
- arXiv: 2106.11959
- 코드: yandex-research/rtdl-revisiting-models
1. Introduction
이미지, 오디오, 텍스트에서의 성공 이후로, 테이블(정형) 데이터에도 딥러닝을 적용하려는 시도가 늘고 있다.
잠재적으로 GBDT보다 높은 성능을 낼수도 있고, 입력의 일부만 테이블이고 나머지는 이미지/오디오인 멀티모달 파이프라인을 gradient 기반으로 end-to-end 학습할 수 있다는 점에서 DL 아키텍쳐는 정형 데이터에서도 매력적일 수 있다.
하지만, 이 분야에 ImageNet(CV)이나 GLUE(NLP) 같은 확립된 벤치마크가 없어 논문마다 서로 다른 데이터셋을 쓰며 제안된 모델들이 서로 제대로 비교되지 않는다.
- 그래서 “어떤 DL 모델이 일반적으로 더 좋은가”, “딥러닝이 GBDT를 넘어섰는가”에 대한 답이 불분명하다.
- 적당한 노력으로 여러 태스크에서 안정적인 성능을 내는 신뢰할 만한 베이스라인이 부족하다. MLP가 그 역할을 해왔지만, 다른 모델들에 비해 성능이 충분하지 않음.
이 논문이 정리한 네 가지 기여(Contribution)는 다음과 같다.
- Tabular 데이터용 주요 DL 모델들을 다양한 task에서 공정하게 평가하여 상대적 성능을 조사.
- ResNet 계열 아키텍처가 효과적인 베이스라인임을 보임.
- Transformer를 정형 데이터에 각색한 FT-Transformer를 제안. 대부분의 태스크에서 최고 성능을 보이며, 다른 DL 모델보다 넓은 범위의 태스크에서 잘 작동하는 “보편적(universal)” 아키텍처임을 확인한다.
- GBDT와 딥러닝 모델 사이에 아직 보편적 승자는 없다.
2. Related Work
딥러닝을 제외한, 전통적인(=shallow) 머신러닝 방법들 중에서는 GBDT가 정형 데이터의 최고 성능(SOTA) 자리를 차지하고 있다(XGBoost, LightGBM, CatBoost). 이들은 구현 디테일이 달라도 대부분의 태스크에서 성능 차이가 크지 않다.
한편 최근 제안된 딥러닝 모델들은 대략 세 갈래로 나눌 수 있다.
(1) Differentiable Trees (미분 가능한 트리)
결정 트리 앙상블의 강력함에서 출발한 계열. 결정 트리는 미분 불가능해서 end-to-end 학습을 할 수 없으므로, 내부 노드의 결정 함수를 smooth하여 트리 함수와 라우팅을 미분 가능하게 만든다(NODE 등). 일부 태스크에서 GBDT를 이기기도 하지만, 이 논문 실험에서는 ResNet을 일관되게 이기지 못했다.
(2) Attention-based Models (어텐션 기반)
어텐션 모듈을 tabular 데이터에 도입한 계열(TabNet, AutoInt 등). 하지만 실험 결과, 잘 튜닝한 ResNet이 기존 어텐션 기반 모델들을 능가했다. 그럼에도 저자들은 Transformer를 정형 데이터에 제대로 적용하는 방법을 찾아냈고, 그 결과가 FT-Transformer다.
(3) 곱셈적 상호작용의 명시적 모델링
추천 시스템·CTR 예측 문헌에서 MLP가 feature 간 곱셈적 상호작용을 잘 모델링하지 못한다는 비판이 있었다. 이에 feature product를 MLP에 넣는 방법들이 제안됐다(DCN V2 등). 하지만 이 논문에서는 잘 튜닝한 베이스라인보다 우월하지 않았다.
3. Models for tabular data problems
Notation
- 데이터셋 $D = {(x_i, y_i)}_{i=1}^n$
- 각 객체 $x_i = (x_i^{(num)}, x_i^{(cat)})$ — 수치형·범주형 feature
- feature 총 개수 $k$
- $D = D_{train} \cup D_{val} \cup D_{test}$ (val은 early stopping과 hyperparams튜닝, test는 최종 평가에만 사용)
- 이진 분류 $Y={0,1}$, 다중 분류 $Y={1,\dots,C}$, 회귀 $Y=\mathbb{R}$ 에 대해서 진행
3.1 MLP
\(\text{MLP}(x) = \text{Linear}(\text{MLPBlock}(\dots(\text{MLPBlock}(x))))\)
\(\text{MLPBlock}(x) = \text{Dropout}(\text{ReLU}(\text{Linear}(x)))\)
3.2 ResNet
ResNet이 입력에서 출력까지 명확한 경로(clear main path)를 갖도록 블록을 단순화했다. 이 구조가 최적화에 유리했다.
\(\text{ResNet}(x) = \text{Prediction}(\text{ResNetBlock}(\dots(\text{ResNetBlock}(\text{Linear}(x)))))\)
\(\text{ResNetBlock}(x) = x + \text{Dropout}(\text{Linear}(\text{Dropout}(\text{ReLU}(\text{Linear}(\text{BatchNorm}(x))))))\)
\(\text{Prediction}(x) = \text{Linear}(\text{ReLU}(\text{BatchNorm}(x)))\)
3.3 FT-Transformer
Feature Tokenizer + Transformer. 모든 feature(수치형·범주형)를 임베딩으로 바꾼 뒤, 그 임베딩들에 Transformer 레이어를 쌓는다.
\[\text{FT-Transformer}(x) = \text{Prediction}(\text{Block}(\dots(\text{Block}(\text{FeatureTokenizer}(x)))))\](a) Feature Tokenizer
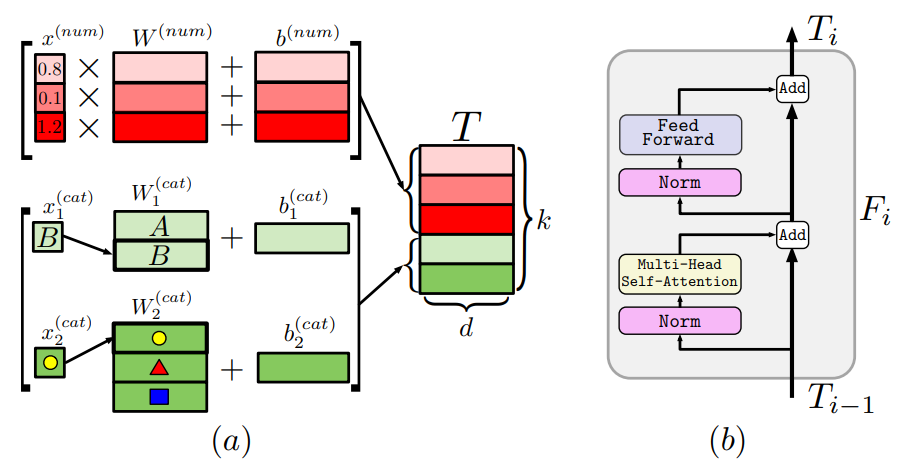
입력 feature $x$를 임베딩 $T \in \mathbb{R}^{k \times d}$로 변환한다. feature $x_j$에 대한 임베딩은:
\[T_j = b_j + f_j(x_j) \in \mathbb{R}^d, \quad f_j : X_j \to \mathbb{R}^d\]여기서 $b_j$는 $j$번째 feature bias이고,
- 수치형: $f_j^{(num)}$은 벡터 $W_j^{(num)} \in \mathbb{R}^d$와 element-wise 곱
\(T_j^{(num)} = b_j^{(num)} + x_j^{(num)} \cdot W_j^{(num)} \in \mathbb{R}^d\) - 범주형: $f_j^{(cat)}$은 lookup table $W_j^{(cat)} \in \mathbb{R}^{S_j \times d}$
\(T_j^{(cat)} = b_j^{(cat)} + e_j^{T} W_j^{(cat)} \in \mathbb{R}^d\)
($e_j$는 해당 범주형 feature의 one-hot 벡터)
모든 토큰을 쌓으면:
\[T = \text{stack}\left[T_1^{(num)}, \dots, T_{k^{(num)}}^{(num)}, T_1^{(cat)}, \dots, T_{k^{(cat)}}^{(cat)}\right] \in \mathbb{R}^{k \times d}\]여기서 feature bias($b_j$)가 중요한 설계 요소다. 이걸 빼면 성능이 눈에 띄게 떨어진다.
(b) Transformer
여기에 [CLS] 토큰(출력 토큰)을 붙이고 $L$개의 Transformer 레이어 $F_1, \dots, F_L$을 적용한다:
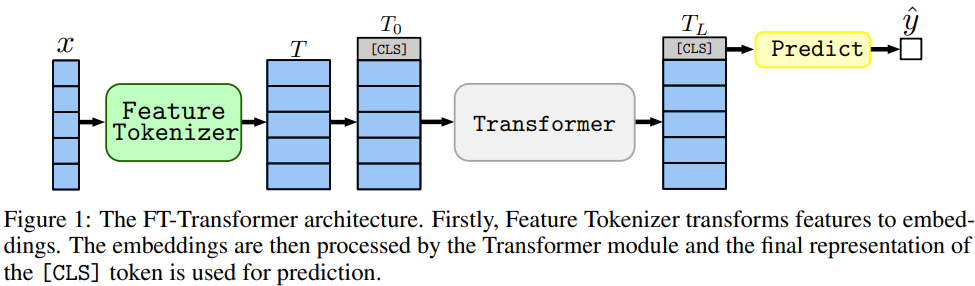
- PreNorm 변형을 사용한다(최적화가 쉬움). 즉 정규화를 각 residual branch의 시작에 둔다.
- PreNorm 세팅에서 좋은 성능을 위해 첫 번째 Transformer 레이어의 첫 정규화를 제거해야 했다.
- Norm: LayerNorm
\(\text{Block}(x) = \text{ResidualPreNorm}(\text{FFN},\ \text{ResidualPreNorm}(\text{MHSA},\ x))\)
\(\text{ResidualPreNorm}(\text{Module}, x) = x + \text{Dropout}(\text{Module}(\text{Norm}(x)))\)
\(\text{FFN}(x) = \text{Linear}(\text{Dropout}(\text{Activation}(\text{Linear}(x))))\)
(c) Prediction
마지막 레이어의 [CLS] 토큰 표현으로 예측한다:
Limitations
- ResNet 같은 단순 모델보다 학습에 더 많은 자원과 시간이 든다.
- vanilla MHSA의 feature 수에 대한 Quadratic 복잡도 때문에 feature가 너무 많은 데이터에는 확장이 어렵다. (완화책: 어텐션 근사, 또는 FT-Transformer를 단순 구조로 distillation)
3.4 비교 대상 모델들
tabular 데이터 전용으로 설계된 기존 모델들도 함께 비교했다.
| 모델 | 계열 / 특징 |
|---|---|
| SNN | SELU 활성화로 더 깊은 학습을 가능케 한 MLP 계열 |
| NODE | oblivious decision tree의 미분 가능 앙상블 |
| TabNet | feature 재가중과 FFN을 번갈아 쓰는 recurrent 구조 |
| GrowNet | gradient boosted 약한 MLP들 (분류·회귀만 지원) |
| DCN V2 | MLP 모듈 + feature crossing 모듈 |
| AutoInt | feature를 임베딩 후 어텐션 기반 변환 적용 |
| XGBoost | 대표적 GBDT 구현 |
| CatBoost | oblivious decision tree를 weak learner로 쓰는 GBDT |
4. Experiments
이 논문은 아키텍처가 부여하는 inductive bias 자체를 평가하는 데 초점을 둔다. 따라서 pretraining, 추가 loss, data augmentation, distillation, learning rate warmup/decay 같은 기법은 사용되지 않았다.
데이터셋 (11개)
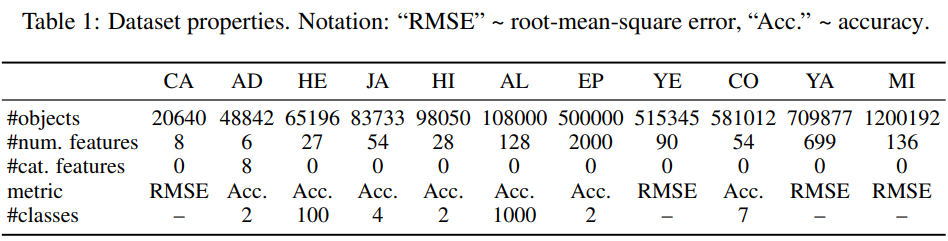
다양한 공개 데이터셋 11개를 사용하며, 각 데이터셋은 정확히 하나의 train-val-test split을 공유한다. 랭킹 문제(Microsoft, Yahoo)는 pointwise 방식으로 회귀 취급.
| 약자 | 데이터셋 | #객체 | #수치 | #범주 | metric | #클래스 |
|---|---|---|---|---|---|---|
| CA | California Housing | 20,640 | 8 | 0 | RMSE | – |
| AD | Adult | 48,842 | 6 | 8 | Acc. | 2 |
| HE | Helena | 65,196 | 27 | 0 | Acc. | 100 |
| JA | Jannis | 83,733 | 54 | 0 | Acc. | 4 |
| HI | Higgs Small | 98,050 | 28 | 0 | Acc. | 2 |
| AL | ALOI | 108,000 | 128 | 0 | Acc. | 1000 |
| EP | Epsilon | 500,000 | 2000 | 0 | Acc. | 2 |
| YE | Year | 515,345 | 90 | 0 | RMSE | – |
| CO | Covertype | 581,012 | 54 | 0 | Acc. | 7 |
| YA | Yahoo | 709,877 | 699 | 0 | RMSE | – |
| MI | Microsoft | 1,200,192 | 136 | 0 | RMSE | – |
Preprocessing
- 기본적으로 scikit-learn의 quantile transformation 사용.
- Helena, ALOI에는 standardization 적용(ALOI는 이미지 데이터라 CV 관례를 따름).
- Epsilon은 전처리가 오히려 성능을 저하시켜 raw feature 사용.
- 모든 알고리즘에서 회귀 문제의 타깃은 standardization적용.
Tuning
- 대부분 모델은 Optuna로 베이지안 최적화(TPE) 수행. 나머지는 각각의 원래 논문이 권장한 설정 조합을 순회.
- 하이퍼파라미터는 validation set 성능으로 선택(test는 절대 튜닝에 안 씀).
Evaluation
- 튜닝된 각 구성에 대해 서로 다른 랜덤 시드 15개로 실험 후 test 성능 보고.
Ensembles
- 각 모델·데이터셋마다 15개 단일 모델을 크기가 같은 3개 그룹으로 나눠, 그룹 내 예측을 평균 → 앙상블 3개 확보.
학습 세부
- 분류: cross-entropy, 회귀: MSE.
- Optimizer: TabNet·GrowNet은 Adam, 나머지는 AdamW. learning rate schedule 없음.
- Early stopping: patience = 16 (16+1 epoch 동안 val 개선 없으면 종료).
- 범주형: XGBoost는 one-hot, CatBoost는 내장 지원, NN은 동일 차원 임베딩.
5. 결과
Comparing DL models
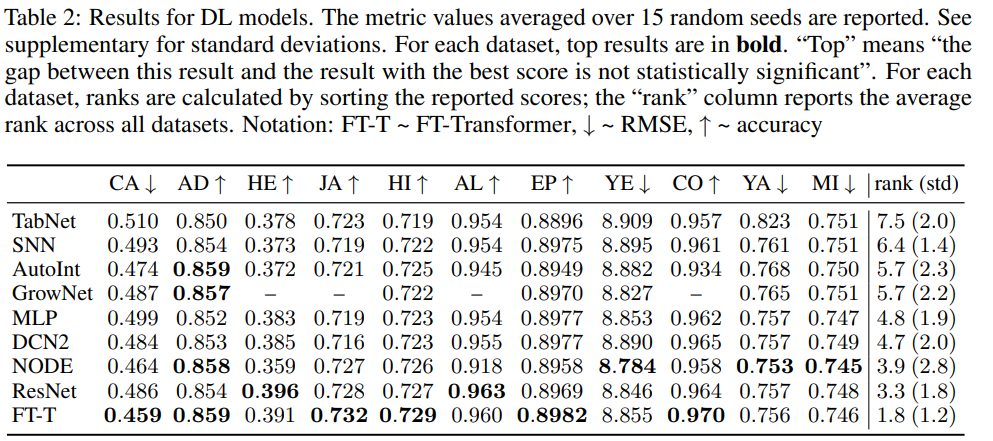
- ResNet은 효과적인 베이스라인. 평균 순위 3.3으로 DL 모델 중 2위.
- FT-Transformer는 대부분 task에서 최고 성능(평균 순위 1.8)
- 튜닝이 MLP·ResNet 같은 단순 모델을 경쟁력 있게 만든다. 따라서 가능하면 베이스라인도 튜닝하기를 권한다.
- NODE는 몇몇 태스크에서 높은 성능을 보이지만, 복잡한 구조임에도 ResNet보다 6개 데이터셋(HE, JA, HI, AL, EP, CO)에서 낮은 성능을 보여줌.
Comparing DL models and GBDT
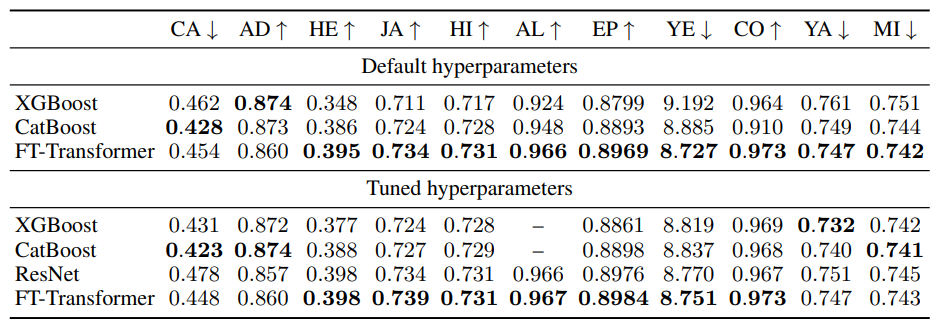
Default 하이퍼파라미터 관점
- FT-Transformer 앙상블이 대부분 GBDT 앙상블을 능가
- default FT-Transformer 앙상블이 tuned FT-Transformer 앙상블과 거의 비슷한 성능을 보임.
Tuned 하이퍼파라미터 관점
- 제대로 튜닝하면 GBDT가 일부 데이터셋(CA, AD, YA)에서 우위를 점하고, 그 격차가 유의미하다.
- 즉 딥러닝이 GBDT를 보편적으로 이기는 것은 아니다. 또한 벤치마크 자체가 약간 “DL-friendly”하게 편향됐을 수 있음을 저자들도 인정함.
- GBDT는 클래스가 많은 다중 분류에는 부적합하다(Helena에서 성능 저조, ALOI는 학습이 너무 느려 튜닝 불가).
6. Analysis
When FT-Transformer is better than ResNet?
두 모델의 성능 차이가 극적으로 변하도록 합성 태스크를 설계했다.
\[x \sim N(0, I_k), \qquad y = \alpha \cdot f_{GBDT}(x) + (1-\alpha)\cdot f_{DL}(x)\]- $f_{GBDT}$: 랜덤하게 구성한 30개 결정 트리의 평균 예측 (GBDT에 유리하게 설계)
- $f_{DL}$: 랜덤 초기화된 3개 hidden layer MLP (ResNet에 유리하게 설계)
$\alpha$가 0(=DL-friendly)에서 1(=GBDT-friendly)로 변할 때:
- $\alpha$가 작을 때(DL-friendly): ResNet과 FT-Transformer 모두 비슷하게 준수한 성능을 보이며 CatBoost를 능가함.
- $\alpha$가 커질 때(GBDT-friendly): ResNet의 상대 성능이 급격히 하락.
- 반면 FT-Transformer는 전 구간에서 경쟁력을 유지.
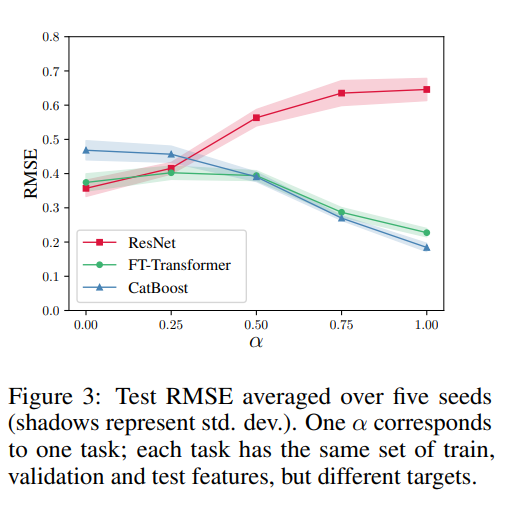
이 실험은 “FT-Transformer가 ResNet보다 잘 근사하는 함수 유형”이 존재함을 보여주며, 그 함수가 결정 트리 기반이라는 점이 관찰(= GBDT가 우세한 데이터셋에서 FT-Transformer의 개선이 가장 확실함)과 일치한다.
Obtaining feature importances from attention maps
FT-Transformer의 어텐션 맵을 feature importance의 원천으로 활용할 수 있다. $i$번째 샘플에 대해 [CLS] 토큰의 평균 어텐션 맵 $p_i$를 구하고, 이를 전체 샘플에 대해 평균낸다:
($p_{ihl}$ = $l$번째 레이어, $h$번째 head의 [CLS] 어텐션 맵)
장점은 효율성 — 샘플당 forward 한 번이면 된다. 이를 Integrated Gradients(IG), Permutation Test(PT)와 비교(PT 랭킹과의 rank correlation 측정):
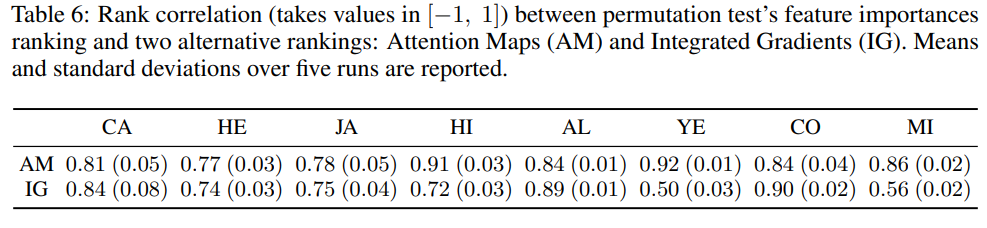
단순 어텐션 맵 평균이 IG와 비슷한 수준의 feature importance를 준다. IG는 수십~수백 배 느릴 수 있고 PT는 (feature 수 + 1)번의 forward가 필요한 반면, 이 방법은 forward 한 번이면 되므로 비용 대비 효과가 좋은 선택이다. (단, IG와 성능이 비슷하다는 게 IG와 importance가 동일하다는 뜻은 아니다.)
그 외
- FT-Transformer는 ResNet보다 느리다. feature가 많은 Yahoo(699개)에서는 약 13.8배 오버헤드가 발생 — 어텐션의 이차 복잡도 탓.
- FT-Transformer는 랜덤 샘플링된 몇 개 구성만으로도 좋은 지표에 도달한다. 즉 FT-Transformer의 강한 성능이 “더 오래 튜닝해서”가 아니라는 것도 확인된다. 반대로 다른 알고리즘은 iteration을 크게 늘려도 의미 있는 개선이 없었다.
Conclusion
이 논문은 Tabular 데이터에서 딥러닝 모델의 성능을 확인하고, 베이스라인 수준을 향상시켰다.
- ResNet 계열의 단순한 구조가 효과적인 베이스라인이 될 수 있음을 보였다.
- FT-Transformer를 제안했고, 대부분의 태스크에서 다른 딥러닝 모델을 능가했다.
- 이 새로운 베이스라인들을 GBDT와 비교한 결과, 일부 태스크에서는 여전히 GBDT가 우위를 지킨다는 점도 확인했다.