 hemisus

논문 정보
- 제목: SCARF: Self-Supervised Contrastive Learning using Random Feature Corruption
- arXiv: 2106.15147
비전(SimCLR)이나 NLP(BERT, GPT-3)에서는 self-supervised pretraining이 크게 성공했는데, 그 핵심은 도메인에 맞는 “view 생성 방법”이었다(비전의 crop/color distortion, NLP의 token masking). 그런데 정작 현실에서 가장 흔한 데이터 형태인 테이블 형태 데이터(tabular data) 에서는 이런 기법이 거의 활용되지 못하고 있었다. 이미지의 “자르기(crop)”, NLP의 “토큰 마스킹(token masking)” 같은 데이터 변형 기법들이 전부 도메인 특화(domain-specific) 라서, 열(column)마다 의미가 제각각인 표 데이터에는 그대로 쓸 수 없기 때문이다.
SCARF는 이 문제를 아주 단순한 아이디어로 해결한다. 입력 특징(feature) 중 일부를 무작위로 골라, 그 값을 “그 열에 실제로 등장했던 다른 값”으로 바꿔치기하는 것이다.
1. 핵심 용어
1.1 Self-supervised learning (자기지도 학습)
Supervised learning(지도 학습) 은 (입력, 정답 라벨) 쌍으로 학습한다. 문제는 label이 있는 데이터는 사람이 일일이 붙여야 하므로 비용이 들고, 양도 적은 경우가 있다. 반면 라벨이 없는 데이터는 세상에 넘쳐난다.
Self-supervised learning은 이 라벨 없는 “데이터 자체로부터 문제를 스스로 만들어” 학습하는 방식이다. “self(스스로) + supervised(지도)”라는 이름 그대로, 정답을 사람이 주는 게 아니라 데이터 구조에서 자동으로 만들어낸다.
- BERT: 문장에서 단어를 일부 가리고 “가려진 단어를 맞혀라”는 문제를 스스로 출제 → 정답은 원래 그 자리에 있던 단어
- SimCLR: 같은 이미지를 두 가지로 변형시킨 후 같은 이미지에서 나왔는지 판단
이렇게 학습하면 “고양이 vs 개” 같은 특정 과제와 무관하게, 입력 데이터의 일반적이고 유용한 표현(representation)자체를 학습하게 된다.
1.2 Pretraining & Fine-tuning (사전학습과 미세조정)
자기지도 학습은 보통 두 단계로 진행된다.
- Pretraining(사전학습): 라벨 없는 대량의 데이터로 위에서 말한 self-supervised 방식으로 인코더(encoder) 를 먼저 훈련시킨다. 이 단계의 목표는 정확한 분류가 아니라 “좋은 표현을 뽑아내는 능력”을 갖추는 것이다.
- Fine-tuning(미세조정): 사전학습된 인코더 위에 분류기(classification head) 를 얹고, 이번엔 라벨이 있는 (적은) 데이터로 실제 과제(예: 분류)에 맞게 전체를 조금 더 학습시킨다.
핵심은 사전학습이 좋은 출발점(초기 가중치)을 만들어주기 때문에, 미세조정 단계에서 라벨이 적어도 높은 성능이 나온다는 것이다. SCARF는 이 전형적인 구도를 따른다.
참고로 SCARF는 미세조정 단계에서 인코더
f까지 전부 다시 학습시킨다. (VIME은 인코더를 얼려두고 분류기만 학습한다는 점이 다르다.)
1.3 Representation & Embedding (표현, 임베딩)
신경망이 입력을 통과시키면서 만들어내는 중간 벡터 표현을 representation 또는 embedding이라고 부른다. 예를 들어 128차원 입력이 인코더를 지나 256차원 벡터가 되었다면, 그 256차원 벡터가 이 입력의 “표현”이다. 좋은 표현이란 비슷한 입력끼리는 가깝고, 다른 입력끼리는 먼 벡터 공간을 만드는 것을 뜻한다.
1.4 View (뷰)
이 논문의 핵심 개념이다. View란 “같은 원본 데이터를 살짝 다르게 변형한 버전” 을 말한다.
- 이미지에서의 view: 같은 사진을 무작위로 자르거나(crop), 색을 왜곡하거나(color distortion), 흐리게(blur) 만든 이미지
- NLP에서의 view: 같은 문장에서 일부 토큰을 마스킹한 데이터
- SCARF에서의 view: 같은 행(row) 데이터에서 일부 특징(feature)을 무작위로 오염시킨 데이터
“같은 원본에서 나온 두 view는 서로 가깝게, 다른 원본에서 나온 view들은 서로 멀게” 만들도록 학습하면, 신경망은 표면적인 변형에 흔들리지 않고 본질적인 표현을 배우게 된다. 즉 view는 어떤 변형에도 불변인(invariant) 특징을 배우도록 하기 위해 사용하는 것이다.
1.5 Contrastive learning (대조 학습)
위에서 설명한 같은 것끼리 가깝게 하고, 다른 것끼리 멀게 만들도록 학습시키는 것을 contrastive(대조) learning이라고 합니다.
- Positive pair(양성 쌍): 같은 원본에서 나온 두 view. → 가깝게 만들어야 함
- Negative pair(음성 쌍): 서로 다른 원본에서 나온 view들. → 멀게 만들어야 함
이를 하나의 수식(손실 함수)으로 표현한 것이 InfoNCE이다.
1.6 InfoNCE
“Information Noise Contrastive Estimation”의 줄임말로, 대조 학습에서 가장 널리 쓰이는 손실 함수(loss function)이다.
이 손실을 최소화하는 것은 두 view가 공유하는 정보의 양, 즉 상호 정보량(mutual information)을 최대화하는 것과 같다. 두 view의 공유 정보란 “오염에도 살아남은 본질적인 정보”이므로, 이를 최대화한다는 건 노이즈에 흔들리지 않고 데이터의 핵심을 담는 표현을 학습한다는 뜻이다. (손실 ↓ = 상호 정보량 ↑)
수식을 뜯어보면 사실 “소프트맥스 분류(softmax classification)” 와 똑같은 구조이다. SCARF의 손실 수식은 다음과 같다.
\[\mathcal{L} = -\frac{1}{N} \sum_{i=1}^{N} \log \frac{\exp\!\left(s_{i,i}/\tau\right)} {\dfrac{1}{N}\displaystyle\sum_{k=1}^{N} \exp\!\left(s_{i,k}/\tau\right)}\]배치(batch) 안에 N개의 원본이 있고, 각 원본 i마다 원본 view $z^{(i)}$ 와 오염된 view $\tilde{z}^{(j)}$ 두 개가 있다고 하면,
- $s_{i,j}$ : $z^{(i)}$ 와 오염 view $\tilde{z}^{(j)}$ 사이의 코사인 유사도이다. 두 벡터를 각자 길이로 나눠 정규화한 뒤 내적한 값으로, 방향이 얼마나 비슷한지를 -1 ~ 1로 나타낸다.
- $s_{i,k}$ 에서 i=k인 경우 같은 원본에서 나온 positive pair의 유사도이므로 최대화 해야하는 값이고, k≠i인 경우 다른 원본과의 negative pair 유사도이므로 최소화하도록 한다.
τ(temperature, 온도): 표현의 스케일을 조절하는 값이다. 작을수록 가장 큰 유사도에 극단적으로 집중하고, 클수록 완만해진다. SCARF는 기본값으로τ = 1을 사용(즉 그냥 순수 소프트맥스).
분자 $\exp\left(s_{i,i}/\tau\right)$ 는 positive pair의 유사도 점수이고, 분모는 이를 포함하여 배치 전체 view와의 유사도 점수를 총합한 것이다. (분모에서 i는 고정이고 k만 변함)
이 분수는 “배치 안의 N개의 후보 중에서 자신의 진짜 짝(positive)을 골라낼 확률이다. 이 확률을 1에 가깝게 하는 것이 목표이므로, 즉 -log 값을 0에 가깝게 최소화하는 것이 학습 목표이다.(진짜 짝과의 유사도(s_ii)를 키우고 나머지(s_ik)를 줄이도록)
배치사이즈가 N이면 문제는 “1개의 positive와 N−1개의 negative 중 고르기”가 되는데, 배치가 클수록 negative가 많아져 문제가 어려워지고, 보통 어려운 문제가 표현을 더 잘 학습시킨다. (다만 뒤에서 보듯 SCARF는 배치 크기에 크게 민감하지 않다.)
1.7 Empirical marginal distribution (경험적 주변 분포)
- Marginal distribution(주변 분포): 여러 변수 중 딱 하나의 변수만 떼어놓고 본 값의 분포이다. 표 데이터로 치면 “특정 한 열(column)”에 있는 값들의 분포.
- Empirical(경험적): 이론적 수식이 아니라 실제 데이터에 등장한 값들로 만든 분포라는 뜻.
즉 어떤 열의 empirical marginal distribution이란 “학습 데이터에서 그 열이 실제로 가졌던 값들의 집합” 이고, 등장한 빈도를 그대로 반영한 분포이다. SCARF는 여기서 균등하게(uniformly) 하나를 뽑아 오염에 사용한다.
“uniform”은 “N개의 행을 각각 1/N 확률로 똑같이 뽑는다” 는 뜻이지, “회사원·학생·자영업·무직 네 종류가 나왔을때 각각을 1/4로 뽑는다”는 뜻이 아니다. 등장한 빈도를 반영하여 뽑는다.
2. SCARF의 원리
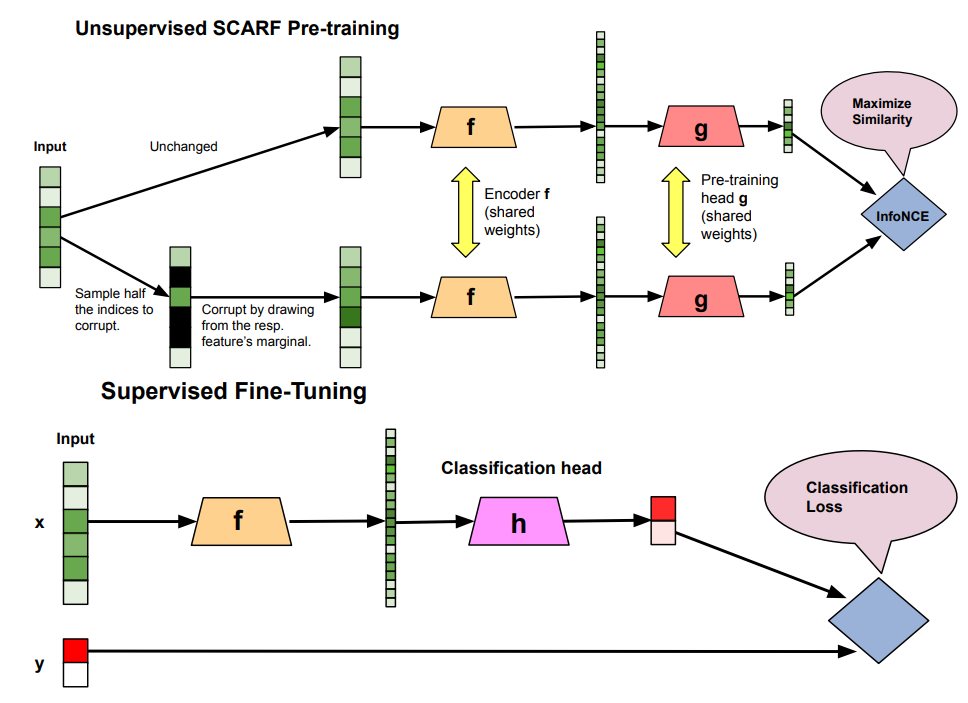
SCARF는 네트워크를 3가지로 분해하며 각각 256 은닉차원을 가지는 ReLU 네트워크이다. $f$는 4 layers, 나머지 $g$와 $h$는 2 layers이다.
- $f$(encoder): 입력에서 표현을 뽑는 본체. 최종적으로 우리가 재사용하고 싶은 건 오직 이 인코더 $f$이다.
- $g$(pre-train head): 대조 학습 전용 보조 신경망. 출력을 L2 정규화하여 벡터들이 반지름 1인 초구(unit hypersphere) 위에 놓이게 만든다. 이 정규화가 실무적으로 매우 중요하다고 알려져 있다. 사전학습이 끝나면 $g$는 버려진다.
- $h$(classification head): 미세조정 단계에서 $f$의 출력을 받아 레이블을 예측하는 분류기.
view를 어떻게 만드는가
미니배치의 각 샘플 $x^{(i)}$ 에 대해:
- 오염할 특징 개수 결정. 전체 특징 수가 $M$ 이고 오염률(corruption rate) $c$ 가 $0.6$ 이면, $q = \lfloor c \cdot M \rfloor$ 개, 즉 약 60%의 특징을 오염시키기로 설정.
- 오염할 위치 무작위 선택. ${1, \dots, M}$ 에서 크기 $q$ 인 부분집합 $I_i$ 를 균등 무작위로 뽑는다. 샘플마다, 매 스텝마다 다른 위치를 뽑는다.
- 선택된 특징을 오염. 오염 대상으로 뽑힌 위치 $j$ 의 값은, 그 열 $j$ 의 empirical marginal distribution $\hat{X}_{c_j}$ 에서 새로 뽑은 값 $v$ 로 교체한다. 뽑히지 않은 위치는 원본 값 그대로 유지.
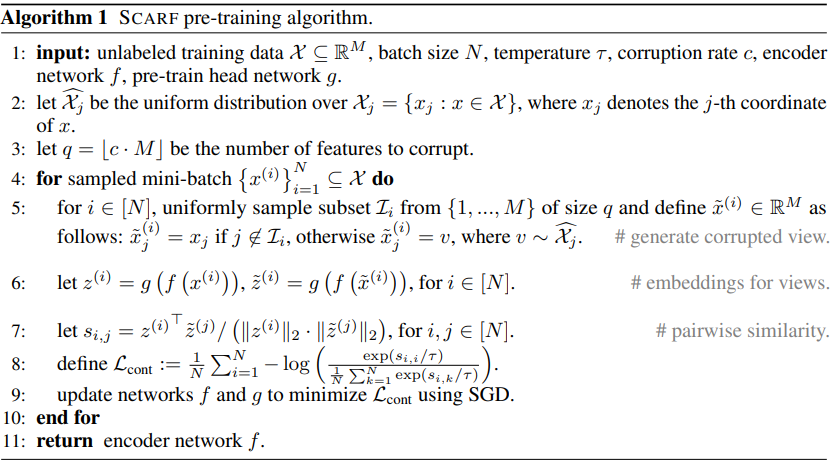
구체적인 예시로, 한 사람의 데이터가 이렇게 있다.
| 나이 | 소득 | 직업 | 지역 | 자녀수 |
|---|---|---|---|---|
| 34 | 5200 | 회사원 | 서울 | 2 |
여기서 ‘소득’과 ‘직업’이 오염 대상으로 뽑혔다면, 각 열이 데이터셋에서 실제로 가졌던 값 중 무작위로 하나씩 뽑아 교체한다.
| 나이 | 소득 | 직업 | 지역 | 자녀수 |
|---|---|---|---|---|
| 34 | 서울 | 2 |
이렇게 만들어진 오염본이 바로 원본의 view이고, (원본, 오염본)이 하나의 positive pair가 된다.
이렇게 “그 열의 실제 값으로” 교체 하면 원래 그 열의 “단위”와 분포를 그대로 유지하여 좋다. 따로 하이퍼파라미터를 만들 필요도 없고, 특징 스케일링 방식(z-score, min-max 등)에 불변(invariant) 하다.
손실 계산과 최적화
앞서 만든 두 view를 각각 $f \to g$ 에 통과시켜 임베딩 $z^{(i)}$, $\tilde{z}^{(i)}$ 를 얻고, InfoNCE loss를 계산한다. 여기서 $z^{(i)} = g\bigl(f(x^{(i)})\bigr)$, $\tilde{z}^{(i)} = g\bigl(f(\tilde{x}^{(i)})\bigr)$ 이다.
- 모든 $i$ 에 대해 $z^{(i)}$ 와 $\tilde{z}^{(i)}$ (같은 원본) → 가깝게, 즉 $s_{i,i}$ 를 크게
- $i \neq j$ 인 $z^{(i)}$ 와 $\tilde{z}^{(j)}$ (다른 원본) → 멀게, 즉 $s_{i,j}$ 를 작게
$f$, $g$ 의 파라미터는 경사하강(SGD) 방식으로 갱신한다. 실제 모든 실험에서 사용한 구체적인 옵티마이저는 Adam(학습률 $0.001$, 배치 크기 $128$)이다.
사전학습을 몇 epoch 돌려야 하는지는 데이터셋마다 다르기에, 검증 데이터에 대한 InfoNCE loss를 이용해 early stopping을 할 수도 있다. 라벨 없는 검증 데이터로 $(x^{(i)}, \tilde{x}^{(i)})$ 쌍을 미리 한 번 만들어 고정된 정적 검증셋을 만들고, 학습 내내 이 검증 셋의 손실을 추적한다.
학습 손실 곡선은 매 스텝 무작위 오염 때문에 noisy 하지만, 검증 손실 곡선은 검증셋을 한 번 만들어 고정하므로 매끄럽다. 또 조기 종료 기준으로 InfoNCE “손실”을 쓰는 게 InfoNCE “에러(오분류율)”를 쓰는 것보다 성능이 좋았다.
3. 실험
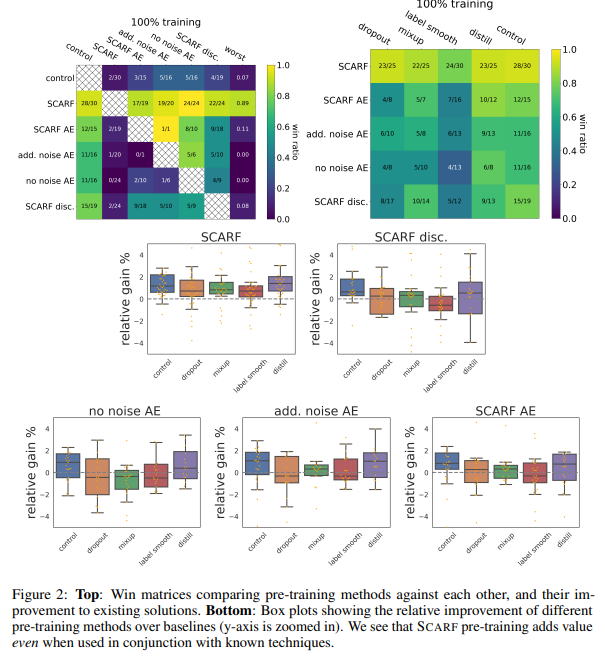
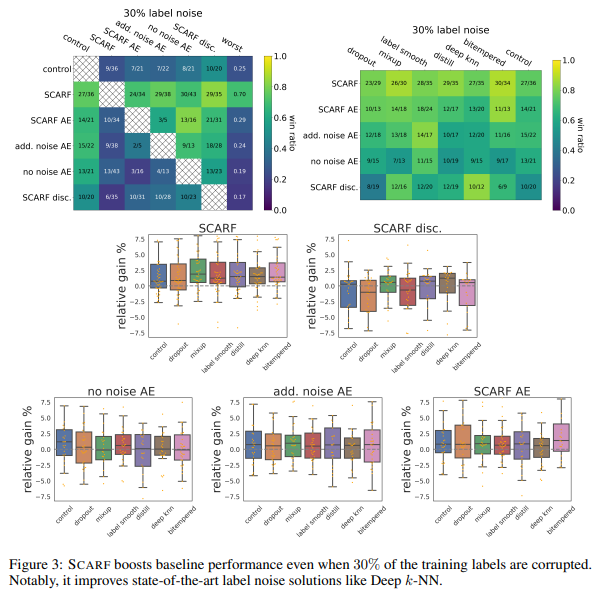
데이터셋: OpenML-CC18 벤치마크의 실제 분류 데이터셋 69개(원래 72개에서 이미지 데이터인 MNIST, Fashion-MNIST, CIFAR-10 제외). 각 데이터셋을 70%/10%/20%로 train/validation/test 분할하고, 30번씩 반복 실험.
세 가지 시나리오에서 사전학습이 테스트 정확도를 얼마나 올리는지 측정하였다.
- 전체 라벨(fully-supervised): 라벨을 100% 사용.
- 준지도(semi-supervised): 라벨을 25%만 주고 나머지 75%는 라벨 없이.
- 라벨 노이즈(label noise): 학습 라벨의 30%를 무작위 클래스로 오염.
세 상황 모두에서 SCARF가 도움이 되었다.
- 먼저 라벨이 완벽하게 다 주어진 상황에서 SCARF는 기존 기법들(mixup·label smoothing·dropout·distillation) 위에 얹었을 때 약 1~2%의 상대적 향상을 더했다.
- 라벨이 25%뿐인 준지도 상황에서 효과가 가장 극적이었으며, 다른 준지도 전용 기법 위에서도 2~4% 향상되었다.
- 라벨의 30%가 무작위로 틀어진 노이즈 상황에서는 향상 폭이 2~3%.
핵심은 “SCARF가 기존 기법을 대체하는 게 아니라 보완한다(complements)” 는 사실이다. 만약 SCARF가 mixup이나 dropout과 똑같은 원리로 작동한다면, 이미 그 기법들을 쓰고 있는 모델에 SCARF를 더 얹어봐야 효과가 겹쳐서 추가 이득이 없을텐데, 잘 튜닝된 기법들 위에 얹어도 여전히 성능이 오른다는 건 그것들과 다른 메커니즘, 데이터 구조에서 표현을 학습하는 방식으로 작동한다는 증거이다. 실용적으로, 지금 쓰는 파이프라인을 갈아엎지 않고 위에 한 겹만 더 얹으면 된다는 뜻이라 매력적이다.
저자들이 언급한 한계: 입력 데이터에 존재하는 편향(bias)을 표현이 그대로 학습·강화할 수 있으며, 이를 완화하는 방법은 향후 과제로 남김
비교에 사용된 주요 baseline들
| 종류 | 방법 |
|---|---|
| 범용(정확도·노이즈·distill) | Label smoothing, Dropout, Mixup, Self-distillation |
| 사전학습(핵심 비교군) | Autoencoder 3종(no-noise / additive-noise / SCARF-corruption AE), Discriminative SCARF |
| 라벨 노이즈 전용 | Deep k-NN, Bi-tempered loss |
| 준지도 전용 | Self-training, Tri-training |
| 실무 참고 | XGBoost (부록의 절대 정확도 비교) |
4. Ablation Study
논문은 SCARF의 각 설계 선택이 정말 필요한지 꼼꼼히 실험하였다. (Ablation은 “구성 요소를 하나씩 제거/변경해 그 기여도를 측정하는” 실험을 말함)
-
Marginal 샘플링이 다른 오염 방식보다 우수하다: 다른 대안(오염 없음, 평균값으로 교체, 노이즈 추가, joint(행 전체를 다른 샘플에서 통째로 가져오기), 0으로 만들기(feature dropout))보다 SCARF의 marginal 방식이 여러 스케일링 하에서 가장 견고했음.
-
배치 크기에 둔감하다: SimCLR 등은 배치를 5000까지 키워야 좋아지지만, SCARF는 128을 넘겨도 유의미한 개선이 없었다. 대규모 배치를 위한 엔지니어링 부담이 적다.
-
오염률
c는 50~80% 구간에서 성능이 안정적이라 기본값 0.6을 권장함. 온도τ도 마찬가지로 안정적이며 기본값 1(순수 소프트맥스)을 권장. -
오염 세부 튜닝: 부록에 따르면 인코더에 들어가는 두 view를 모두 오염시키는 것보다 한쪽 view만 오염시키는 게 낫고(양쪽을 60%씩 오염하면 두 view가 공유하는 정보가 너무 적어 문제가 지나치게 어려워짐), 배치 내 샘플마다 다른 위치를 오염시키는 게 같은 위치를 쓰는 것보다 낫다.