hemisus

1. Components of CNNs
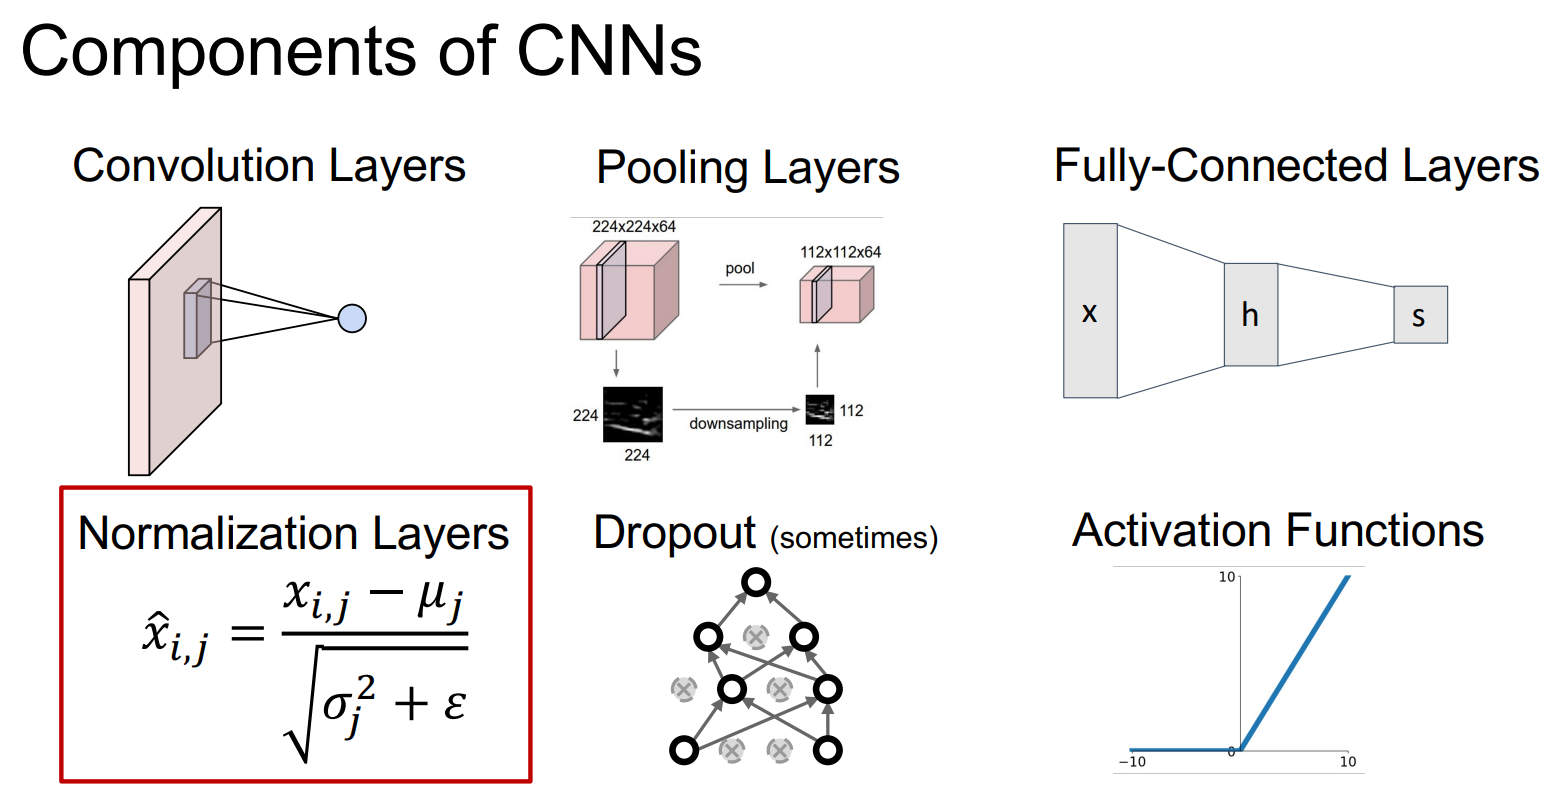
이전 강의에서 CNN의 핵심인 Convolution Layer와, Pooling Layer에 대해 살펴보았었다. 이외에도 CNN을 이루는 몇가지 Layer들을 소개한다.
Normalization Layer
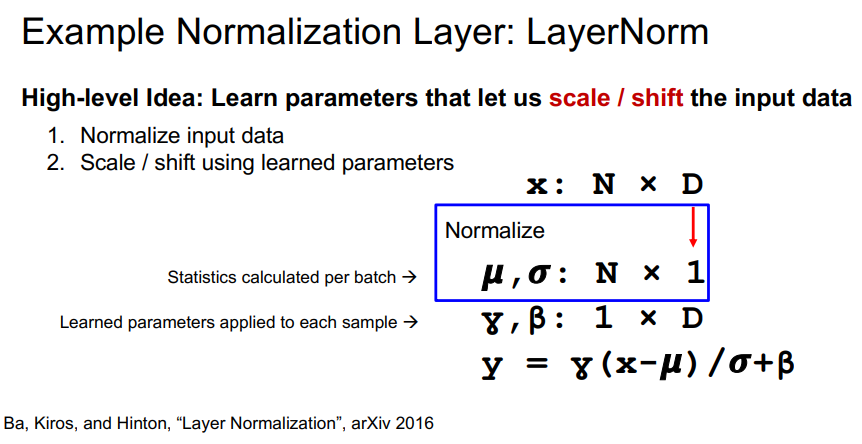
Normalization Layer(정규화 계층)은 Input data의 값 분포를 최적의 분포(Optimal Distribution)로 정규화하기 위해 학습하는 계층이다. 기본적으로 표준정규화를 통해 $N(0, 1)$의 분포를 따르게 만든 후 학습한 파라미터에 따라 Scale/Shift를 진행한다.
이렇게 정규화를 하면 다음과 같은 효과를 얻을 수 있다:
- 최적화가 안정화된다: 각 레이어로 들어가는 입력의 분포가 일정하게 유지되어 Loss의 변동도 안정됨. 학습 과정이 훨씬 안정적으로 진행된다.
- 더 큰 Learning Rate를 사용할 수 있다: 그래디언트의 스케일이 안정적으로 유지되어, 정규화 없이는 발산했을 큰 학습률로도 수렴할 수 있다.
- 그래디언트 소실/폭주가 완화된다: 데이터 분포가 활성화 함수의 saturating 구간(예: sigmoid, tanh의 양 끝)으로 치우치는 것을 막아, 역전파 시 그래디언트가 안정적으로 전달된다.
- 약한 규제(regularization) 효과가 있다: 특히 BatchNorm처럼 미니배치 단위로 통계를 구하는 경우, 배치마다 통계값이 조금씩 달라지는 노이즈가 더해져 일종의 regularization처럼 작동.
대부분의 정규화 계층은 이 표준정규화 방식을 사용하며, 각 종류별 차이점은 이 data를 정규화할 통계적 수치를 구하는 방식이다. 해당 강의에서는 LayerNorm이 대표적으로 소개되었다.
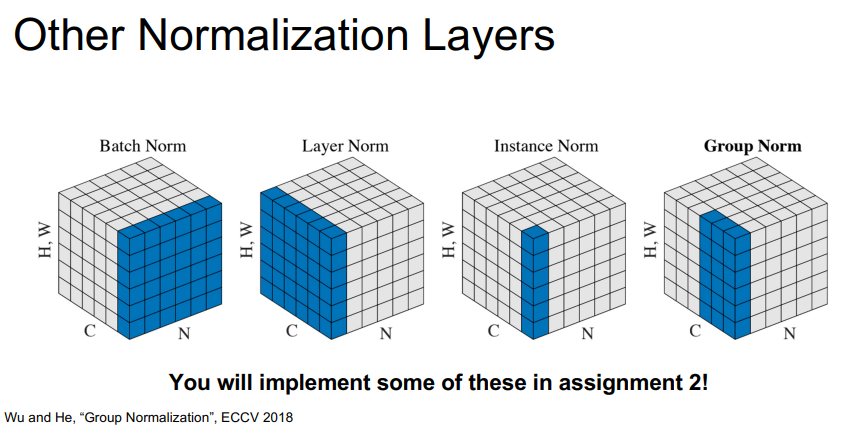
정육면체에서 세 축은 각각 batch($N$), channel($C$), spatial($H, W$)을 의미하고, 색칠된 영역이 하나의 평균/분산을 공유하는 단위다. 즉 정규화 종류별 차이는 “이 색칠 영역을 어떻게 잡느냐”의 차이다.
Batch Norm
각 채널마다 배치 전체와 공간 차원 $(N, H, W)$에 걸쳐 통계를 계산한다. 정육면체로 보면 채널 축의 한 칸을 고정하고 N · H,W 방향으로 펼쳐진 영역이 하나의 정규화 단위가 된다.
- 배치 통계에 의존하므로 배치 크기에 민감하다. 배치가 작으면 통계가 불안정해져 성능이 떨어진다.
- 학습과 추론의 동작이 다르다. 학습 중에는 미니배치 통계를 사용하면서 running mean/variance를 EMA로 누적하고, 추론 시에는 이 누적값을 사용한다.
- CNN에서 표준적으로 사용된다.
:: EMA(Exponential Moving Average - 지수이동평균)
\[\mu_{\text{running}} \leftarrow \alpha \cdot \mu_{\text{running}} + (1-\alpha)\cdot \mu_B\] \[\sigma_{\text{running}}^2 \leftarrow \alpha \cdot \sigma_{\text{running}}^2 + (1-\alpha)\cdot \sigma_B^2\]Layer Norm
각 샘플마다 채널과 공간 차원 $(C, H, W)$ 전체에 걸쳐 통계를 계산한다. 배치 방향으로는 전혀 섞이지 않으므로 배치 크기에 독립적이고, 학습·추론 동작이 동일하다.
- 배치 통계를 쓰지 않아 배치가 작거나 1이어도 잘 동작한다.
- RNN, Transformer처럼 시퀀스 길이가 가변적이고 배치 의존성을 피하고 싶은 구조에서 주로 사용된다.
Instance Norm
각 샘플의 각 채널마다 공간 차원 $(H, W)$에 대해서만 통계를 계산한다.
Group Norm
채널을 $G$개의 그룹으로 나눈 뒤, 각 샘플의 그룹마다 (그룹 내 채널들 + 공간)에 걸쳐 통계를 계산한다.
- $G=1$이면 LayerNorm, $G=C$(채널 수)이면 InstanceNorm과 같아지는, 둘 사이를 일반화한 형태다.
Regularization: Dropout
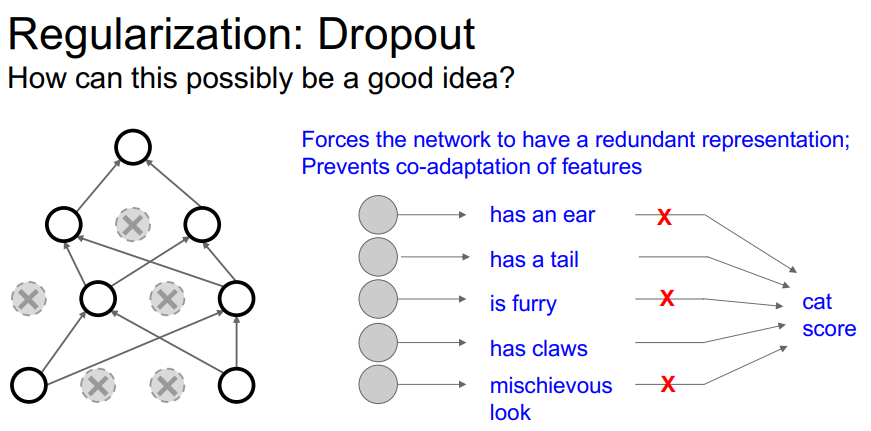
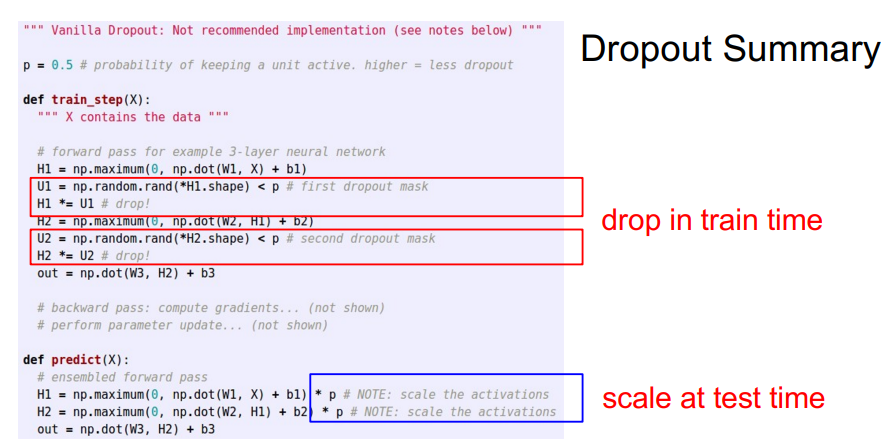
각 순전파(forward pass)마다 레이어의 뉴런 출력(활성값) 일부를 랜덤하게 0으로 만든다. 각 뉴런을 비활성화할 확률 $p$는 하이퍼파라미터이며, 보통 0.5 정도를 사용한다.
만약 특정 뉴런들이 항상 함께 켜져 어떤 특징을 “분담”해서 학습하면, 그 조합에 과하게 의존하게 된다. 랜덤하게 뉴런을 꺼버리면 어떤 뉴런이 사라질지 모르므로, 각 뉴런은 서로 의존하지 않고 그 자체로 유용한 특징을 중복해서 학습할 수 있다.
추론 시에는 뉴런을 끄지 않고 전부 사용한다. 그런데 학습 때는 평균적으로 $(1-p)$ 비율의 뉴런만 켜져 있었는데, 추론 때는 전부 켜지므로 다음 레이어로 들어가는 입력의 기댓값(스케일)이 학습 때보다 커진다.
이 차이를 맞춰주기 위해 스케일을 보정하는 과정이 필요하다.
Activation Functions
각 층의 출력에 비선형성을 추가해주는 역할을 하며, 일반적으로 신경망은 선형 층과 활성화 함수를 번갈아 쌓는 구조로 이루어진다.
Sigmoid
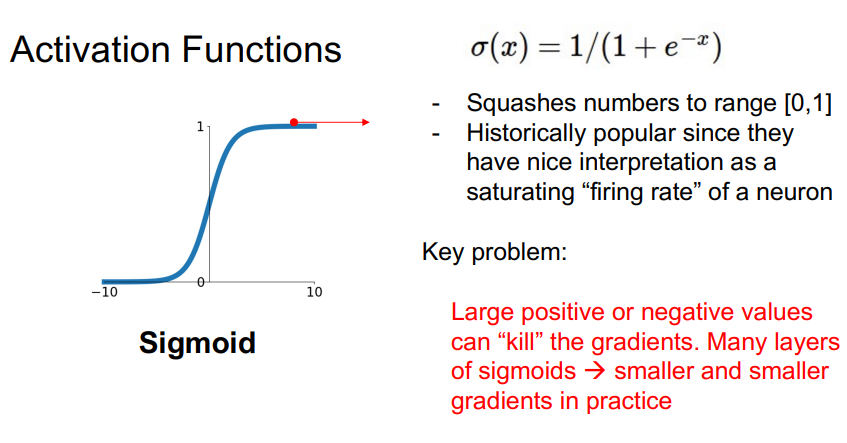
입력값을 $[0,1]$ 범위의 값으로 압축한다. 이전에는 인기가 많았으나 양 끝쪽의 gradient가 0에 가까워 중첩되어 사용될 경우 역전파에서 기울기가 소실되는 Vanishing Gradient문제로 인해 오늘날 잘 사용되지 않음. 다만 출력을 확률처럼 $[0, 1]$로 해석할 수 있어, 이진 분류의 마지막 출력층으로는 여전히 사용된다.
ReLU
$f(x) = max(0,x)$ 로 표현되어 굉장히 계산이 단순하고 양수 범위에서는 기울기 소실 문제가 완화되었다. 실제로 sigmoid/tanh보다 수렴도 빠르다.
다만 $X<0$의 음수에서 기울기가 죽는 Dead Cell이 되어 버리는 점과, 출력에 음수가 없어, sigmoid와 마찬가지로 zero-centered가 아니다.
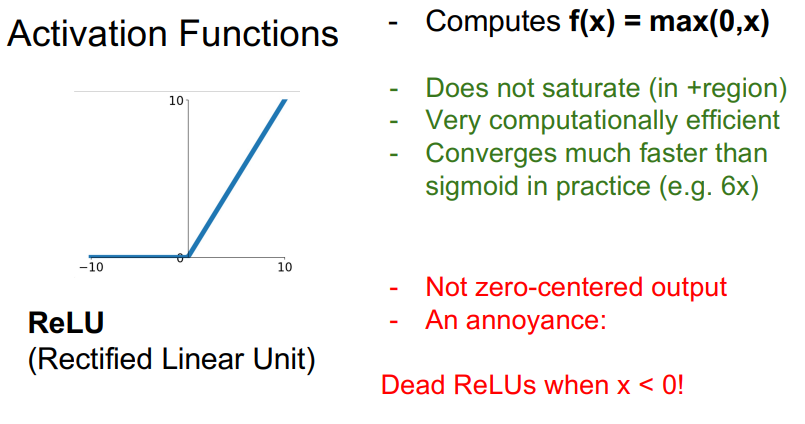
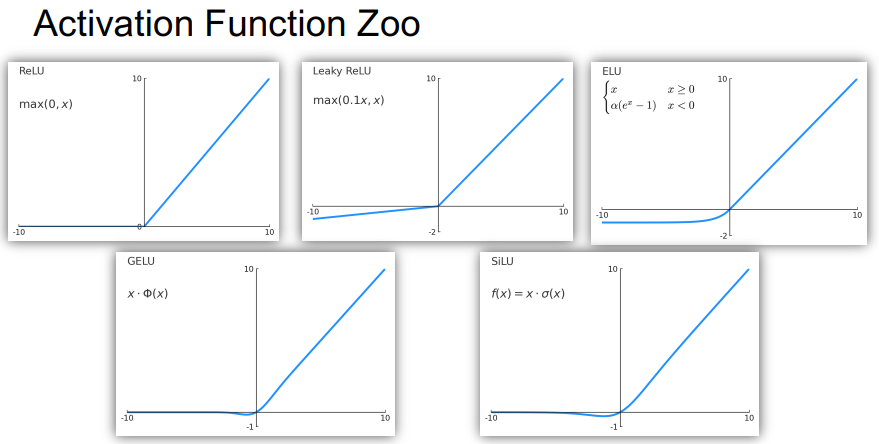
이러한 단점을 완화한 변형으로 음수 구간에 작은 기울기를 부여하는 Leaky ReLU, Transformer 계열에서 표준적으로 쓰이는 GELU 등이 있으며, 그래도 대부분의 경우 기본 ReLU로 충분하다.
2. CNN Architectures
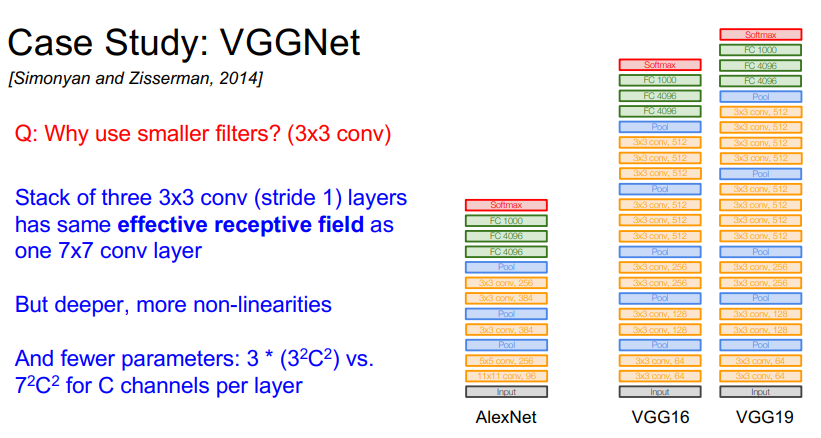
VGGNet, ResNet 등 대표적인 CNN 구조들이 간략히 소개되었다. 이 글에서는 7x7 conv 한 번 대신 3x3 conv를 세 번 쌓는 것이 더 효율적이라는 점만 짚고 넘어간다. (둘은 동일한 receptive field를 갖지만, 3x3을 쌓는 쪽이 파라미터 수는 더 적고 비선형성(ReLU)이 더 많이 들어간다.)
ResNet에 대한 내용은 다른 글에서 이미 다루었다: ResNet 포스트
3. Build and Train CNNs
모델을 성공적으로 학습시키기 위한 다양한 전략을 소개한다.
Weight Initialization
가중치의 초기값은 학습 과정에서 굉장히 중요한 요소이다. 학습이 시작될 때 각 층을 거친 활성값(activation)의 분포가 어떻게 변하는지를 좌우하기 때문이다.
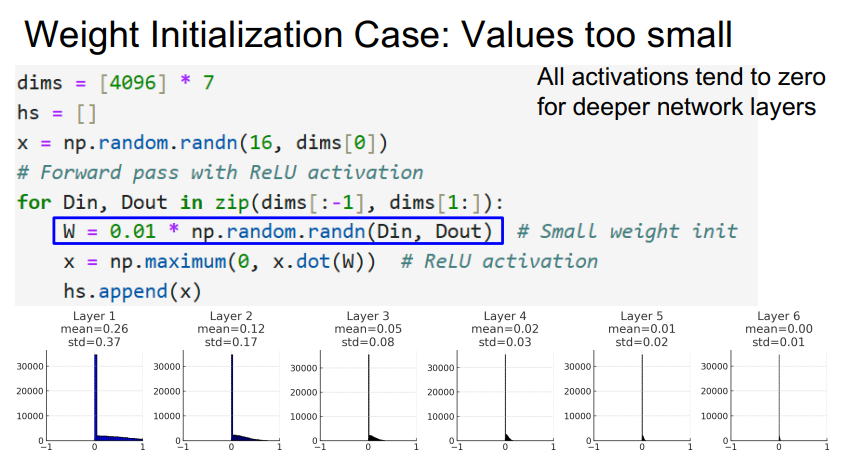
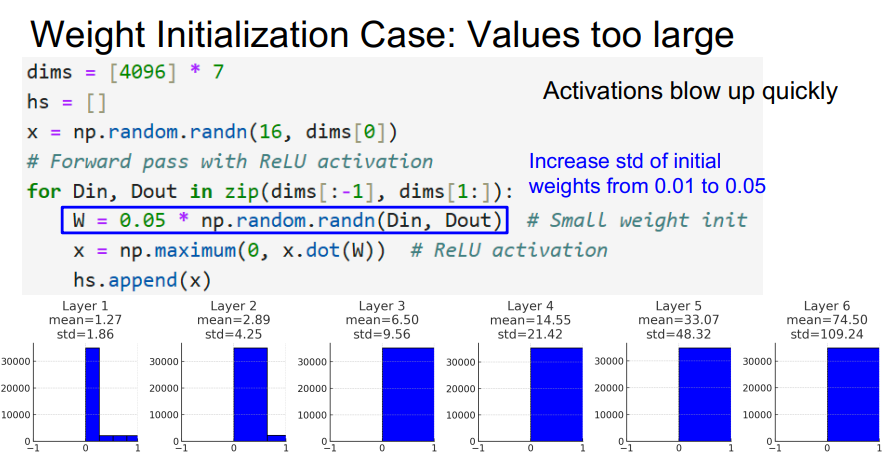
먼저, 모든 가중치를 0이나 동일한 값으로 초기화하면 안 된다. 모든 뉴런이 완전히 똑같은 출력과 똑같은 gradient를 갖게 되어 학습 내내 같은 값으로만 업데이트되기 때문이다. 그래서 가중치는 랜덤하게 초기화하되, 스케일을 잘 잡아야 한다.
- 너무 작으면: 층을 거칠수록 활성값이 점점 줄어 0으로 수렴한다. 활성값이 0이면 그에 의존하는 gradient도 0이 되어, 깊은 층일수록 학습이 되지 않는다.
- 너무 크면: 활성값이 점점 커지며, sigmoid·tanh 같은 함수는 양 끝 구간으로 몰려 gradient가 소실되고, 그렇지 않은 경우엔 값이 발산하며 Gradient Exploding이 일어난다.
Xavier Initialization
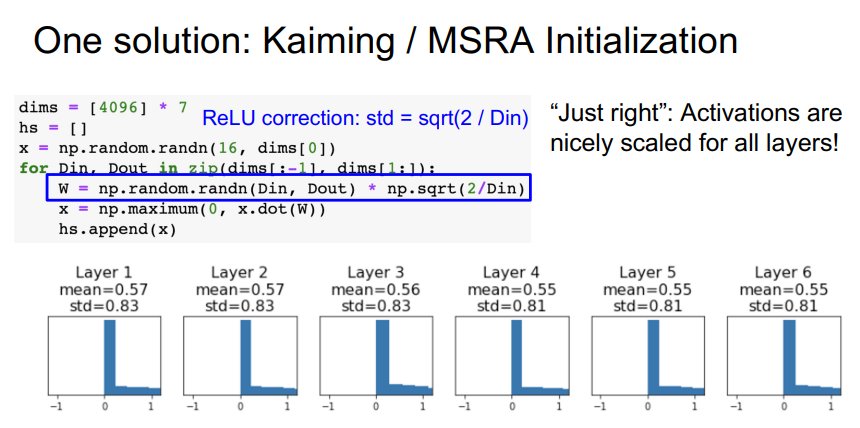
층의 입력 차원 $D_{in}$을 이용해 가중치의 분산을 $\frac{1}{D_{in}}$로 맞추는 방식이다. 즉 표준정규분포에서 뽑은 값에 $\sqrt{\frac{1}{D_{in}}}$를 곱한다. 입력 뉴런이 많을수록 가중치를 작게 만든다.
Kaiming Initialization
위 방식을 ReLU에 맞춰 보정한 방식이다. ReLU는 입력의 음수 절반을 0으로 죽여버리므로 출력의 분산이 대략 절반으로 줄어드는데, 이 손실을 보상하기 위해 분산에 2를 곱한 $\frac{2}{D_{in}}$을 사용하여 스케일한다. ReLU 계열을 쓰는 현대 CNN에서 표준적으로 사용된다.
Data Preprocessing
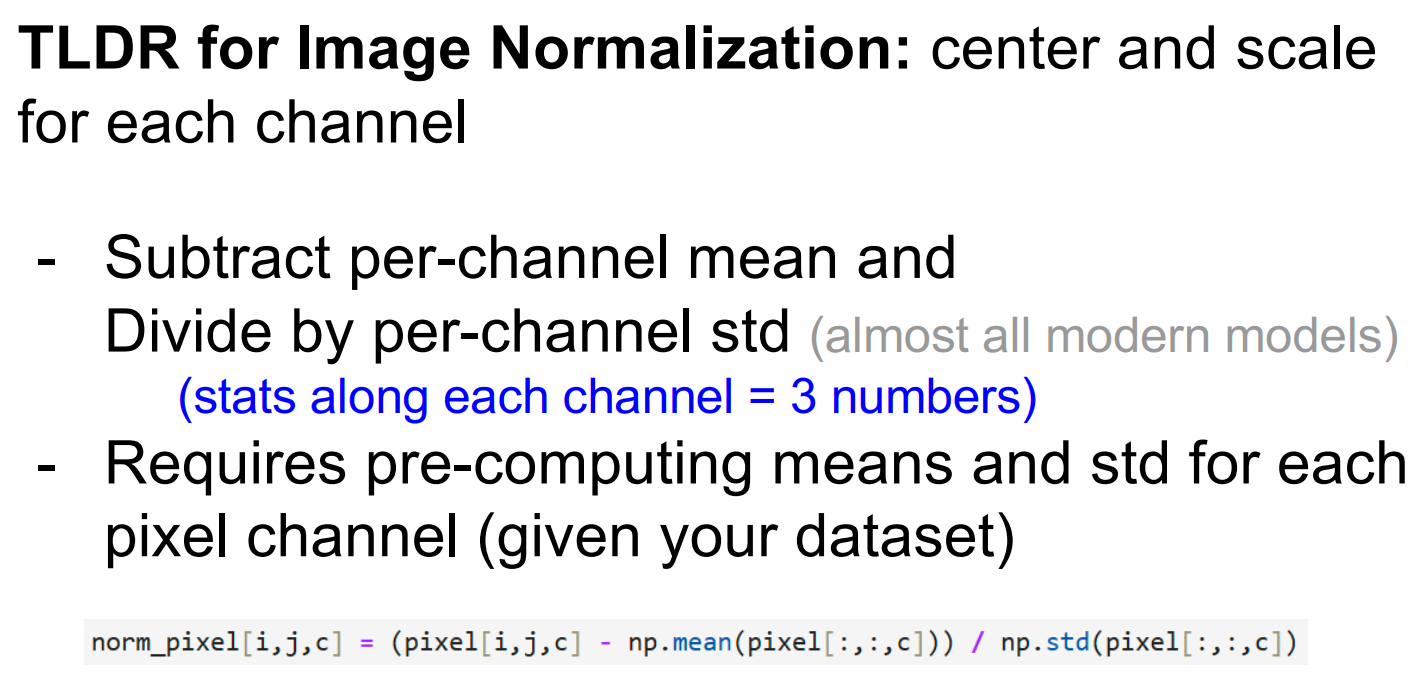
학습 데이터 전체에서 구한 채널별 평균과 표준편차를 이용해, 입력 이미지를 평균 0, 표준편차 1에 가깝게 정규화하는 것이 일반적이다. 데이터를 zero-centered하게 만들어두면 학습 초기의 최적화가 안정적으로 진행된다. 이때 사용한 통계값(평균·표준편차)은 검증·테스트 데이터에도 동일하게 적용한다.
Data augmentation
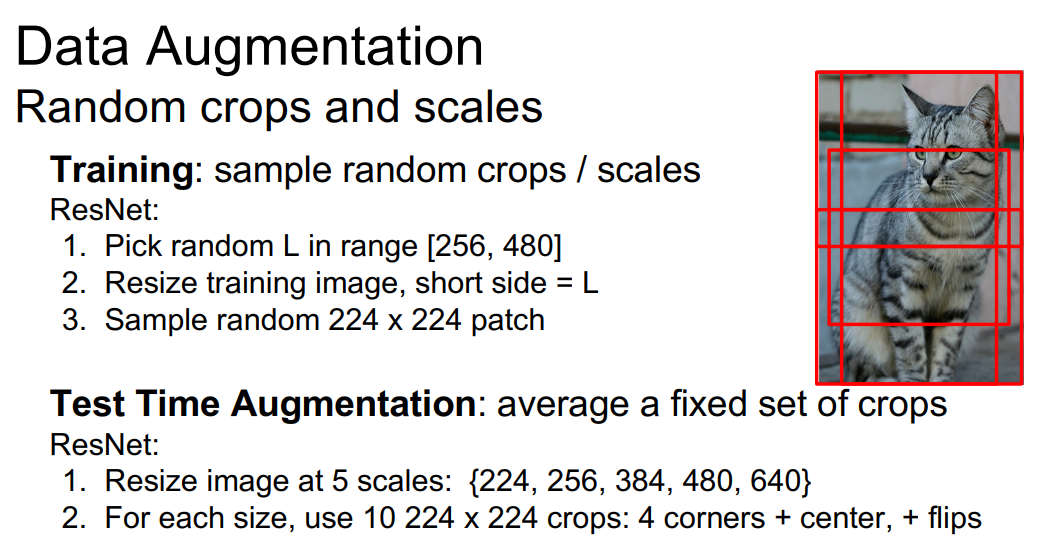
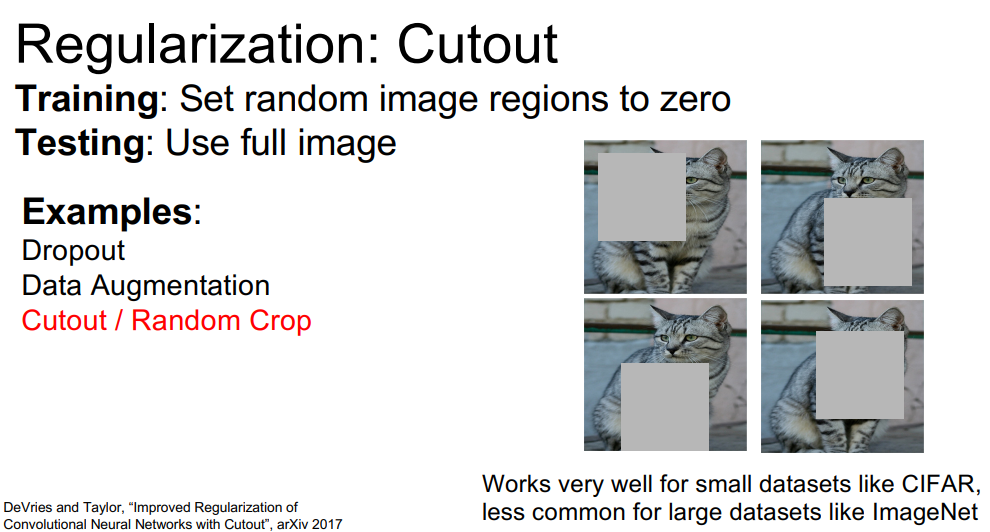
데이터 증강이라 불리며, 훈련 데이터를 변형하여 데이터의 크기와 다양성을 늘리는 기법이다. 좌우 반전, 크기 조절, 색상 변형, 일부 자르기(crop) 등으로 데이터를 변형시켜 학습시킨다. 모델이 이런 변형에 불변(invariant)하도록 유도해 일반화 성능을 높이는 효과를 갖는다. 변형은 훈련 시에만 적용한다.
Transfer Learning
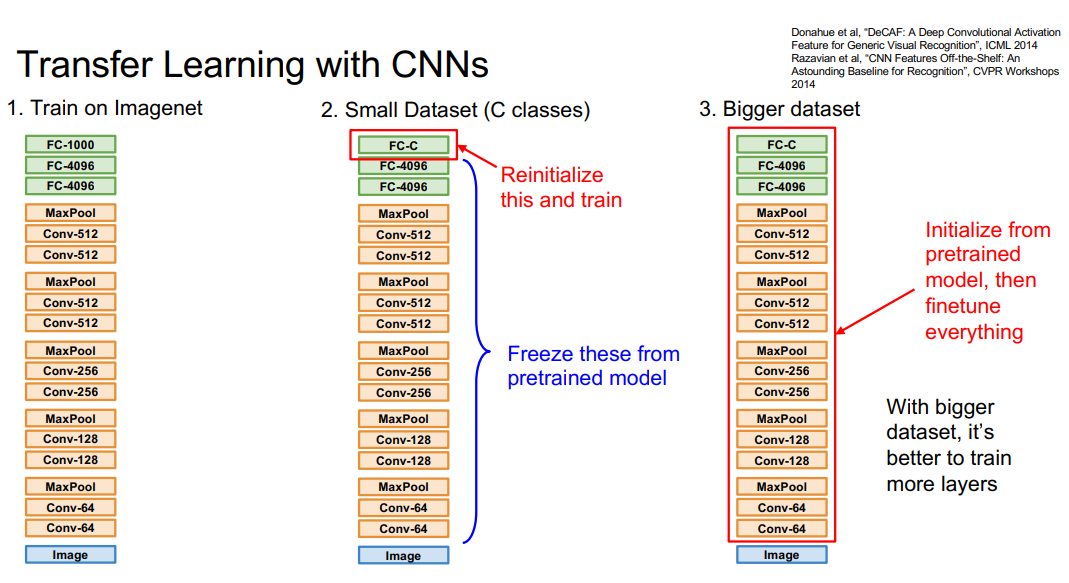
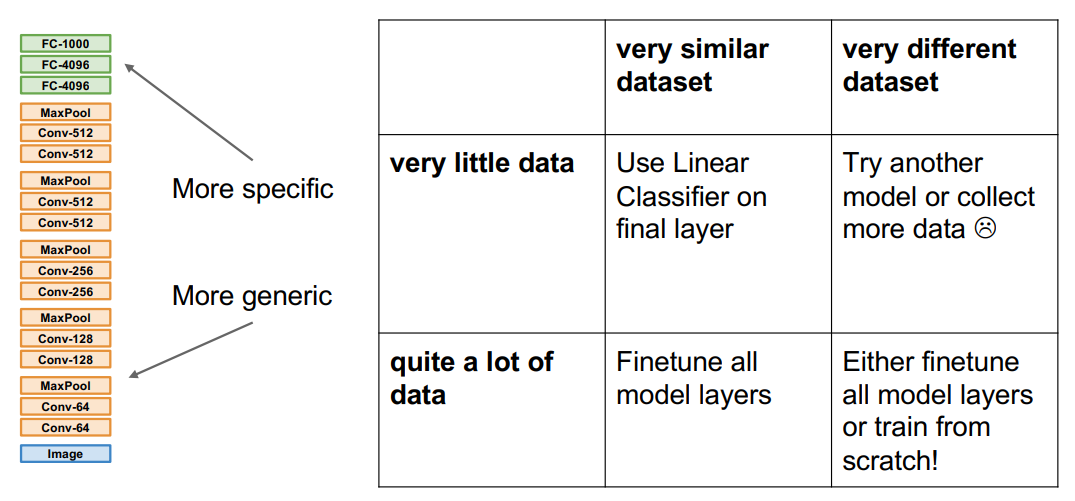
학습시키려는 데이터가 너무 적거나 컴퓨팅 자원이 충분하지 않을 때, 사전 훈련된(pre-trained) 모델을 활용하는 방법이다. 보통 CNN모델의 앞쪽 레이어는 edge·texture 같은 범용적인 특징을 학습하므로 다른 task에도 그대로 재사용할 수 있다는 점을 이용한다.
- Feature Extractor: 기존 모델의 CNN 레이어들은 동결(freeze)하고, 분류층만 새 데이터에 맞게 훈련한다. 데이터가 매우 적을 때 적합하다.
- Fine-Tuning: 분류층뿐 아니라 기존 CNN 레이어의 일부(또는 전체)도 함께 학습시킨다. 데이터가 어느 정도 확보됐을 때 사용하며, 보통 사전 학습된 가중치가 망가지지 않도록 작은 learning rate로 학습한다.