 hemisus

논문 정보
- 제목: VIME: Extending the Success of Self- and Semi-supervised Learning to Tabular Domain
- 링크: NeurIPS 2020
이미지·자연어에서 자기지도(self-supervised)·준지도(semi-supervised) 학습은 적은 라벨로도 뛰어난 성능을 내는 핵심 기술이 되었다. 하지만 이 기법들은 이미지의 공간적 구조(spatial structure)나 언어의 의미적 구조(semantic structure)에 강하게 의존하며, 이러한 과제는 표 형태의 정형 데이터(tabular data)에는 그대로 옮길 수 없다.
VIME(Value Imputation and Mask Estimation, 값 대체 및 마스크 추정)은 이 차이를 메우기 위해, tabular 데이터에 맞는 새로운 자기지도 과제와 새로운 준지도 데이터 증강법을 함께 제안한다.
1. 핵심 용어
1.1 Semi-supervised learning (준지도 학습)
지도 학습과 자기지도 학습의 중간에 있는 방식이다.
지도 학습은 라벨링이 되어 있는 데이터를 사용하는데, 보통 이러한 데이터의 양은 매우 적다. 이렇게 적은 데이터뿐이면 모델이 그 소수 샘플에 overfit되기 쉽다. 준지도 학습은 여기에 라벨 없는 대량의 데이터까지 함께 활용해서 이 문제를 완화한다.
핵심 직관은 “라벨은 없어도, 입력 데이터 $x$의 분포 자체가 정보를 준다”는 것이다. 준지도 학습은 크게 두 갈래로 볼 수 있다.
- Entropy minimization(엔트로피 최소화): 라벨이 없는 데이터에 대해 모델이 자신 있게(예측하는 p가 클수록 엔트로피가 줄어듦) 예측하도록 유도.
- Consistency regularization(일관성 정칙화): “데이터에 변형을 가해서 새로운 input을 만들었을 때에도 예측 결과는 그대로여야 한다”는 가정을 바탕으로 모델을 regularize하는 방법
VIME의 뒷쪽 부분이 준지도 학습이며, 이때 앞쪽에서 학습한 인코더를 재사용한다.
1.2 Pretext task (사전 과제) & Downstream task
자기지도 학습에서 “진짜 풀고 싶은 과제 대신, 표현을 학습시키려고 일부러 만들어 푸는 과제”이다. 말 그대로 표현 학습을 위한 “구실용 과제”이다.
- 이미지의 pretext task 예: 회전 각도 맞히기, 직소 퍼즐 맞추기, 흑백 이미지에 색 입히기
- 언어의 pretext task 예(BERT): 가려진 단어 맞히기, 다음 문장 예측
이 과제들의 정답은 데이터에서 생성된 것이므로 내재되어 있다. 중요한 건 이 가짜 과제를 잘 풀려면 데이터의 본질을 이해해야 하도록 설계하는 것으로, 그 과정에서 인코더가 쓸모 있는 표현을 배우게 된다. VIME의 핵심 기여가 바로 tabular데이터에 맞는 새로운 pretext task를 제안한 것이다.
pretext task로 표현을 배운 뒤, 실제로 풀고 싶은 진짜 과제(예: 질병 예측, 소득 분류)를 downstream task라고 한다. “상류(pretext)에서 배운 걸 하류(downstream)에서 쓴다”는 흐름의 비유.
1.3 Encoder
인코더 $e: \mathcal{X} \to \mathcal{Z}$ 는 입력 $x$를 받아 표현 $z = e(x)$ 를 뽑아내는 신경망이다. VIME에서 자기지도 학습이 끝나고도 계속 재사용되는 부분이다. 나머지 추정기들은 표현을 잘 배우게 하기 위한 보조 장치이고, 학습이 끝나면 버린다.
1.4 Mask vector & Value imputation (마스크 벡터와 값 대체)
- Mask vector(마스크 벡터) $\mathbf{m}$: 어떤 특징을 오염시킬지 표시하는 0/1 벡터이다. $m_j = 1$이면 $j$번째 특징을 오염(교체), $m_j = 0$이면 원본 유지.
- Value imputation(값 대체): 오염하기로 한 자리에 새 값을 채워 넣는 것. 원래 “imputation”은 통계학에서 결측값을 그럴듯한 값으로 메우는 것을 뜻하기도 한다.
2. VIME의 원리
VIME은 자기지도 학습(1단계) 으로 좋은 인코더를 먼저 만든 뒤, 그 인코더를 준지도 학습(2단계) 에 재사용한다.
2.1 오염 샘플 만들기 (Value Imputation)
각 특징 자리마다 성공 확률이 $p_m$인 베르누이 시행(Bernoulli trial)을 한 번씩, 총 $d$번 진행한다.
\[\mathbf{m} = [m_1, \dots, m_d]^\top \in \{0,1\}^d\]그다음 마스크가 1인 자리는 오염값 $\bar{x}$로, 0인 자리는 원본 $x$로 채워 오염 샘플 $\tilde{x}$를 만듭니다($\odot$는 원소별 곱).
\[\tilde{\mathbf{x}} = g_m(\mathbf{x}, \mathbf{m}) = \mathbf{m} \odot \bar{\mathbf{x}} + (1 - \mathbf{m}) \odot \mathbf{x}\]여기서 오염값 $\bar{x}_j$는 그 열 $j$의 경험적 주변 분포 $\hat{p}_{X_j}$에서 뽑는다. –> $\tilde{x}$는 여전히 “실제 데이터처럼 생긴, 그럴듯한” 샘플이 된다.
2.2 두 개의 pretext task
오염된 $\tilde{x}$를 인코더가 출력한 표현 $z = e(\tilde{x})$를 받아 두 개의 추정기가 각자 과제를 푼다.
- 1. Mask vector estimation(마스크 벡터 추정): VIME의 새로운 pretext task. 추정기 $s_m: \mathcal{Z} \to [0,1]^d$ 가 어느 자리가 오염되었는지를 예측한다. 즉 마스크 $\mathbf{m}$을 복원한다.
- 2. Feature vector estimation(특징 벡터 추정): 기존 오토인코더식 복원 과제. 추정기 $s_r: \mathcal{Z} \to \mathcal{X}$ 가 오염되기 전 원본 값은 무엇이었는지 예측. 즉 원본 $\mathbf{x}$를 복원하려고 한다.
두 추정기와 인코더를 함께 학습시킨다.
\[\min_{e,\, s_m,\, s_r} \;\; \mathbb{E}_{\mathbf{x} \sim p_X,\; \mathbf{m} \sim p_m,\; \tilde{\mathbf{x}} \sim g_m(\mathbf{x},\mathbf{m})} \Big[\, l_m(\mathbf{m}, \hat{\mathbf{m}}) + \alpha \cdot l_r(\mathbf{x}, \hat{\mathbf{x}}) \,\Big]\]여기서 $\hat{\mathbf{m}} = (s_m \circ e)(\tilde{\mathbf{x}})$, $\hat{\mathbf{x}} = (s_r \circ e)(\tilde{\mathbf{x}})$ 이며, $\alpha$는 두 손실의 균형을 맞추는 하이퍼파라미터이다.
마스크 추정 손실 $l_m$ 은 mask vector 각 차원에 대한 binary cross-entropy의 평균이다.
\[l_m(\mathbf{m}, \hat{\mathbf{m}}) = -\frac{1}{d}\sum_{j=1}^{d} \Big[\, m_j \log \hat{m}_j + (1 - m_j)\log\!\left(1 - \hat{m}_j\right) \Big]\]복원 손실 $l_r$은 연속형 특징에 대한 MSE이다. (범주형 특징은 cross-entropy loss로 대체함.)
\[l_r(\mathbf{x}, \hat{\mathbf{x}}) = \frac{1}{d}\sum_{j=1}^{d}\left(x_j - \hat{x}_j\right)^2\]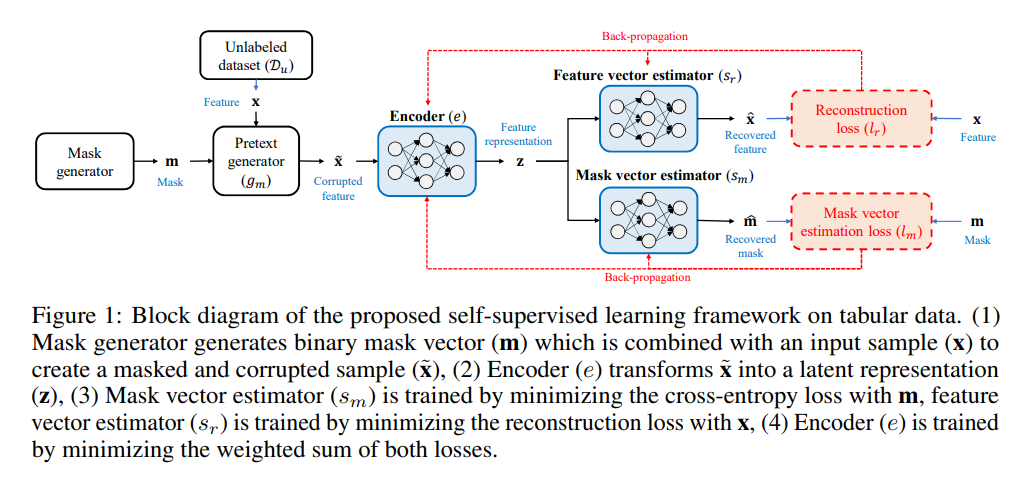
2.3 인코더는 무엇을 배우는가?
두 과제를 잘 풀려면 인코더는 반드시 특징들 사이의 상관관계(correlation) 를 포착해야 한다.
- $s_m$(마스크 추정): 어떤 특징 값이 주변의 상관된 특징들과 어긋나 있으면, 그 자리는 오염됐을 가능성이 높다고 판단할 수 있다.
- $s_r$(복원): 오염되지 않고 남아 있는 상관된 특징들로부터 오염된 자리의 원래 값을 추론.
즉 두 과제 모두 “특징 간 상관 구조를 알아야” 풀리도록 설계되어, 인코더가 그 구조를 표현 $z$에 담게 된다. 이미지의 공간적 상관, 언어의 앞뒤 단어 상관을 배우는 것과 같은 원리를, 상관 구조가 명시적이지 않은 표 데이터에 이식한 것이 VIME의 핵심이다.
2.4 준지도 학습
이제 학습된 인코더 $e$를 freeze 하고, 그 위에 예측기 $f$를 추가한다.
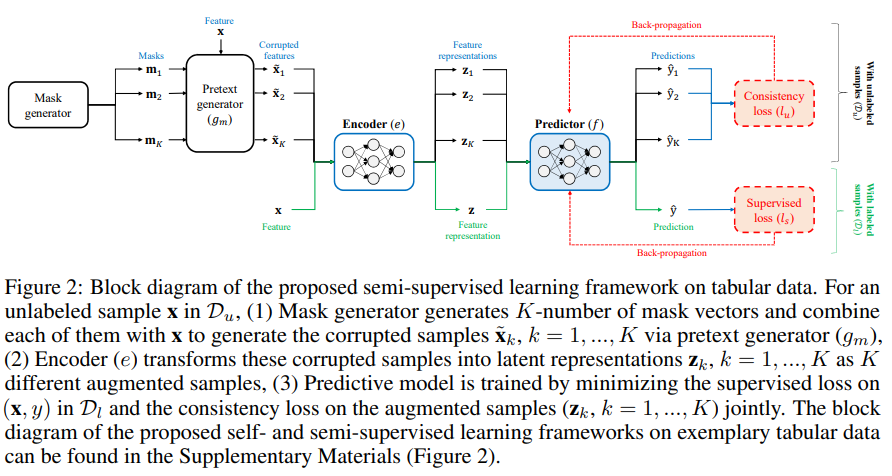
$f_e = f \circ e$, $\hat{y} = f_e(x)$ 로 두며, 최종 목적함수는 지도 손실과 비지도 손실의 합이다.
\[\mathcal{L}_{\text{final}} = \mathcal{L}_s + \beta \cdot \mathcal{L}_u\]지도 손실 $\mathcal{L}_s$: 라벨 있는 데이터로 계산하는 표준 손실. (mean squared error for regression or categorical cross-entropy for classification)
\[\mathcal{L}_s = \mathbb{E}_{(x,y)\sim p_{XY}}\big[\, l_s(y,\, f_e(x)) \,\big]\]비지도(일관성) 손실 $\mathcal{L}_u$: 라벨 없는 데이터로 계산. 같은 샘플 $x$와, 그것을 오염시킨 $\tilde{x}$에 대한 예측이 비슷해지도록 강제하는 것이다. (Consistency regularization)
\[\mathcal{L}_u = \mathbb{E}_{x \sim p_X,\; m \sim p_m,\; \tilde{x} \sim g_m(x,m)} \Big[\, \big\lVert f_e(\tilde{x}) - f_e(x) \big\rVert^2 \,\Big]\]$\mathcal{L}_u$가 강제하는 규칙은 “같은 데이터를 조금 오염시켜도, 모델의 예측은 흔들리면 안된다.”는 것이다.
수식을 다시 보면 두 예측의 차이를 제곱해서, 이걸 0에 가깝게(= 두 예측이 같게) 만들라는 것이다.
\[\mathcal{L}_u = \mathbb{E}\Big[\, \big\lVert \underbrace{f_e(\tilde{x})}_{\text{오염본 예측}} - \underbrace{f_e(x)}_{\text{원본 예측}} \big\rVert^2 \,\Big]\]데이터의 오염은 무작위로 진행된다. 그래서 오염본을 딱 1개만 만들면, 극단적인 오염이 걸리거나 원본과 거의 같게 되는 경우가 생길 수 있다.
그래서 실제로는 한 샘플 $x$마다 오염본을 $K$개 만들어($\tilde{x}_1, \dots, \tilde{x}_K$) 그 예측들의 흩어짐을 평균을 낸다. “이 샘플을 여러 방식으로 흔들어봤을 때, 예측이 얼마나 널뛰나(분산)” 를 재는 것이고, 그 널뜀을 줄이라는 것이다.
\[\hat{\mathcal{L}}_u = \frac{1}{N_b K}\sum_{i=1}^{N_b}\sum_{k=1}^{K} \big\lVert f(z_{i,k}) - f(z_i) \big\rVert^2\]여기서 $N_b$는 배치 크기, $z_{i,k} = e(\tilde{x}_{i,k})$, $z_i = e(x_i)$ 이다. 내부합 $\sum_k$가 예측들의 평균, 외부합 $\sum_i$가 배치 내 샘플들에 대한 평균이다.
또한 이 일관성 손실의 “변형(오염)”은 1단계 자기지도 학습으로 얻은 인코더를 통과한 오염이다.
- 1단계: 오염을 만들어 “어디가 오염됐나 / 원본이 뭐였나”를 풀며 인코더를 학습
- 2단계: 똑같은 오염 방식을 이번엔 “흔들어도 예측이 같아야 한다”는 일관성 신호로 재사용
같은 오염 도구를 두 단계에서 다른 목적으로 두 번 사용하는 구조이다.
3. 실험 결과
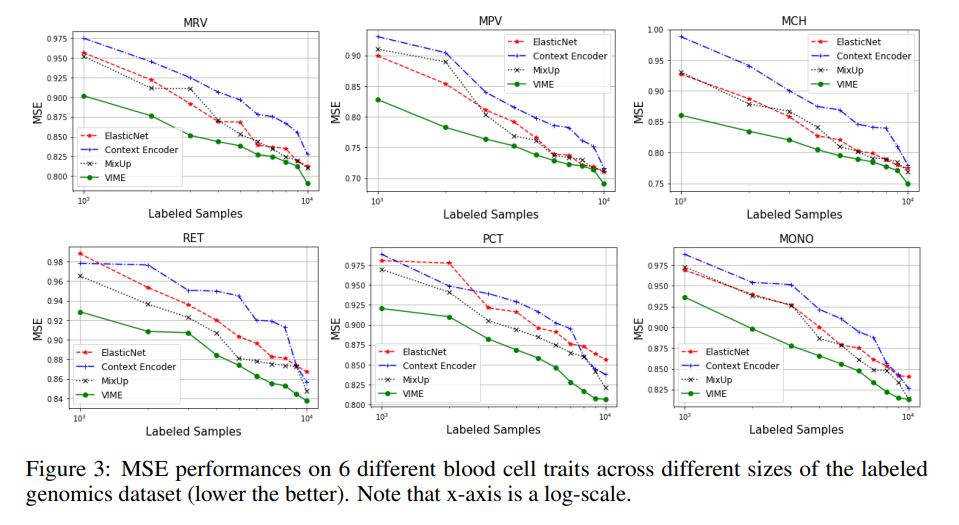
Genomics data: VIME이 지도(ElasticNet)·자기지도(Context Encoder)·준지도(MixUp) 모두를 앞섰고, 많은 경우 라벨을 절반만 쓰고도 다른 기법과 비슷한 성능을 보임.
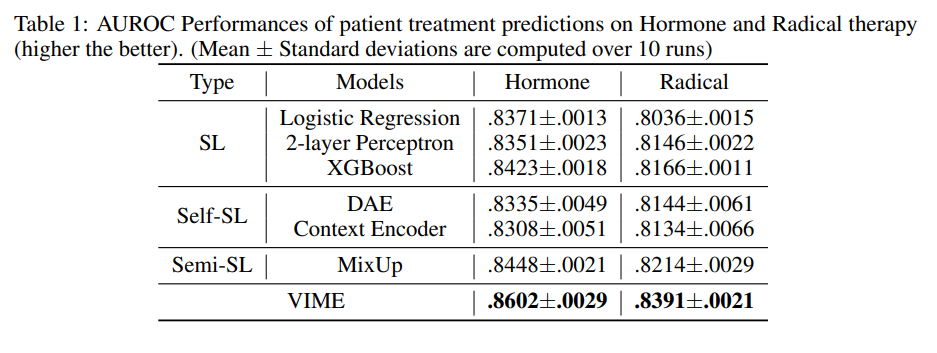
Clinical data: 두 가지 치료 예측(호르몬 요법/근치 요법)에서 VIME이 최고 AUROC를 기록.
Public tabular data: 라벨 10% / 비라벨 90% 세팅에서 VIME이 도메인에 관계없이 최고 정확도를 보임.
4. SCARF와의 비교
| 항목 | VIME | SCARF |
|---|---|---|
| 자기지도 손실 | 복원 + 마스크 추정 | 대조 학습 (InfoNCE) |
| pretext task | “어디가 오염됐나 + 원본이 뭐였나” 복원 | “같은 원본에서 나온 두 view 짝짓기” |
| 오염 방식 | 각 열의 경험적 주변 분포에서 교체 (동일) | 각 열의 경험적 주변 분포에서 교체 (동일) |
| 미세조정 범위 | 인코더 고정, 예측기만 학습 | 인코더 포함 전체 미세조정 |
| 준지도 요소 | 있음 (일관성 손실 $\mathcal{L}_u$) | 없음 (순수 사전학습→미세조정) |
핵심 차이는 “오염을 어떻게 활용하느냐” 이다. VIME은 오염을 복원, 마스크 추정 과제의 재료로 쓰고, SCARF는 같은 오염을 대조 학습의 view 생성에 사용한다. SCARF 논문은 이 대조 방식이 VIME의 복원 방식보다 효과적이라고 보고했다.